Double DQN

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Double Q-learning

  • Q-learning przeszacowuje wartości Q, obniżając efektywność uczenia
  • Przyczyną jest błąd maksymalizacji
  • Double Q-Learning eliminuje błąd przez rozdzielenie wyboru akcji i estymacji wartości
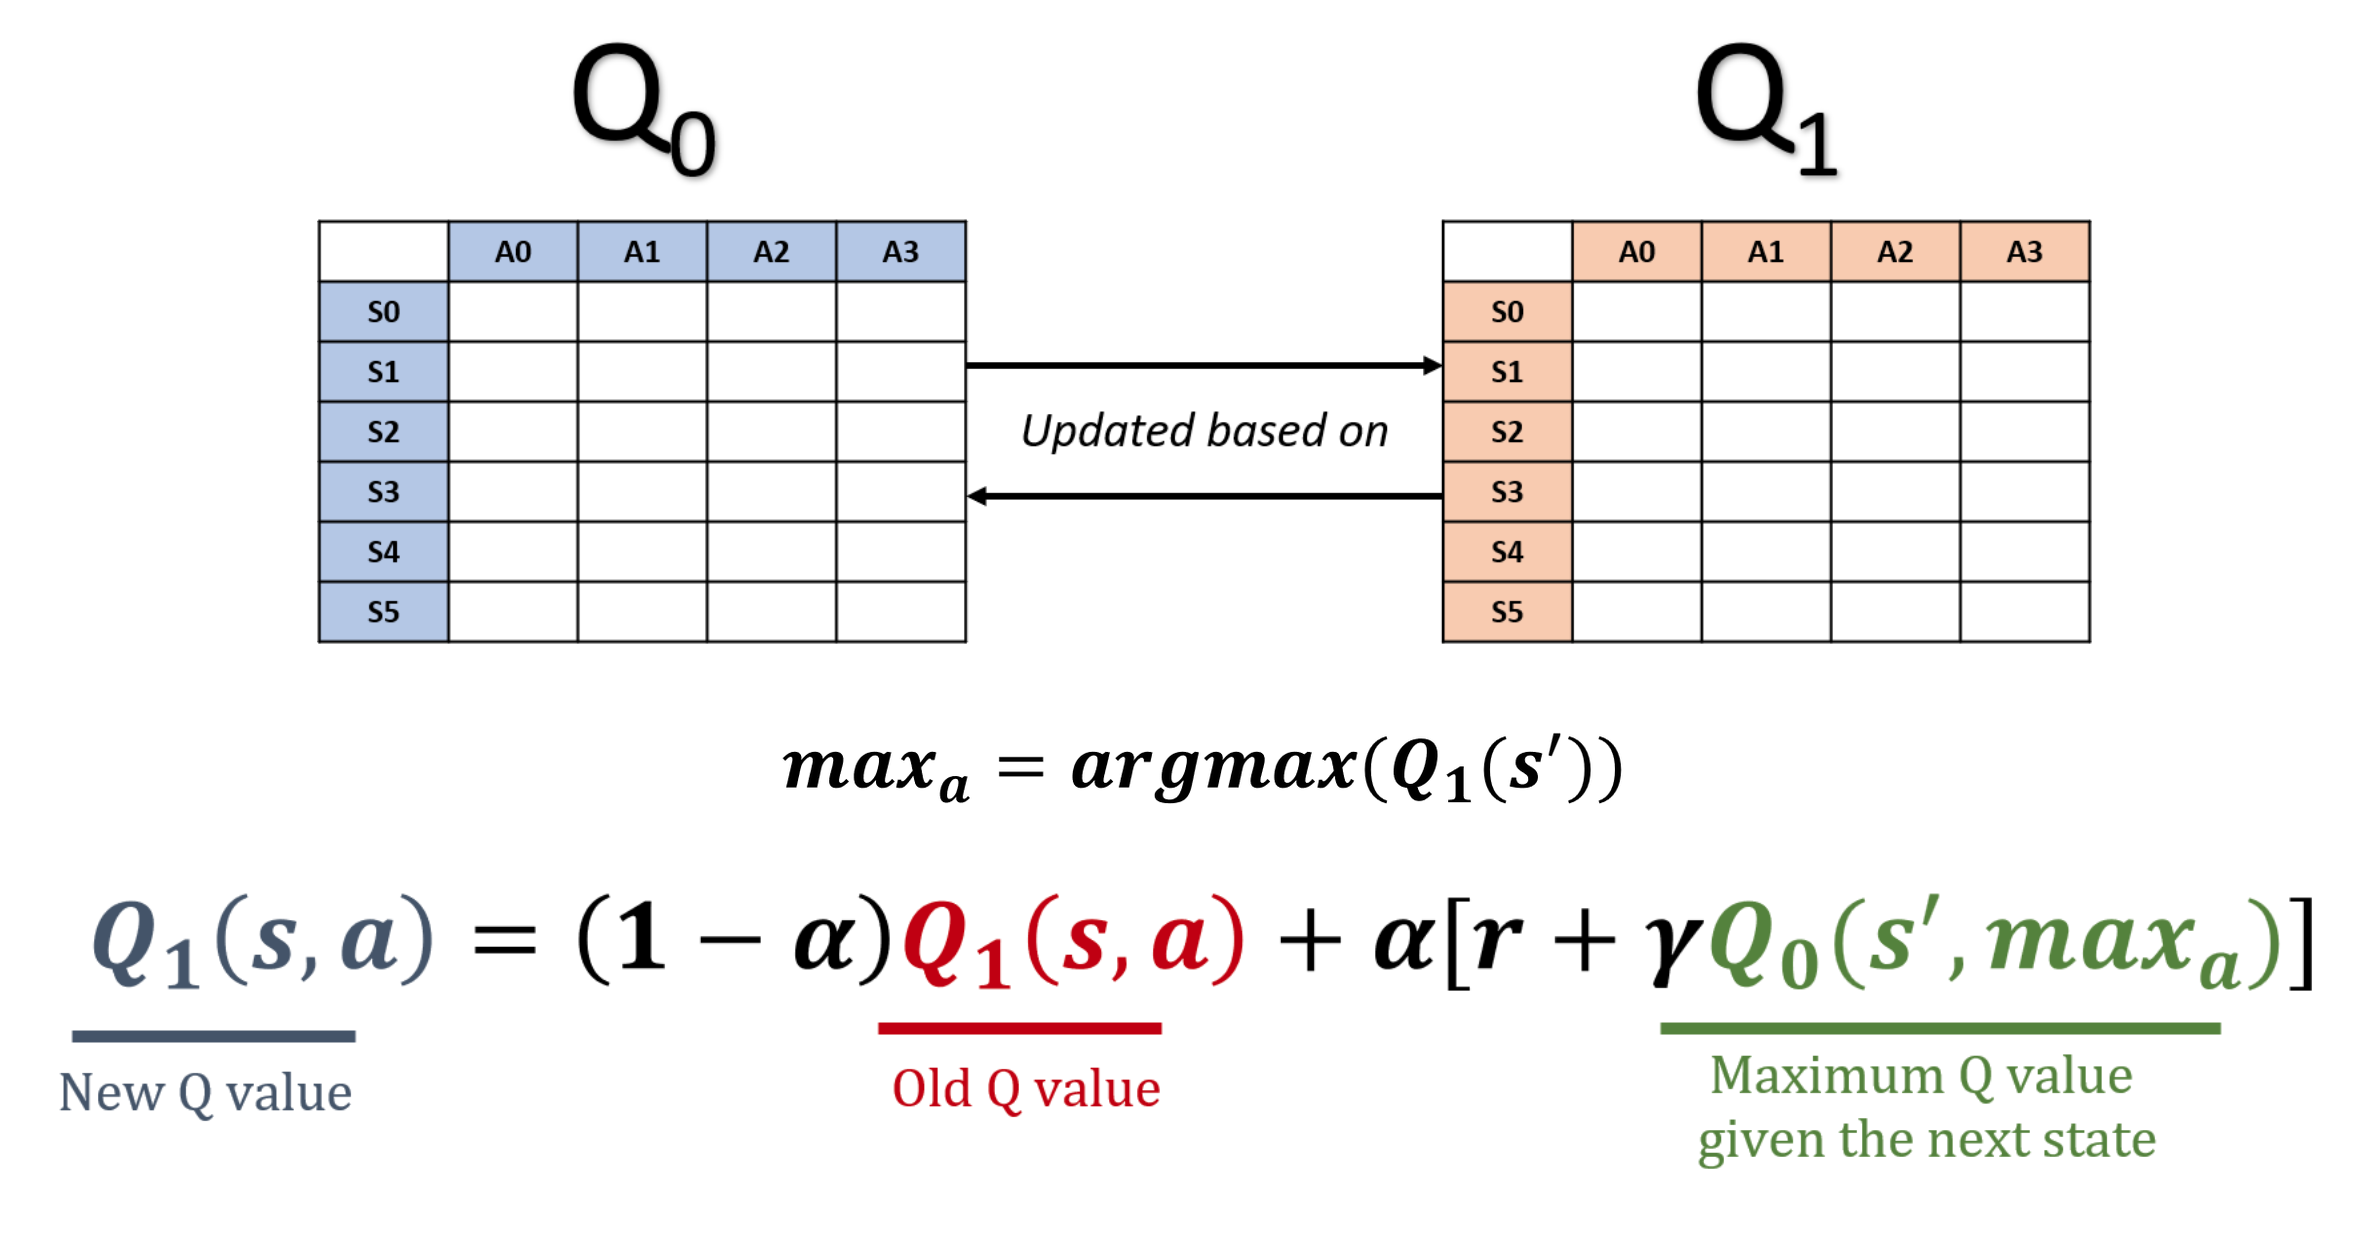
Dwie tablice Q (ilustracja z kursu Reinforcement Learning with Gymnasium using Python); double Q-learning korzysta z nich naprzemiennie

Głębokie uczenie ze wzmocnieniem w Pythonie

Idea DDQN

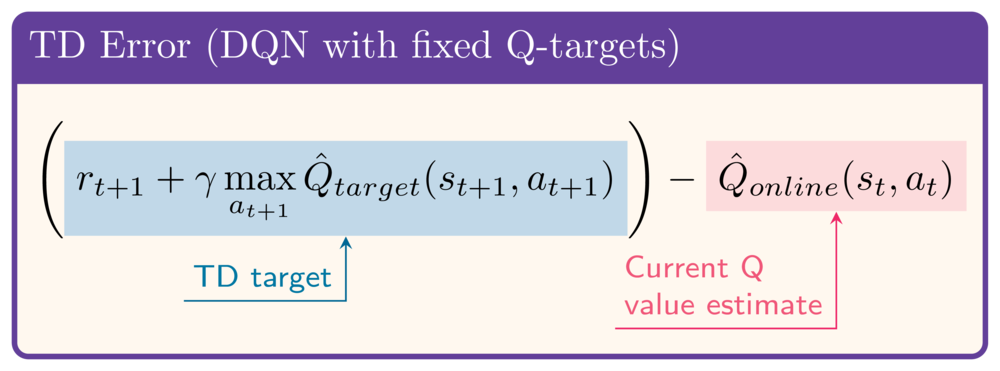
  • Punkt wyjścia: kompletny DQN (ze stałymi Q-targetami)
  • Cel TD w DQN:
    • Wybór akcji: sieć docelowa
    • Estymacja wartości: sieć docelowa
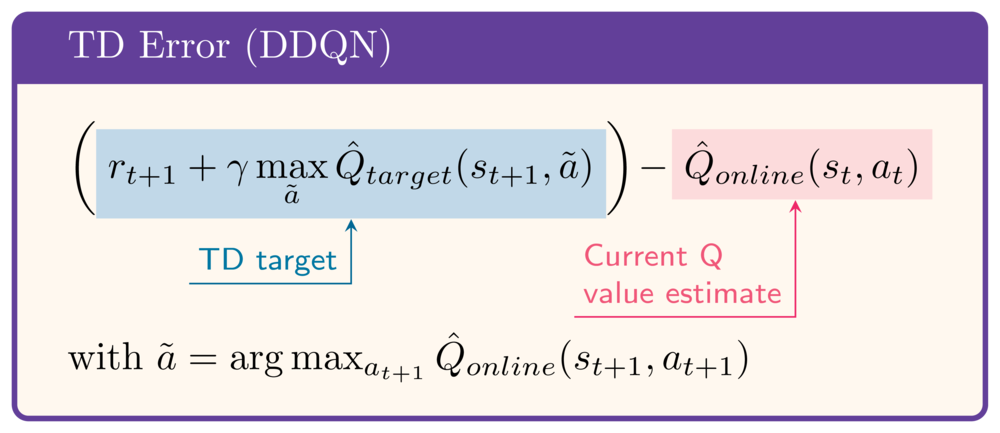
  • Cel TD w DDQN:
    • Wybór akcji: sieć online
    • Estymacja wartości: sieć docelowa
  • Nie jest to dokładnie double Q-learning (brak naprzemiennych sieci Q)
  • Większość korzyści przy minimalnej zmianie

Błąd Bellmana (DQN ze stałymi Q-targetami): Q_online(s_t, a_t) - (r_t+1 + gamma max(Q_target(s_t+1, a)))

Błąd Bellmana (DDQN ze stałymi Q-targetami): Q_online(s_t, a_t) - (r_t+1 + gamma Q_target(s_t+1, tilde a)) gdzie tilde a = argmax_a(Q_online(s_t+1, a))

Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja Double DQN

DQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
# # next_q_values = (target_network(next_states) .amax(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():

target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja Double DQN

DQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (target_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (online_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Głębokie uczenie ze wzmocnieniem w Pythonie

Wydajność DDQN


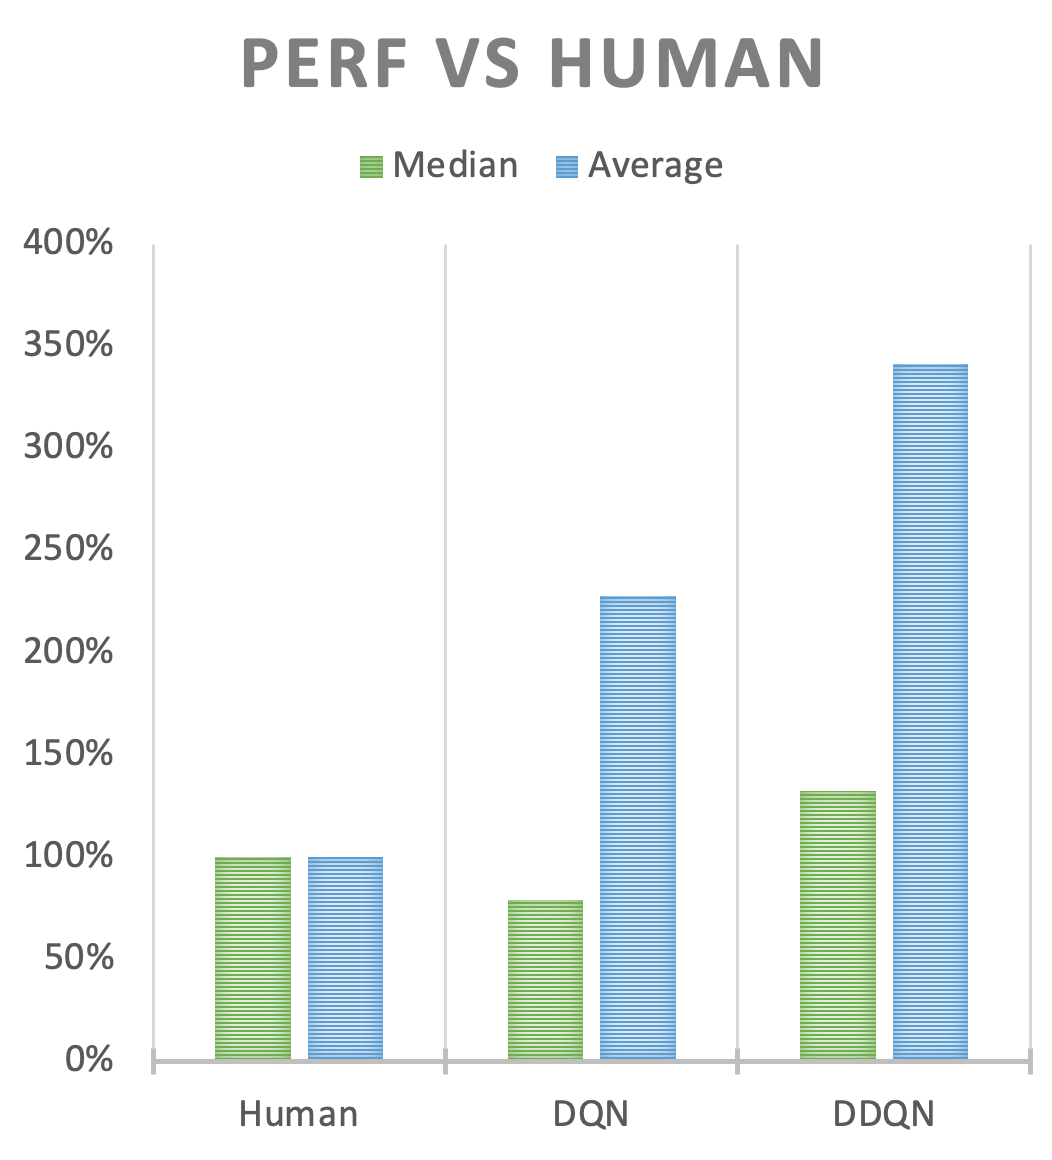
  • Porównanie wyników DDQN, DQN i graczy w grach Atari
  • DDQN: wyższe wyniki niż oryginalne DQN
  • Nie zawsze prawdziwe -> warto przetestować oba

Wykres słupkowy: DQN zbliżone do wyników człowieka dla mediany gier i ponadludzkie wyniki średnio; DDQN przewyższa zarówno człowieka, jak i DQN dla mediany i średniej.

1 https://arxiv.org/abs/2303.11634
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...