Advantage Actor Critic

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Dlaczego Actor Critic?
 

  • Ograniczenia REINFORCE:

    • Wysoka wariancja
    • Niska efektywność próbkowania
  • Metody Actor Critic wprowadzają sieć krytyka, umożliwiając uczenie Temporal Difference

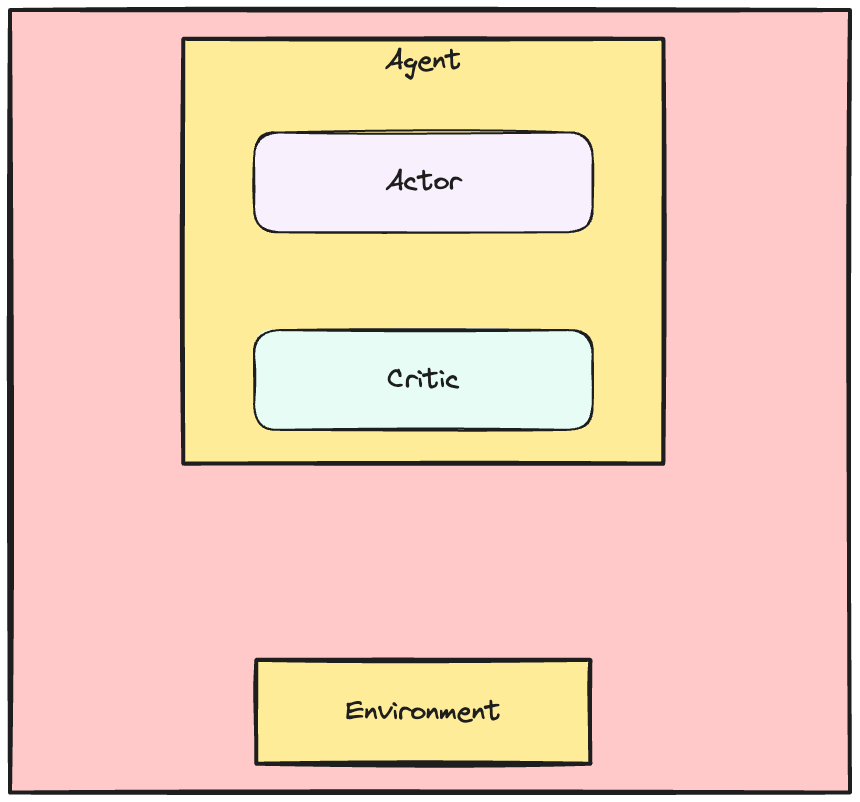
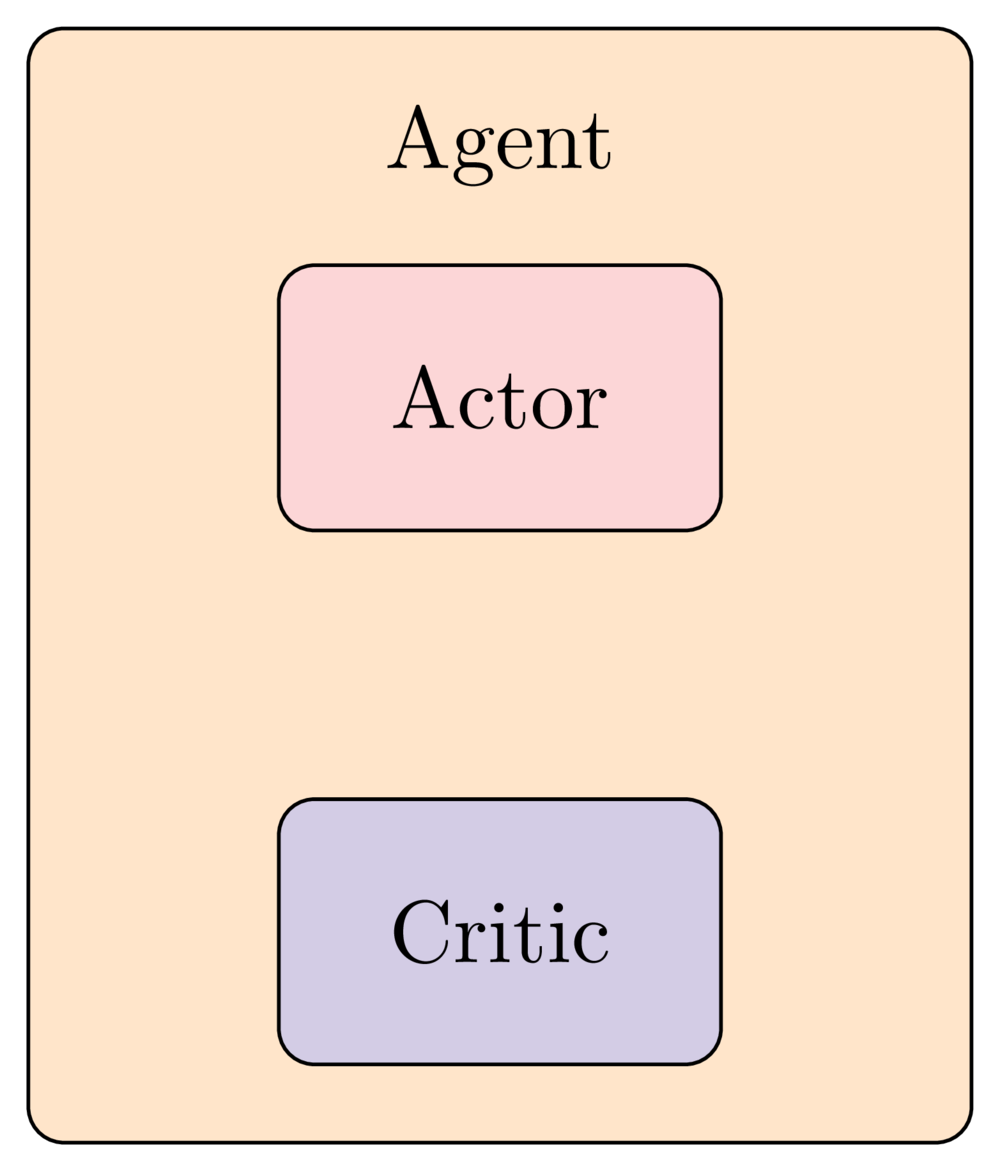
Duży prostokąt oznaczony 'agent'; wewnątrz dwa mniejsze prostokąty oznaczone odpowiednio 'actor' i 'critic'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Intuicja za metodami Actor Critic

Studenci rozmawiający przy stole, z książkami i długopisami.


  • Sieć aktora:

    • Podejmuje decyzje
    • Nie ocenia ich
  • Sieć krytyka:

    • Dostarcza aktorowi informacji zwrotnej na każdym kroku
Głębokie uczenie ze wzmocnieniem w Pythonie

Sieć krytyka


  • Krytyk aproksymuje funkcję wartości stanu
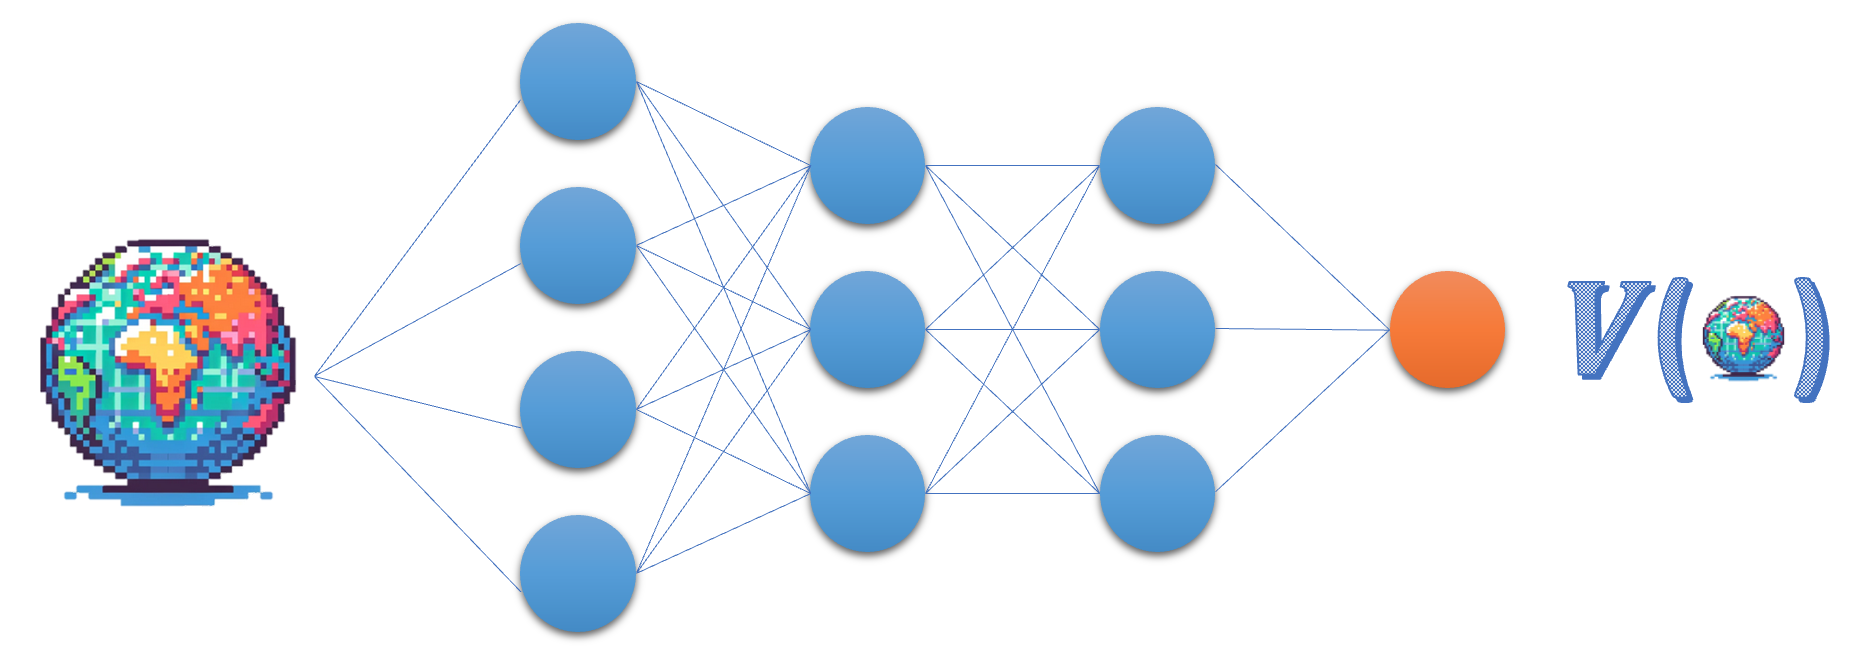
Reprezentacja sieci krytyka: stan jako wejście, funkcja wartości jako wyjście; sieć ma jeden węzeł wyjściowy.

  • Ocenia akcję $a_t$ na podstawie przewagi lub błędu TD


class Critic(nn.Module):
    def __init__(self, state_size):
        super(Critic, self).__init__()
        self.fc1 = nn.Linear(state_size, 64)
        self.fc2 = nn.Linear(64, 1)

def forward(self, state): x = torch.relu(self.fc1(torch.tensor(state))) value = self.fc2(x) return value
critic_network = Critic(8)
Głębokie uczenie ze wzmocnieniem w Pythonie

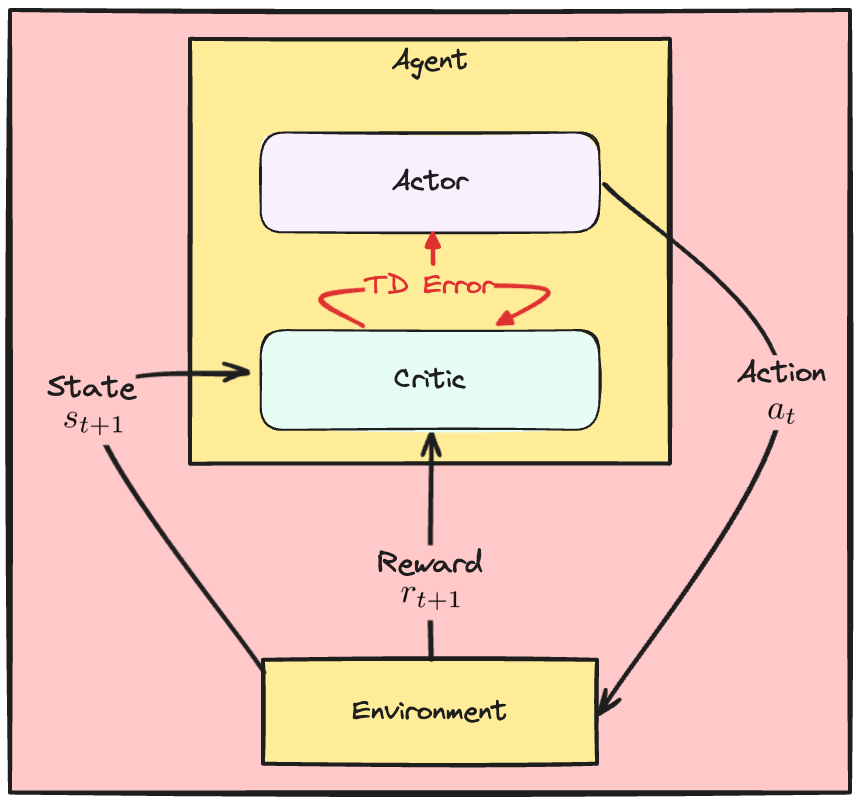
Dynamika Actor Critic


  • Na każdym kroku:
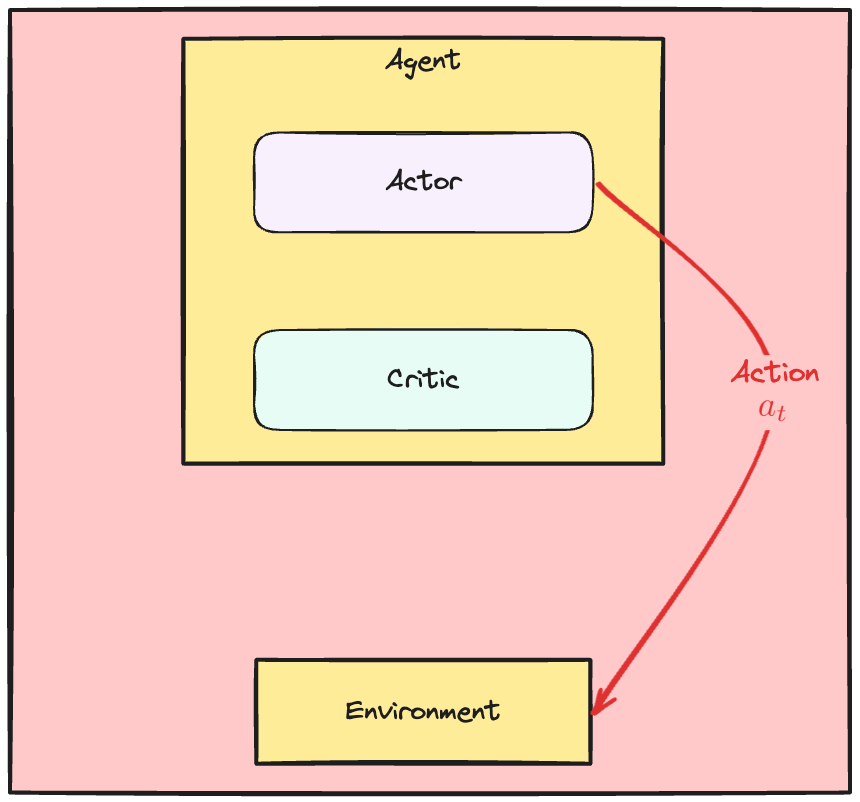
    • Aktor wybiera akcję (tak jak sieć polityki w REINFORCE)

Na górze: duży prostokąt oznaczony 'agent'; wewnątrz dwa mniejsze prostokąty oznaczone odpowiednio 'actor' i 'critic'. Na dole: osobny prostokąt oznaczony 'environment'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Dynamika Actor Critic


  • Na każdym kroku:
    • Aktor wybiera akcję (tak jak sieć polityki w REINFORCE)
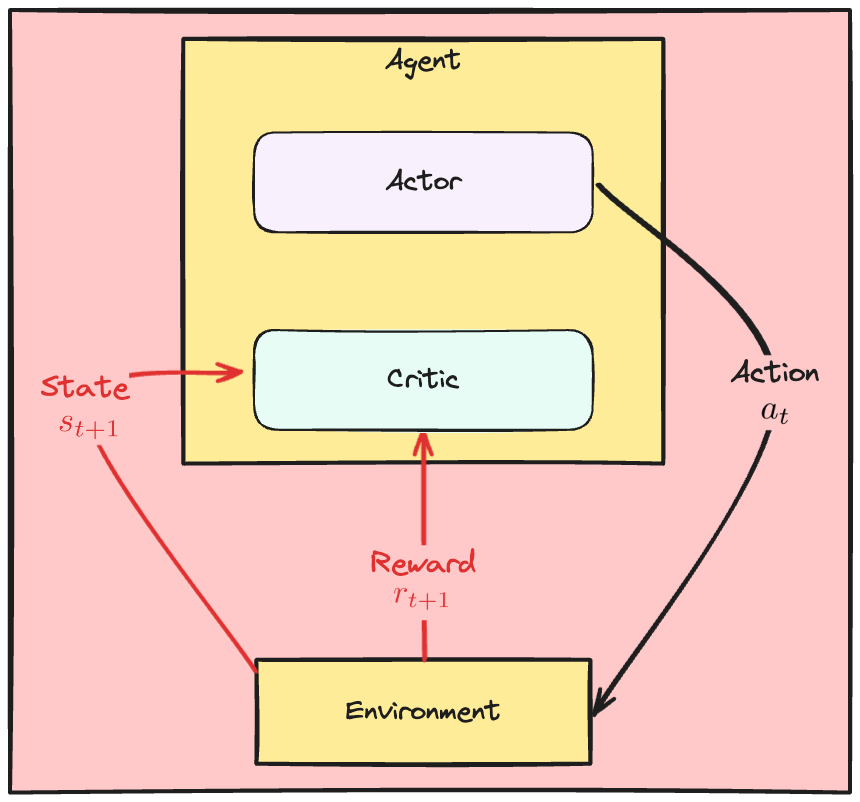
    • Krytyk obserwuje nagrodę i stan

Czerwona strzałka oznaczona 'action' prowadzi od aktora do środowiska.

Głębokie uczenie ze wzmocnieniem w Pythonie

Dynamika Actor Critic


  • Na każdym kroku:
    • Aktor wybiera akcję (tak jak sieć polityki w REINFORCE)
    • Krytyk obserwuje nagrodę i stan
    • Krytyk oblicza błąd TD
    • Aktor i krytyk aktualizują wagi na podstawie błędu TD

Dwie czerwone strzałki, oznaczone odpowiednio 'State' i 'Reward', prowadzą ze środowiska do krytyka.

Głębokie uczenie ze wzmocnieniem w Pythonie

Dynamika Actor Critic


  • Na każdym kroku:
    • Aktor wybiera akcję (tak jak sieć polityki w REINFORCE)
    • Krytyk obserwuje nagrodę i stan
    • Krytyk oblicza błąd TD
    • Aktor i krytyk aktualizują wagi na podstawie błędu TD
    • Zaktualizowany aktor obserwuje nowy stan

Strzałka oznaczona 'TD error' prowadzi od krytyka do aktora.

Głębokie uczenie ze wzmocnieniem w Pythonie

Dynamika Actor Critic


  • Na każdym kroku:
    • Aktor wybiera akcję (tak jak sieć polityki w REINFORCE)
    • Krytyk obserwuje nagrodę i stan
    • Krytyk oblicza błąd TD
    • Aktor i krytyk aktualizują wagi na podstawie błędu TD
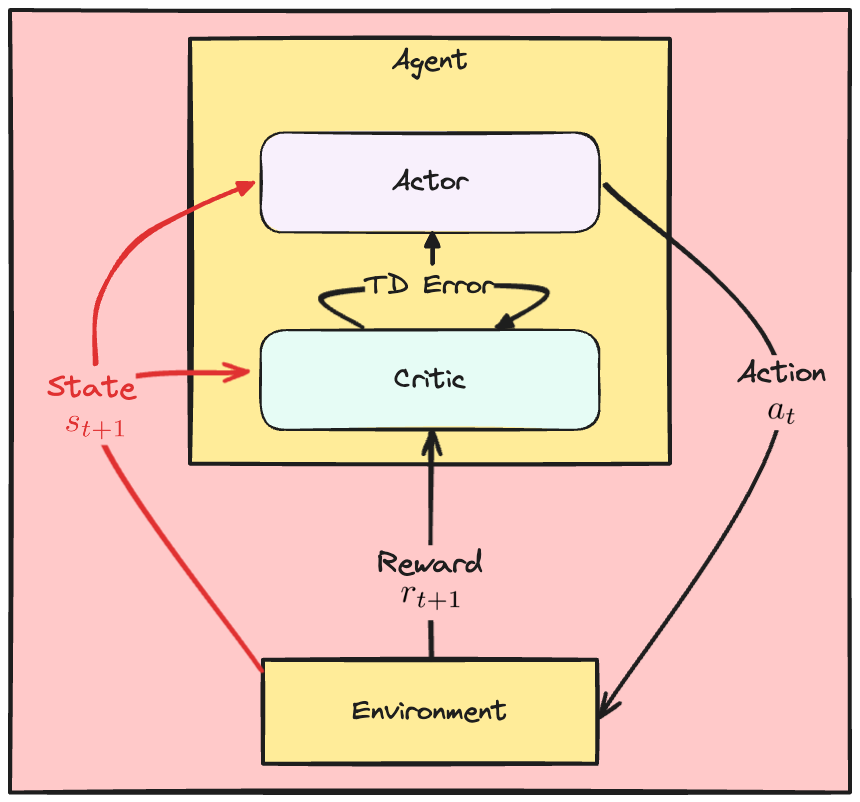
    • Zaktualizowany aktor obserwuje nowy stan
  • ... i tak od początku

Strzałka State prowadzi teraz również do aktora.

Głębokie uczenie ze wzmocnieniem w Pythonie

Straty A2C


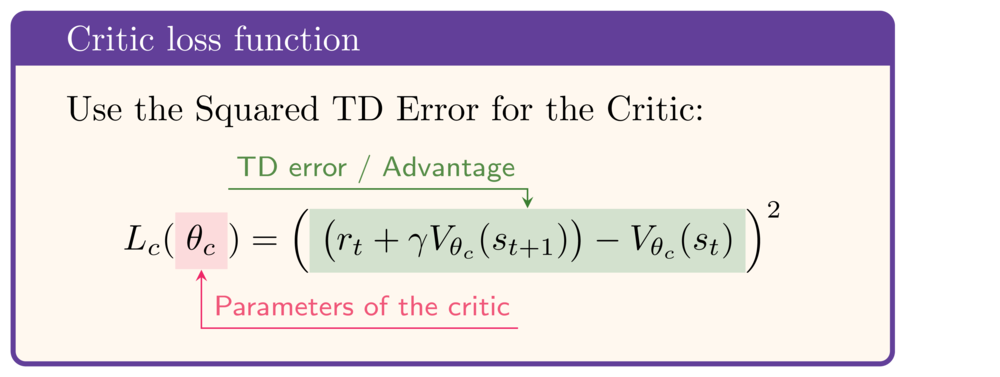
Krytyk

Funkcja straty krytyka. Używa kwadratowego błędu TD: Lc(theta c) = ((r_t + gamma * V theta c (s t + 1)) - V theta c) do kwadratu

  • Strata krytyka: kwadratowy błąd TD


Aktor
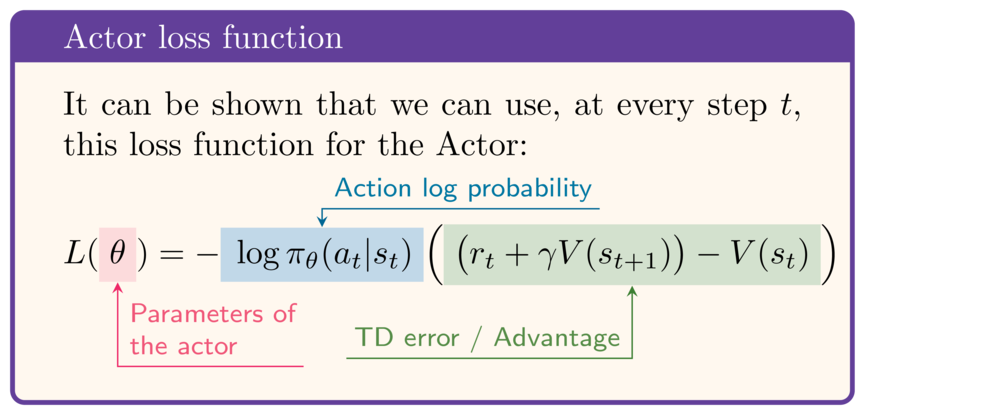
Funkcja straty aktora. Na każdym kroku t stosowana jest następująca funkcja straty: L(theta) równa się minus logarytm prawdopodobieństwa akcji pomnożony przez błąd TD lub przewagę.

  • Błąd TD odzwierciedla ocenę krytyka
  • Zwiększa prawdopodobieństwo akcji z dodatnim błędem TD
Głębokie uczenie ze wzmocnieniem w Pythonie

Obliczanie strat


def calculate_losses(critic_network, action_log_prob, 
                     reward, state, next_state, done):

# Critic provides the state value estimates value = critic_network(state)
next_value = critic_network(next_state)
td_target = (reward + gamma * next_value * (1-done))
td_error = td_target - value
# Apply formulas for actor and critic losses actor_loss = -action_log_prob * td_error.detach()
critic_loss = td_error ** 2
return actor_loss, critic_loss


  • Oblicz błąd TD
  • Oblicz stratę aktora
    • Użyj .detach(), aby zatrzymać propagację gradientu do wag krytyka
  • Oblicz stratę krytyka
Głębokie uczenie ze wzmocnieniem w Pythonie

Pętla treningowa Actor Critic

for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:

# Select action action, action_log_prob = select_action(actor, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
# Calculate losses actor_loss, critic_loss = calculate_losses(critic, action_log_prob, reward, state, next_state, done)
# Update actor actor_optimizer.zero_grad(); actor_loss.backward(); actor_optimizer.step()
# Update critic critic_optimizer.zero_grad(); critic_loss.backward(); critic_optimizer.step()
state = next_state
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...