Wprowadzenie do głębokiego uczenia ze wzmocnieniem

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Dlaczego głębokie uczenie ze wzmocnieniem
 

  • Tradycyjne RL sprawdza się w zadaniach niskwymiarowych


  • Wiele zastosowań ma wysoko-wymiarową przestrzeń stanów i/lub akcji


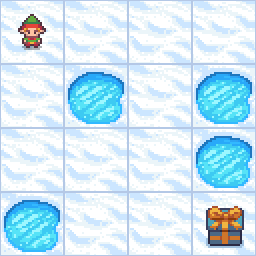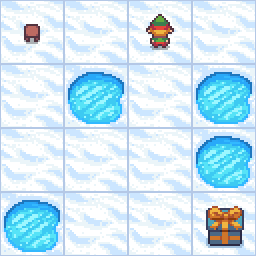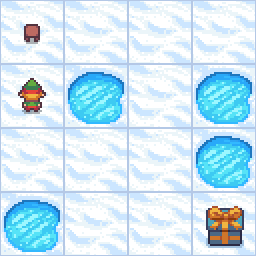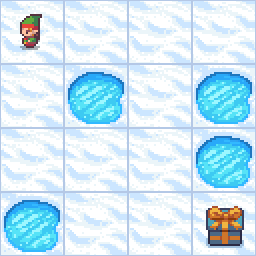
Agent eksplorujący środowisko Frozen Lake

Agent grający w klasyczną grę wideo Space Invaders

Głębokie uczenie ze wzmocnieniem w Pythonie

Składniki DRL


  1. Pojęcia z uczenia ze wzmocnieniem
  2. Głębokie uczenie i PyTorch


  • DRL łączy te koncepcje z głębokimi sieciami neuronowymi


Pikselowa ilustracja kucharza mieszającego składniki

Głębokie uczenie ze wzmocnieniem w Pythonie

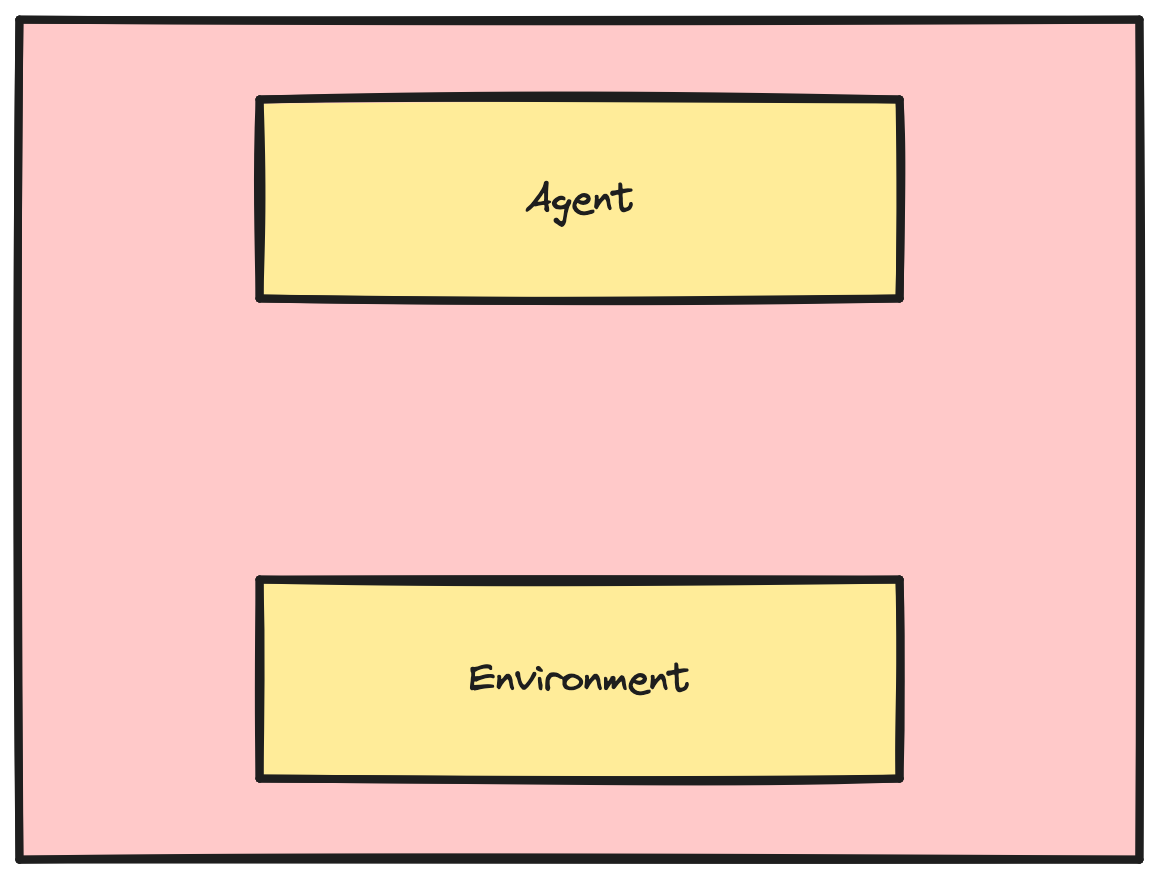
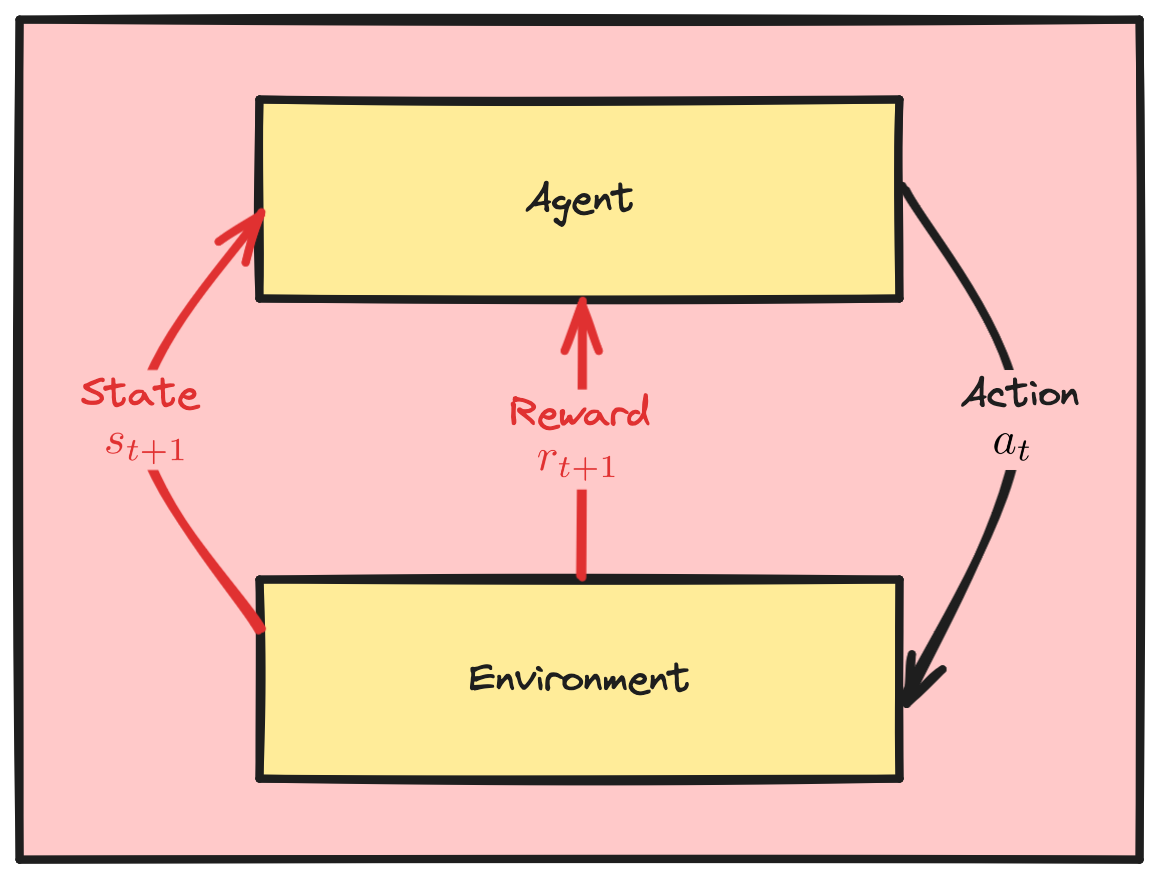
Środowisko RL


  • Krok t:


Duże pole z dwoma mniejszymi polami wewnątrz, oznaczonymi 'Agent' i 'Environment'

Głębokie uczenie ze wzmocnieniem w Pythonie

Środowisko RL


  • Krok t:
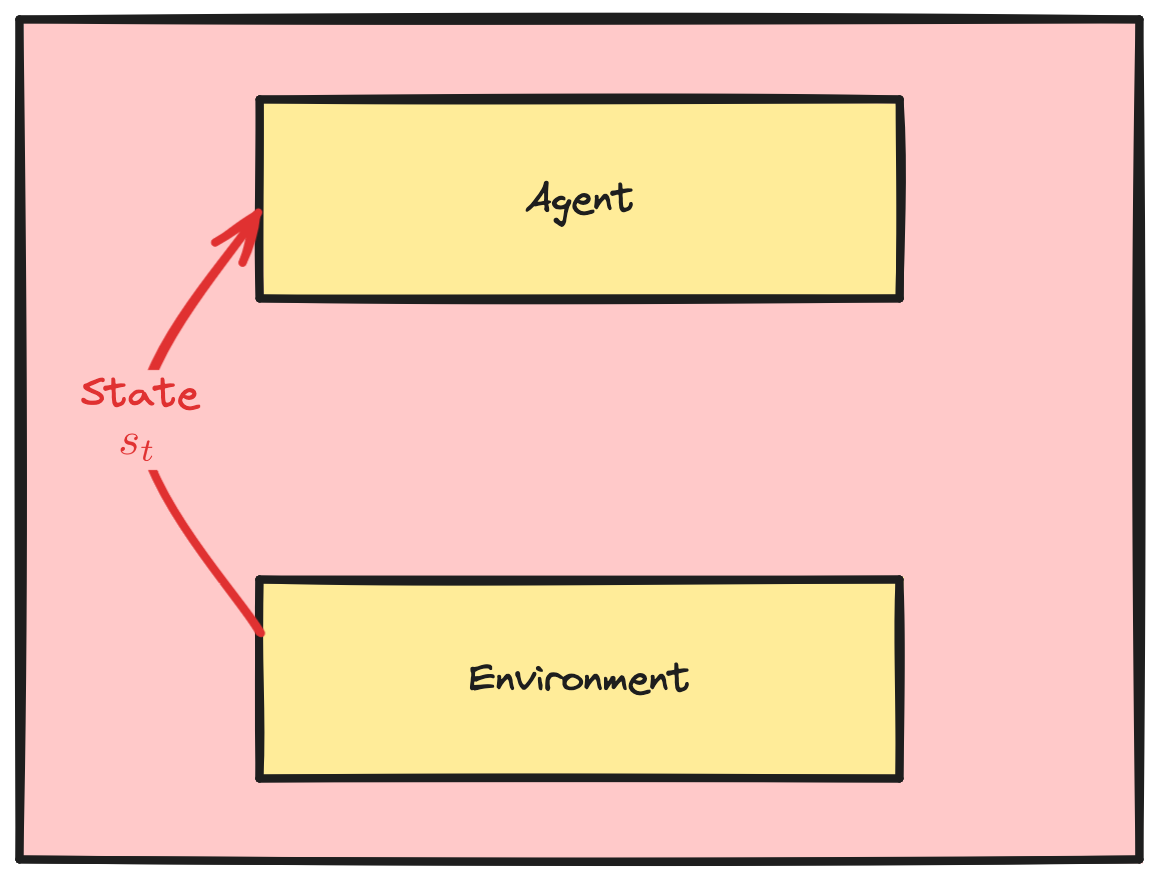
    • Agent obserwuje stan $s_t$


Czerwona strzałka z etykietą Stan s_t prowadzi od środowiska do agenta.

Głębokie uczenie ze wzmocnieniem w Pythonie

Środowisko RL


  • Krok t:
    • Agent obserwuje stan $s_t$
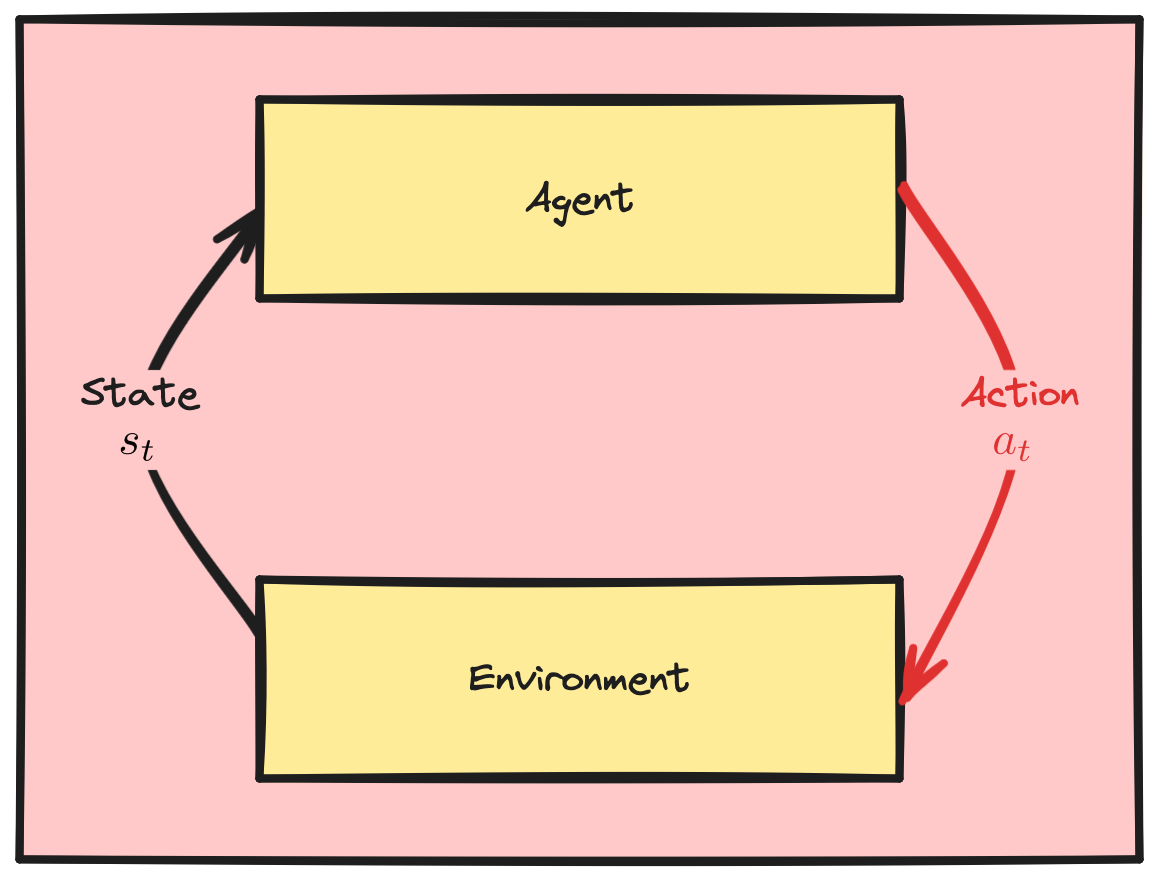
    • Agent podejmuje akcję $a_t$


Czerwona strzałka z etykietą akcja a_t prowadzi od agenta do środowiska. Strzałka stanu jest teraz czarna.

Głębokie uczenie ze wzmocnieniem w Pythonie

Środowisko RL


  • Krok t:
    • Agent obserwuje stan $s_t$
    • Agent podejmuje akcję $a_t$
  • Krok t+1:
    • Środowisko zwraca nagrodę $r_t$
    • Stan przechodzi do $s_{t+1}$


Strzałka stanu s_t zmienia etykietę na stan s_t+1 i jest ponownie czerwona. Nowa czerwona strzałka z etykietą nagroda r_t+1 prowadzi od środowiska do agenta. Strzałka akcji jest teraz czarna.

Głębokie uczenie ze wzmocnieniem w Pythonie

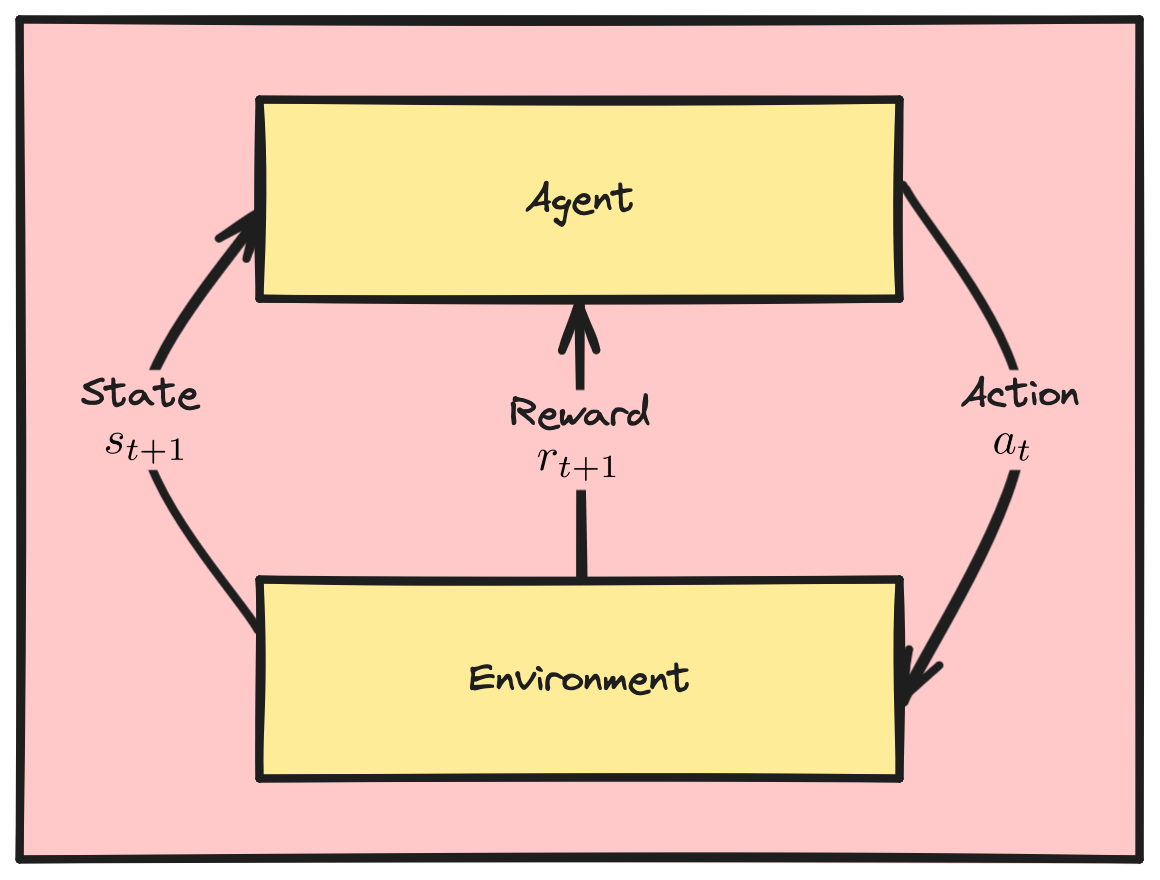
Środowisko RL


  • Krok t:
    • Agent obserwuje stan $s_t$
    • Agent podejmuje akcję $a_t$
  • Krok t+1:
    • Środowisko zwraca nagrodę $r_t$
    • Stan przechodzi do $s_{t+1}$
  • Powtarzaj aż do zakończenia epizodu


Ten sam obraz co na poprzednim slajdzie, ale wszystkie strzałki są czarne.

Głębokie uczenie ze wzmocnieniem w Pythonie

Polityka $\pi(s_t)$


  • Odwzorowanie ze stanu na akcję, opisujące zachowanie agenta w danym stanie $s_t$


  • Deterministyczna:
    • Zwraca wybraną akcję
  • Stochastyczna:
    • Zwraca rozkład nad akcjami
    • Polityka jest rozkładem prawdopodobieństwa nad możliwymi akcjami
Głębokie uczenie ze wzmocnieniem w Pythonie

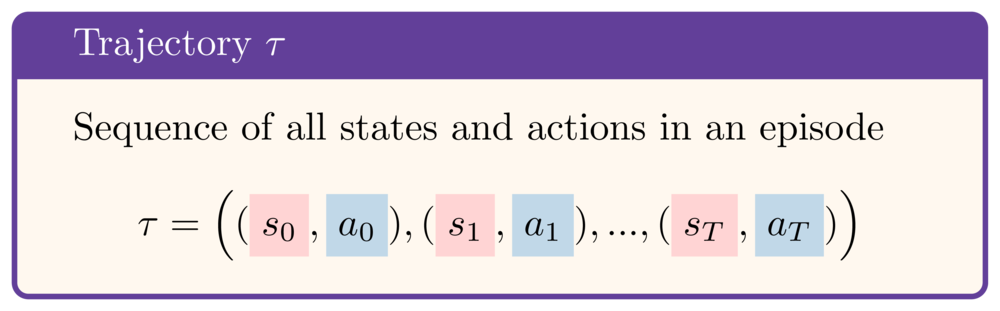
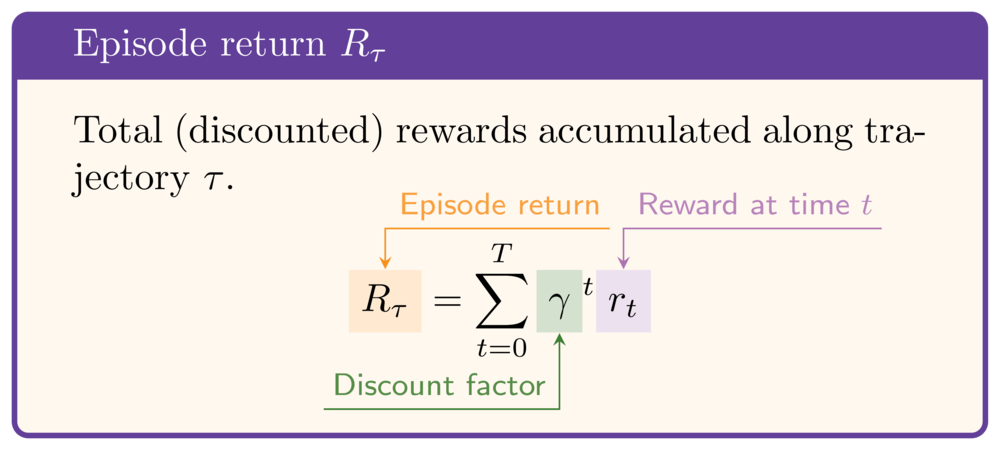
Trajektoria i zwrot epizodu


Trajektoria tau: sekwencja wszystkich stanów i akcji w epizodzie; tau = ((s0, a0), (s1, a1), ... (sT, aT))


Zwrot epizodu Rtau: łączne (zdyskontowane) nagrody zebrane wzdłuż trajektorii tau. Rtau = suma po t z gamma do potęgi t razy r_t

Głębokie uczenie ze wzmocnieniem w Pythonie

Konfiguracja środowiska

env = gym.make("ALE/SpaceInvaders-v5")

# Define neural network architecture class Network(nn.Module): def __init__(self, dim_inputs, dim_outputs): super(Network, self).__init__() self.linear = nn.Linear(dim_inputs, dim_outputs) def forward(self, x): return self.linear(x)
# Instantiate network network = Network(dim_inputs, dim_outputs)
# Instantiate optimizer optimizer = optim.Adam(network.parameters(), lr=0.0001)
Głębokie uczenie ze wzmocnieniem w Pythonie

Podstawowa pętla

for episode in range(1000):
  state, info = env.reset()
  done = False

while not done:
action = select_action(network, state)
next_state, reward, terminated, truncated, _ = ( env.step(action)) done = terminated or truncated
loss = calculate_loss(network, state, action, next_state, reward, done) optimizer.zero_grad() loss.backward() optimizer.step()
state = next_state


  • Pętla zewnętrzna: iteracja po epizodach
  • Pętla wewnętrzna: iteracja po krokach
    • Wybór akcji
    • Obserwacja nowego stanu i nagrody
    • Obliczenie straty i aktualizacja sieci
    • Aktualizacja stanu
  • (Strata?)
Głębokie uczenie ze wzmocnieniem w Pythonie

Co dalej


  • DRL jest potężny!
  • Podejścia oparte na wartości i na polityce
  • DQN i jego udoskonalenia
  • Metody gradientu polityki

Uczący się DataCamp nurkuje głęboko w morze, odkrywając tajemnice głębokiego uczenia ze wzmocnieniem

Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...