Gradient polityki i REINFORCE

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Różnice w stosunku do DQN
  • REINFORCE: Monte Carlo, nie Temporal Difference
    • Aktualizacja na końcu epizodu, nie w każdym kroku
    • Możliwa aktualizacja po kilku epizodach
  • Brak funkcji wartości
  • Brak sieci docelowej
  • Brak strategii epsilon-zachłannej
  • Brak powtórki doświadczeń

Obrazy przedstawiające: funkcję wartości akcji Q, powtórkę doświadczeń, strategię epsilon-zachłanną oraz stałe cele Q — ułożone jedna na drugiej i przekreślone

Głębokie uczenie ze wzmocnieniem w Pythonie

Struktura pętli treningowej REINFORCE


for episode in range(num_episodes):

# 1. Initialize episode
while not done:
# 2. Select action
# 3. Play action and obtain next state and reward
# 4. Add (discounted) reward to return
# 5. Update state
# 6. Calculate loss
# 7. Update policy network by gradient descent
Głębokie uczenie ze wzmocnieniem w Pythonie

Wybór akcji


from torch.distributions import Categorical

def select_action(policy_network, state):
  action_probs = policy_network(state)

action_dist = Categorical(action_probs)
action = action_dist.sample()
log_prob = action_dist.log_prob(action)
return action.item(), log_prob.reshape(1)
action, log_prob = select_action( policy_network, state)


  • Pobieranie prawdopodobieństw z sieci
  • Próbkowanie jednej akcji
  • Zwracanie akcji i odpowiadających logarytmów prawdopodobieństwa


Sampled action index: 1
Log probability of sampled action: -1.38
Głębokie uczenie ze wzmocnieniem w Pythonie

Obliczanie straty


Przypomnijmy twierdzenie o gradiencie polityki:
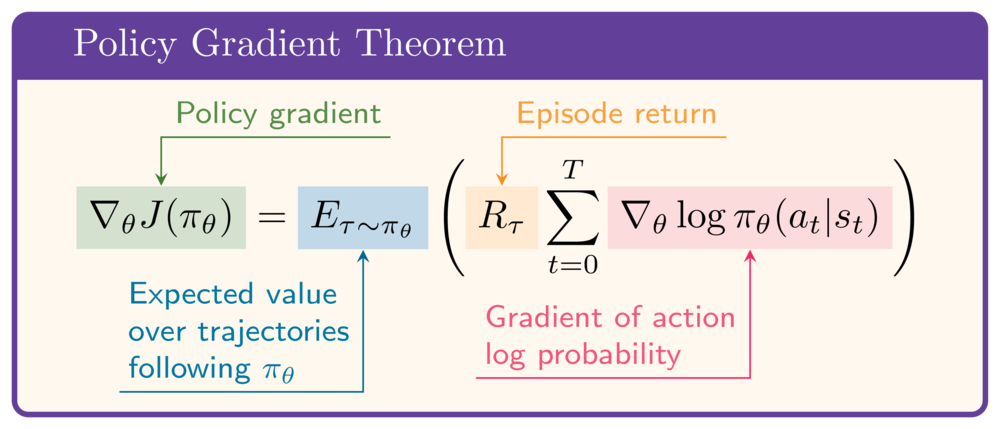
Twierdzenie o gradiencie polityki: gradient J(pi_theta) względem theta równa się wartości oczekiwanej po trajektoriach tau zgodnych z pi_theta iloczynu zwrotu z epizodu i sumy gradientów logarytmów prawdopodobieństw akcji, zsumowanej po wszystkich akcjach w trajektorii.

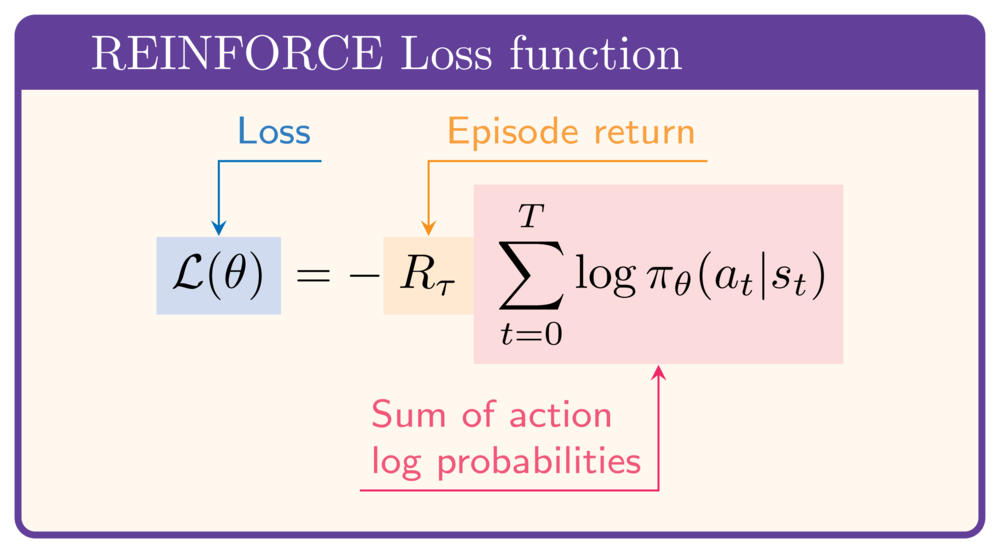
Funkcja straty REINFORCE dla epizodu: L(theta) równa się minus zwrot z epizodu razy suma logarytmów prawdopodobieństw akcji.

W Pythonie:

  • $R_{\tau}$ jako episode_return
  • Wektor $\log\pi_\theta(a_t|s_t)$ jako episode_log_probs
loss = -episode_return * episode_log_probs.sum()
Głębokie uczenie ze wzmocnieniem w Pythonie

Pętla treningowa REINFORCE

for episode in range(50):
  state, info = env.reset(); done = False; step = 0;
  episode_log_probs = torch.tensor([])

R = 0
while not done: step += 1 action, log_prob = select_action(policy_network, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
R += (gamma ** step) * reward
episode_log_probs = torch.cat((episode_log_probs, log_prob))
state = next_state
loss = - R * episode_log_probs.sum()
optimizer.zero_grad(); loss.backward(); optimizer.step()
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...