Bonus entropii i PPO

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Bonus entropii


  • Algorytmy gradientu polityki mogą degenerować się do polityk deterministycznych
  • Rozwiązanie: dodanie bonusu entropii
  • Entropia mierzy niepewność rozkładu!

Łazik marsjański zablokowany przez duży kamień leżący bezpośrednio przed nim.

Głębokie uczenie ze wzmocnieniem w Pythonie

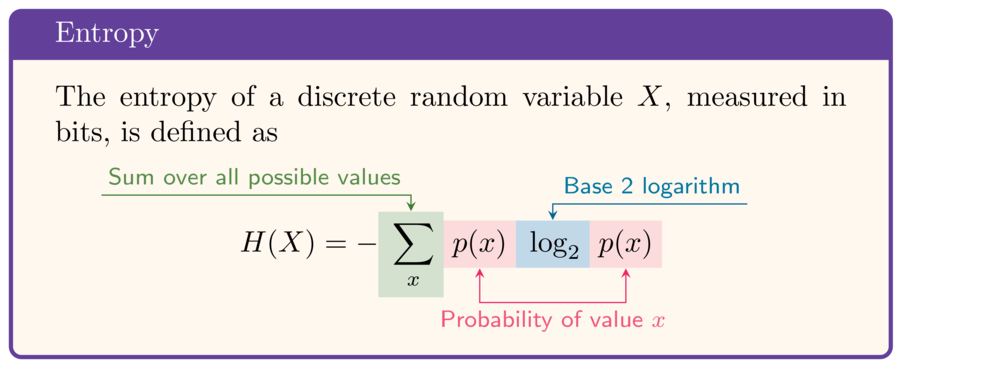
Entropia rozkładu prawdopodobieństwa


Entropia dyskretnej zmiennej losowej X, mierzona w bitach, zdefiniowana jako H(X) = - suma po wartościach x z p(x) log_2 p(x)

  • Jeśli $\ln$ zamiast $\log_2$: wynik w $natach$.
  • $1\ nat = \frac{1}{\ln 2}\ bit \approx 1.44 \ bit$
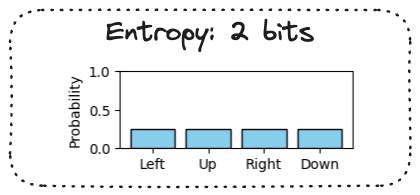
Pierwszy z trzech wykresów słupkowych przedstawiających różne polityki stochastyczne dla 4 akcji. Prawdopodobieństwo każdej akcji wynosi 0,25, co odpowiada entropii 2 bitów.

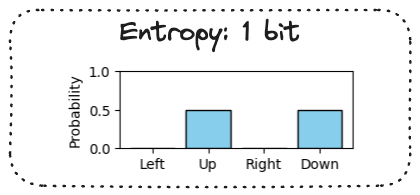
Drugi z trzech wykresów słupkowych przedstawiających różne polityki stochastyczne dla 4 akcji. Prawdopodobieństwo skupione równo na dwóch akcjach, 0 dla pozostałych; entropia 1 bit.

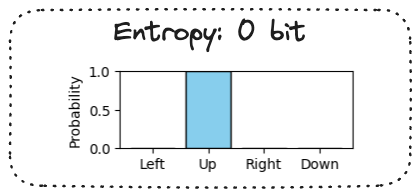
Trzeci z trzech wykresów słupkowych przedstawiających różne polityki stochastyczne dla 4 akcji. Całe prawdopodobieństwo skupione na jednej akcji z prawdopodobieństwem 1; entropia 0 bitów.

Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja bonusu entropii

def select_action(policy_network, state):
  action_probs = policy_network(state)
  action_dist = Categorical(action_probs)
  action = action_dist.sample()
  log_prob = action_dist.log_prob(action)

# Obtain the entropy of the policy entropy = action_dist.entropy()
return (action.item(), log_prob.reshape(1), entropy)
  • Strata aktora: actor_loss -= c_entropy * entropy
  • Uwaga: Categorical.entropy() jest w natach; podziel przez math.log(2), aby uzyskać bity
Głębokie uczenie ze wzmocnieniem w Pythonie

Pętla treningowa PPO

for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob, entropy = select_action(actor, state)
    next_state, reward, terminated, truncated, _ = env.step(action)
    done = terminated or truncated
    actor_loss, critic_loss = calculate_losses(critic, action_log_prob, action_log_prob,
                                               reward, state, next_state, done)
    actor_loss -= c_entropy * entropy
    actor_optimizer.zero_grad(); actor_loss.backward(); actor_optimizer.step()
    critic_optimizer.zero_grad(); critic_loss.backward(); critic_optimizer.step()
    state = next_state
Głębokie uczenie ze wzmocnieniem w Pythonie

PPO z aktualizacjami wsadowymi


  • Aktualizacja przy każdym kroku: niepełne wykorzystanie funkcji celu PPO
  • W każdym kroku $\theta$ pokrywa się z $\theta_{old}$.
  • Pełne implementacje PPO rozdzielają:
    • Aktualizacje parametrów (minibatche)
    • Aktualizacje polityki (rollout)
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...