Proksymalna optymalizacja polityki

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

A2C

  • Aktualizacje polityki A2C:
    • Oparte na niestabilnych estymacjach
    • Mogą być duże i niestabilne
  • Mogą pogarszać wydajność

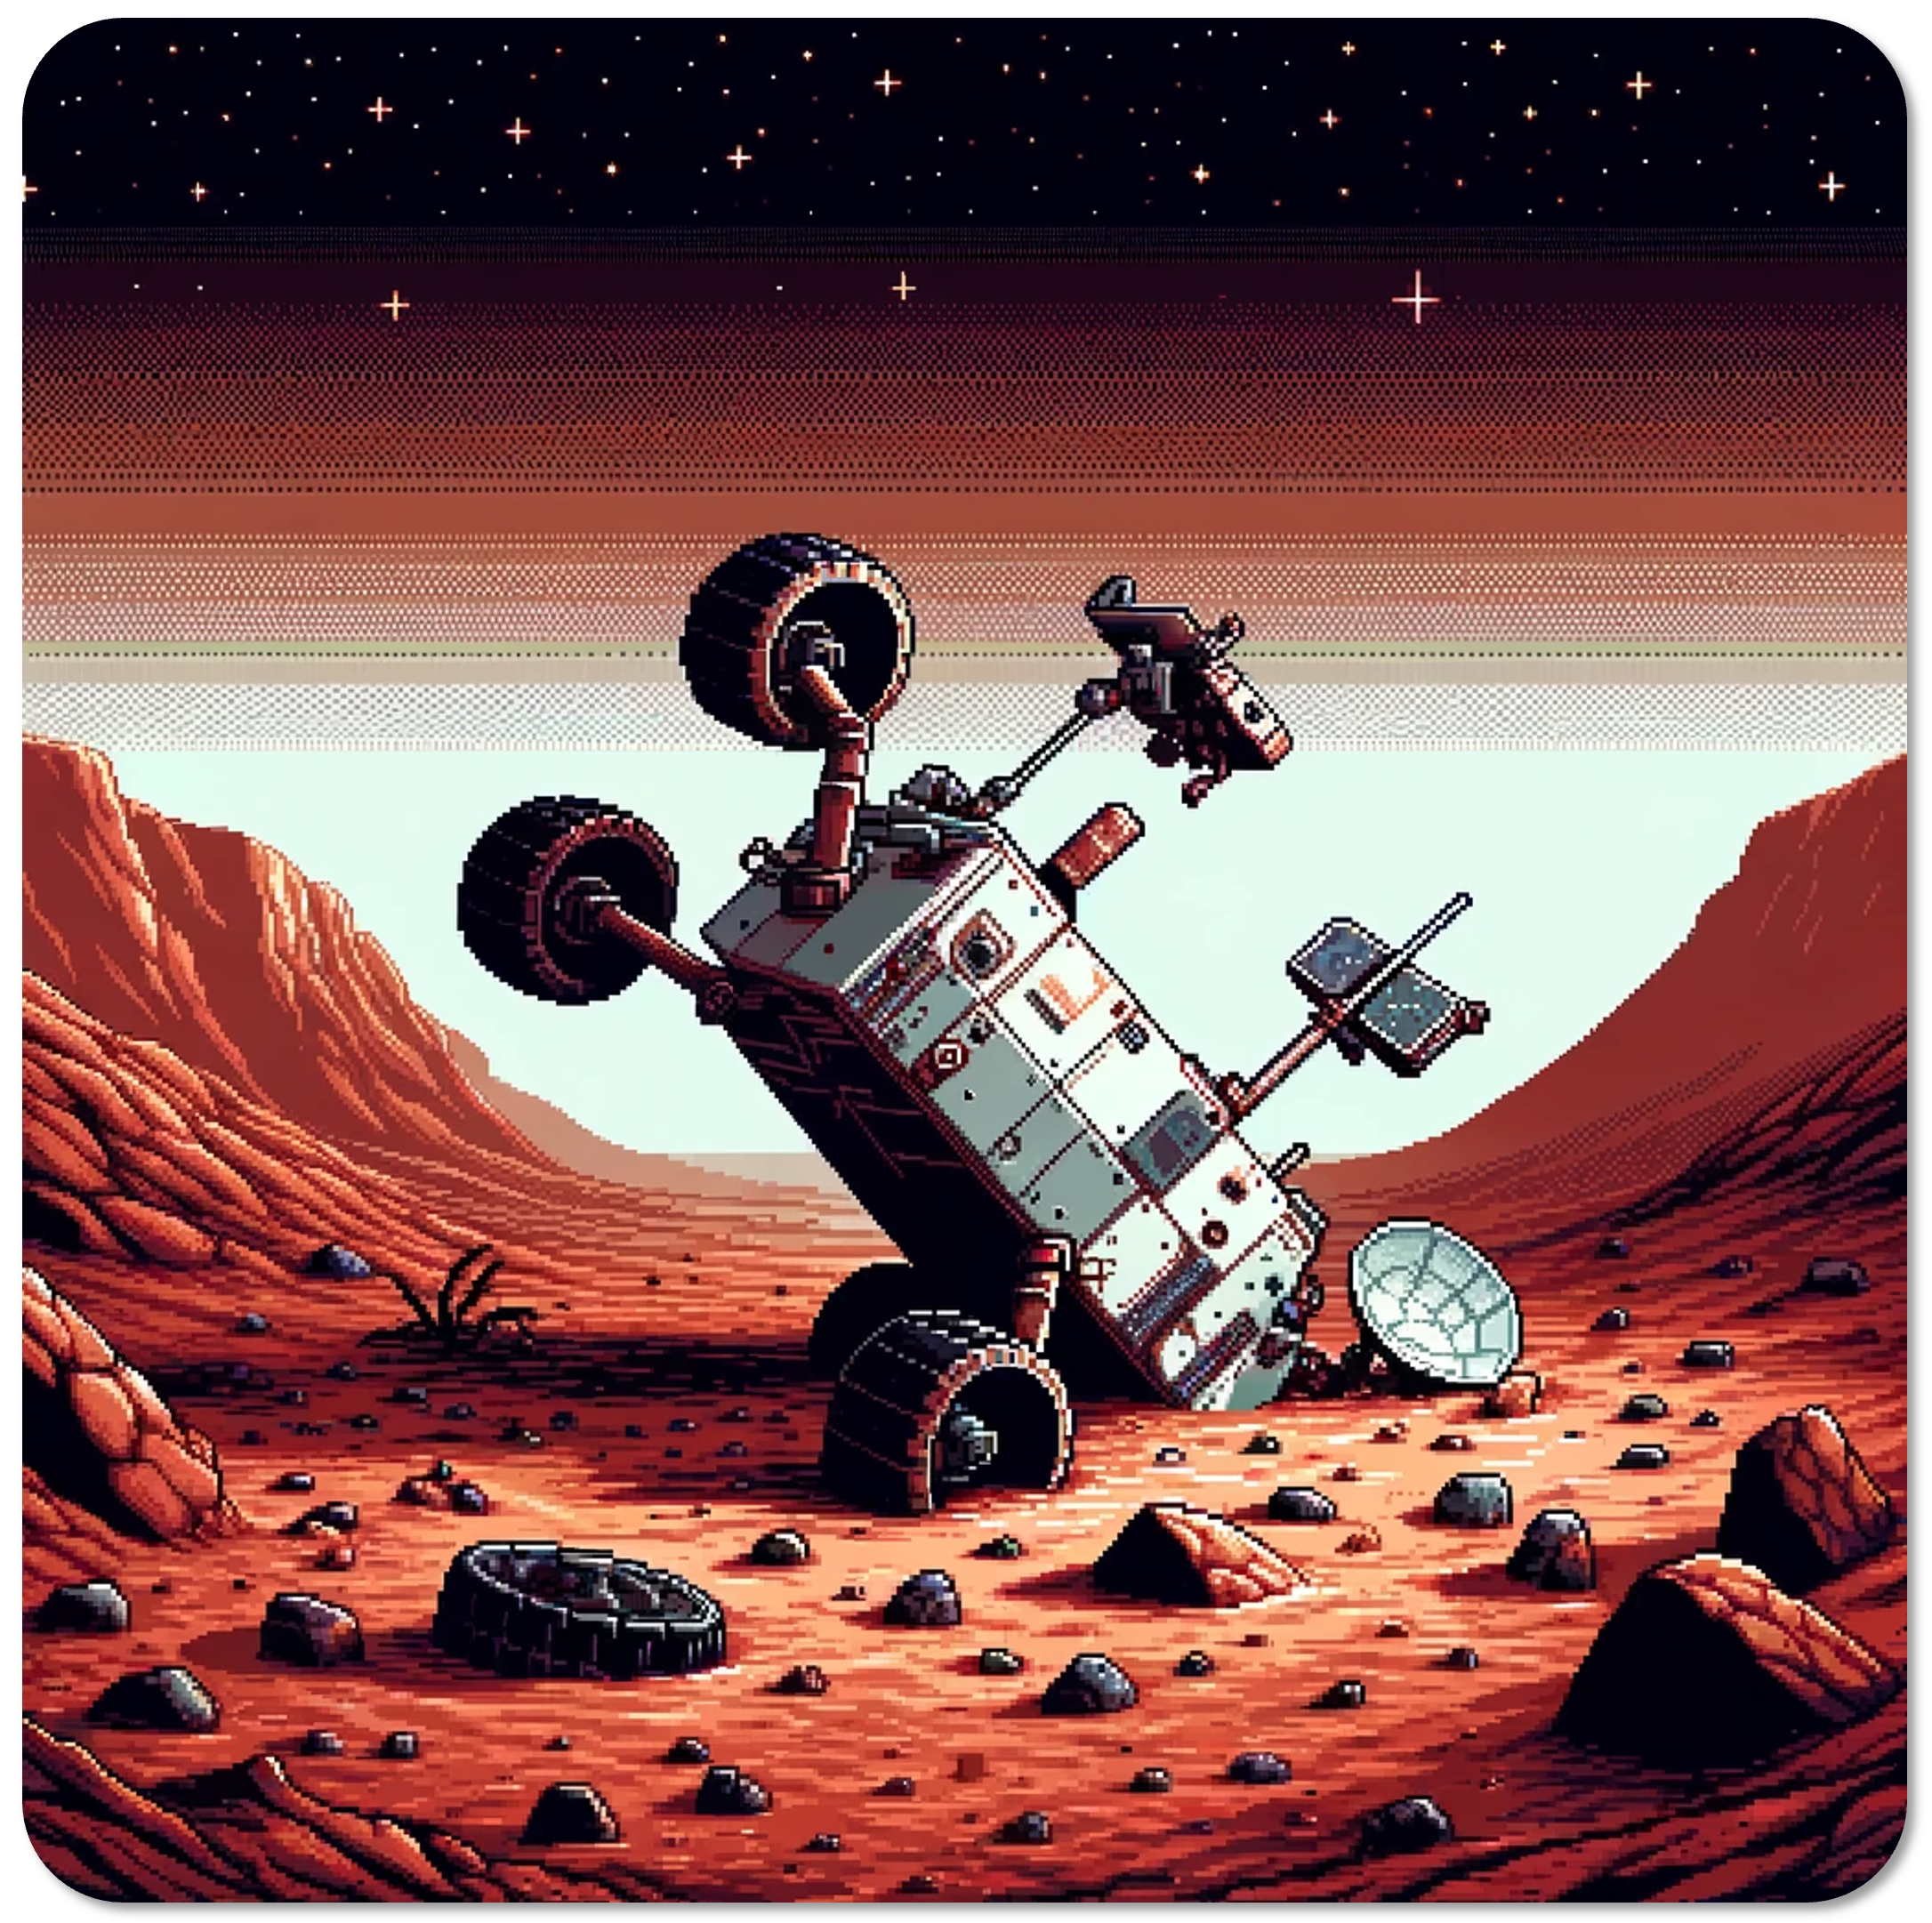
Łazik marsjański leży uszkodzony po wypadku na trudnym terenie

PPO

  • PPO ogranicza rozmiar każdej aktualizacji polityki
  • Poprawia stabilność

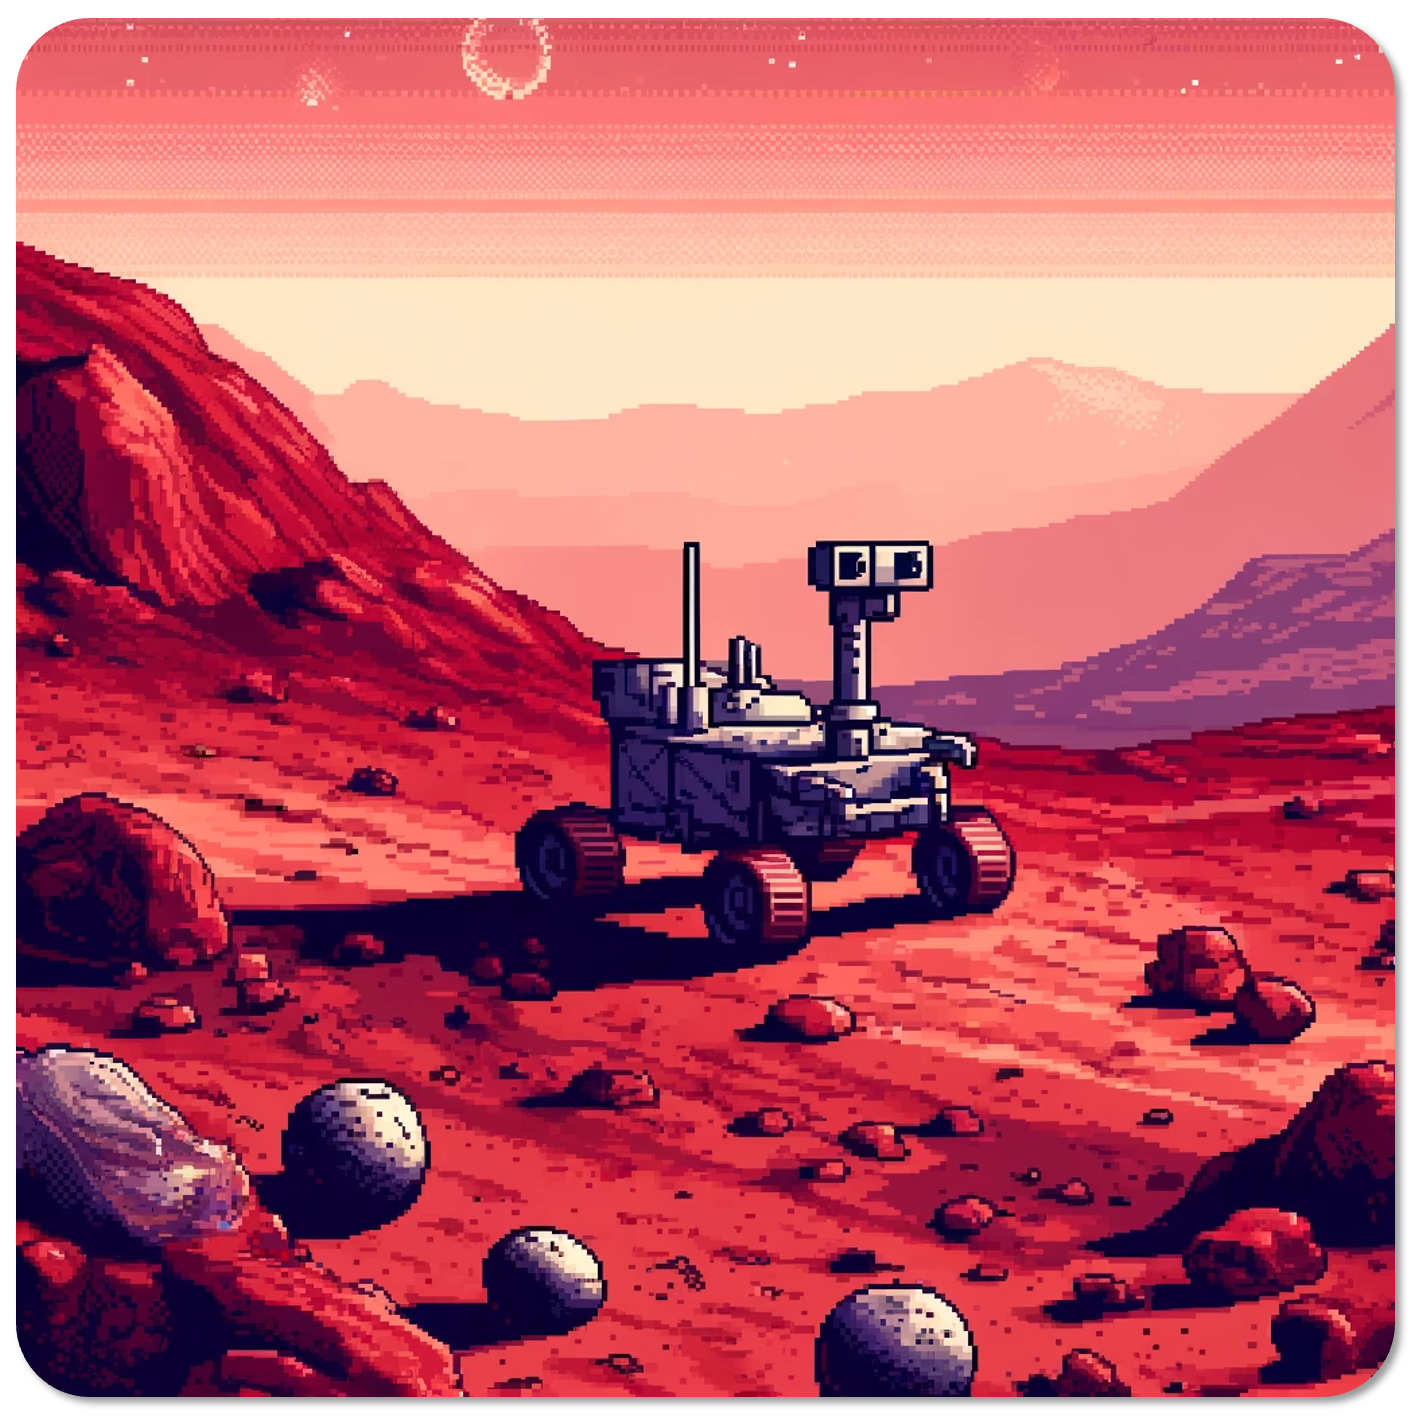
Łazik marsjański sprawnie jedzie po powierzchni Marsa

Głębokie uczenie ze wzmocnieniem w Pythonie

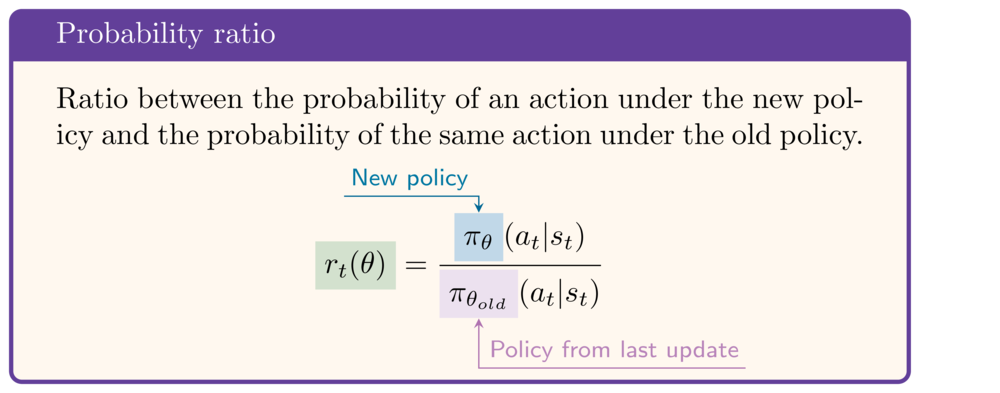
Współczynnik prawdopodobieństwa

  • Główna innowacja PPO: nowa funkcja celu
  • U jej podstaw:

Współczynnik prawdopodobieństwa: stosunek prawdopodobieństwa akcji w nowej polityce do prawdopodobieństwa w starej polityce, oznaczony r_t

  • O ile bardziej prawdopodobna jest akcja $a_t$ przy $\theta$ niż przy $\theta_{old}$?


  ratio = action_log_prob.exp() / 
          old_action_log_prob.exp().detach()

# Or equivalently ratio = torch.exp(action_log_prob - old_action_log_prob.detach())
  • detach mianownika zapobiega propagacji gradientu
Głębokie uczenie ze wzmocnieniem w Pythonie

Przycinanie współczynnika prawdopodobieństwa


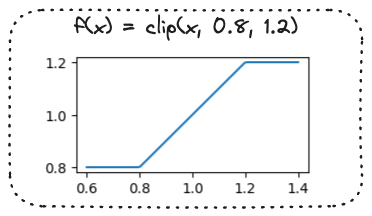
  • Funkcja clip:

Wykres funkcji clip(x, 0.8, 1.2) dla x od 0.6 do 1.4; funkcja wynosi 0.8 poniżej x=0.8; x między 0.8 a 1.2; 1.2 powyżej 1.2.

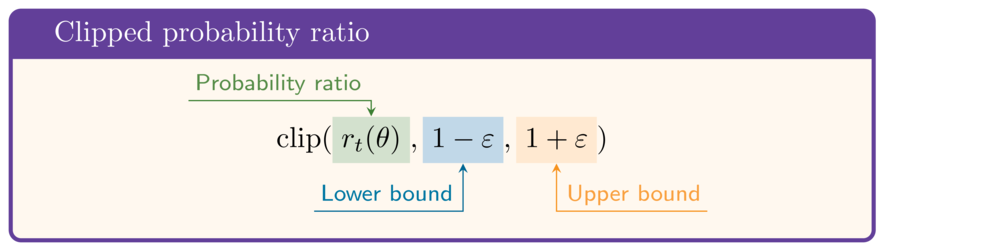
Przycięty współczynnik prawdopodobieństwa to clip(r_t, 1-epsilon, 1+epsilon)


clipped_ratio = torch.clamp(ratio,
                            1-epsilon, 
                            1+epsilon)
Głębokie uczenie ze wzmocnieniem w Pythonie

Funkcja calculate_ratios


def calculate_ratios(action_log_prob, action_log_prob_old, epsilon):

prob = action_log_prob.exp() prob_old = action_log_prob_old.exp() prob_old_detached = prob_old.detach() ratio = prob / prob_old_detached clipped_ratio = torch.clamp(ratio, 1-epsilon, 1+epsilon)
return (ratio, clipped_ratio)
Example with epsilon = .2:

Ratio: tensor(1.25)
Clipped ratio: tensor(1.20)
Głębokie uczenie ze wzmocnieniem w Pythonie

Funkcja celu PPO


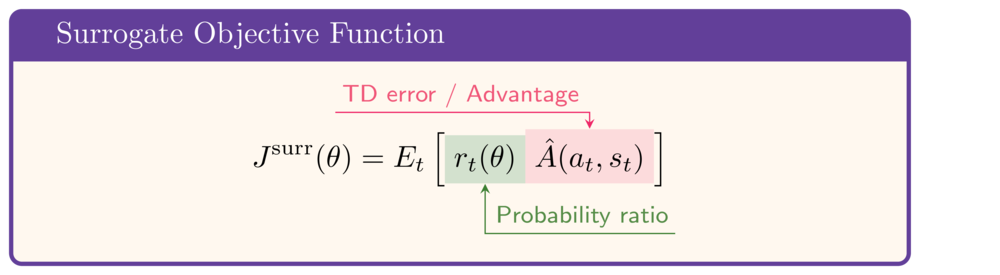
J surr = E_t(r_t * advantage)

surr1 = ratio * td_error.detach()

surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)


  • Surogat z przyciętym współczynnikiem:

$$\mathrm{clip}(r_t(\theta),1-\varepsilon,1+\varepsilon)\hat{A}$$

  • Przycięta surogacyjna funkcja celu PPO:
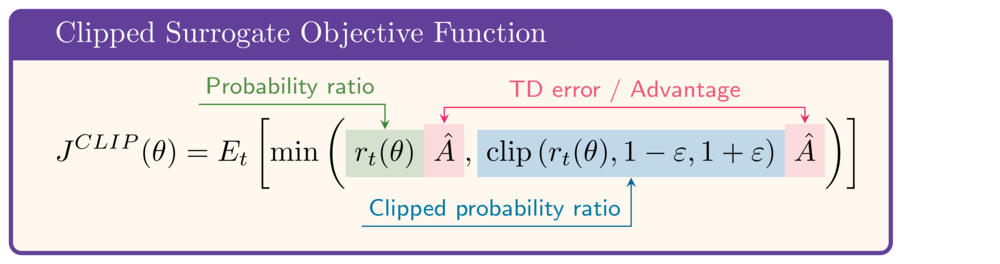
Przycięta surogacyjna funkcja celu: wartość oczekiwana minimum między ratio * advantage a clipped ratio * advantage.

  • Bardziej stabilna niż A2C
Głębokie uczenie ze wzmocnieniem w Pythonie

Obliczanie straty PPO


def calculate_losses(critic_network, 
                     action_log_prob,                                        
                     action_log_prob_old,
                     reward, state, next_state,
                     done
                     ):

    # calculate TD error (same as A2C)
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + 
                 gamma * next_value * (1-done))
    td_error = td_target - value
    ...


    ...
    ratio, clipped_ratio = 
            calculate_ratios(action_log_prob, 
                             action_log_prob_old,
                             epsilon)

surr1 = ratio * td_error.detach()
surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)
actor_loss = -objective
critic_loss = td_error ** 2 return actor_loss, critic_loss
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...