Priorytetowe odtwarzanie doświadczeń

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Nie wszystkie doświadczenia są równe


  • Odtwarzanie doświadczeń:
    • Równomierne próbkowanie może pomijać ważne wspomnienia
  • Priorytetowe odtwarzanie doświadczeń:
    • Przypisuje priorytet każdemu doświadczeniu na podstawie błędów TD
    • Skupia się na doświadczeniach o wysokim potencjale uczenia


Studenci uczą się w bibliotece

Głębokie uczenie ze wzmocnieniem w Pythonie

Priorytetowe odtwarzanie doświadczeń (PER)


for step = 1 to T do:
    # Take optimal action according to value function
    # Observe next state and reward
    # Append transition to replay buffer

# Give it highest priority (1)
# Sample a batch of past transitions
# Based on priority (2)
# Calculate TD errors for the batch
# Calculate the loss and update the Q Network
# Use importance sampling weights (4)
# Update priority of sampled transitions (3)
# Increase importance sampling over time. (5)

(1) Nowe przejścia są dodawane z najwyższym priorytetem $p_i = \max_k(p_k)$

(2) Próbkowanie przejścia $i$ z prawdopodobieństwem $$P(i) = p_i^{\alpha} / \sum_k p_k^{\alpha}\ \ \ \ \ \ \ \ (0<\alpha<1)$$

(3) Priorytet próbkowanych przejść jest aktualizowany do ich błędu TD: $p_i = |\delta_i| + \varepsilon$

(4) Użycie wag próbkowania z ważeniem $$w_i = \left( \frac{1}{N} \cdot \frac{1}{P(i)} \right)^\beta\ \ \ \ \ \ \ \ (0<\beta<1)$$

(5) Stopniowe zwiększanie $\beta$ w kierunku 1

Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja PER

def __init__(self, capacity, alpha=0.6, beta=0.4, beta_increment=0.001, epsilon=0.001):
    # Initialize memory buffer
    self.memory = deque(maxlen=capacity)

# Store parameters and initialize priorities self.alpha, self.beta, self.beta_increment, self.epsilon = (alpha, beta, beta_increment, epsilon) self.priorities = deque(maxlen=capacity)
...
Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja PER

...

def push(self, state, action, reward, next_state, done):
    # Append experience to memory buffer
    experience_tuple = (state, action, reward, next_state, done)
    self.memory.append(experience_tuple)

# Set priority of new transition to maximum priority max_priority = max(self.priorities) if self.memory else 1.0 self.priorities.append(max_priority)
...
Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja PER

def sample(self, batch_size):
    priorities = np.array(self.priorities)
    # Calculate sampling probabilities
    probabilities = priorities**self.alpha / np.sum(priorities**self.alpha)

# Randomly select sampled indices indices = np.random.choice(len(self.memory), batch_size, p=probabilities)
# Calculate weights weights = (1 / (len(self.memory) * probabilities)) ** self.beta weights /= np.max(weights) states, actions, rewards, next_states, dones = zip(*[self.memory[idx] for idx in indices]) weights = [weights[idx] for idx in indices] states, actions, rewards, next_states, dones = (zip(*[self.memory[idx] for idx in indices]))
# Return tensors states = torch.tensor(states, dtype=torch.float32) ... # Repeat for rewards, next_states, dones, weights actions = torch.tensor(actions, dtype=torch.long).unsqueeze(1) return (states, actions, rewards, next_states, dones, indices, weights)
Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja PER

...

def update_priorities(self, indices, td_errors: torch.Tensor):
    # Update priorities for sampled transitions
    for idx, td_error in zip(indices, td_errors.abs()):
        self.priorities[idx] = abs(td_error.item()) + self.epsilon

def increase_beta(self): # Increment beta towards 1 self.beta = min(1.0, self.beta + self.beta_increment)
Głębokie uczenie ze wzmocnieniem w Pythonie

PER w pętli treningowej DQN


  1. W kodzie przed pętlą:

    buffer = PrioritizedReplayBuffer(capacity)
    
  2. Na początku każdego epizodu:

    buffer.increase_beta()
    

3. Na każdym kroku:

# After selecting an action
buffer.push(state, action, reward, 
            next_state, done)
...

# Before calculating the TD errors: replay_buffer.sample(batch_size) ...
# After calculating the TD errors buffer.update_priorities(indices, td_errors)
loss = torch.sum(weights * (td_errors ** 2))
Głębokie uczenie ze wzmocnieniem w Pythonie

PER w działaniu: Cartpole

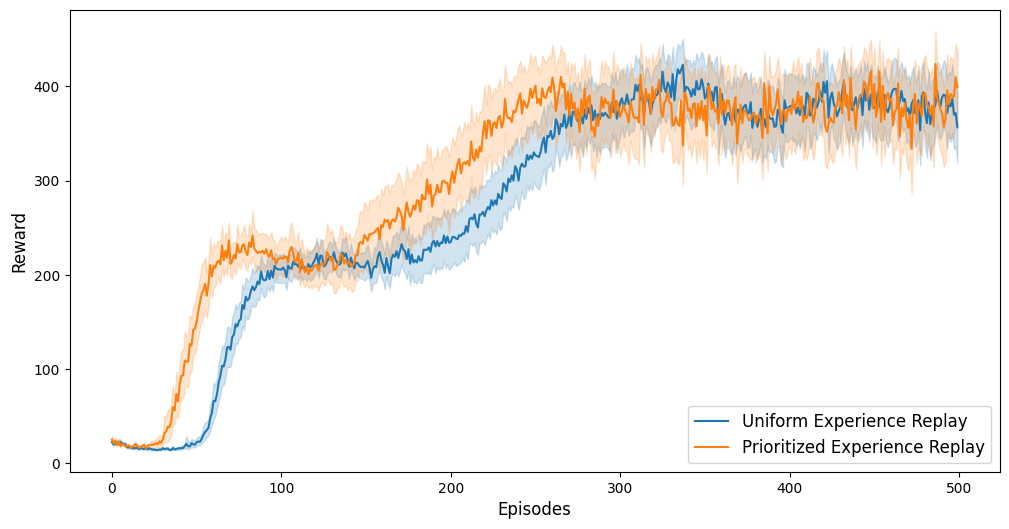
100 przebiegów treningowych w środowisku Cartpole:

  1. z priorytetowym odtwarzaniem doświadczeń
  2. z równomiernym odtwarzaniem doświadczeń
  • Szybsze uczenie się i lepsze wyniki z PER niż z równomiernym odtwarzaniem

Krzywe uczenia pokazują szybsze uczenie się z PER


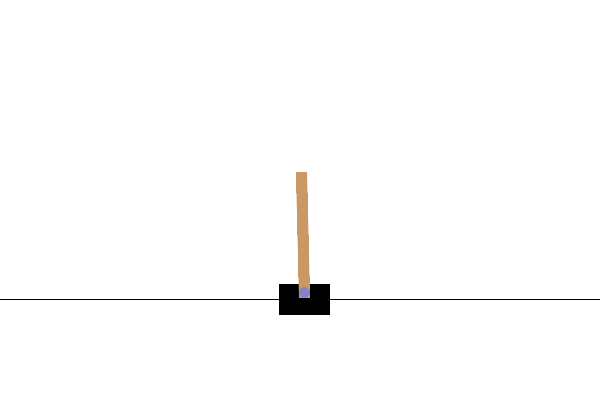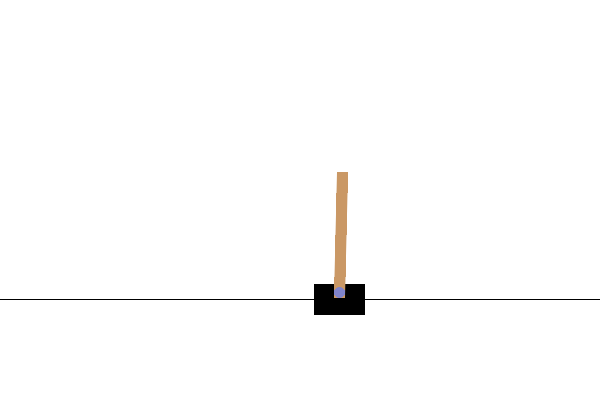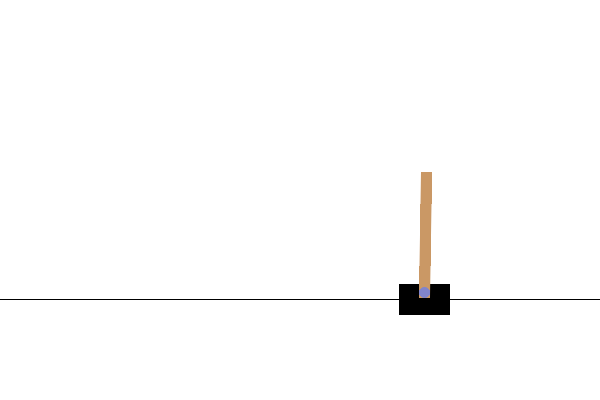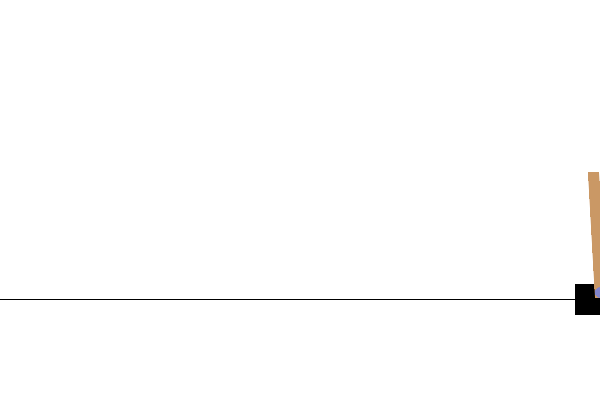
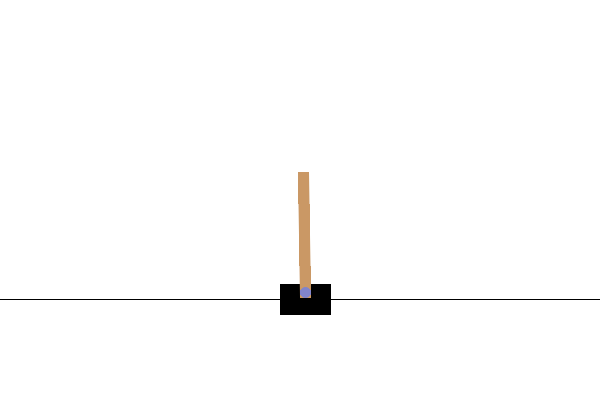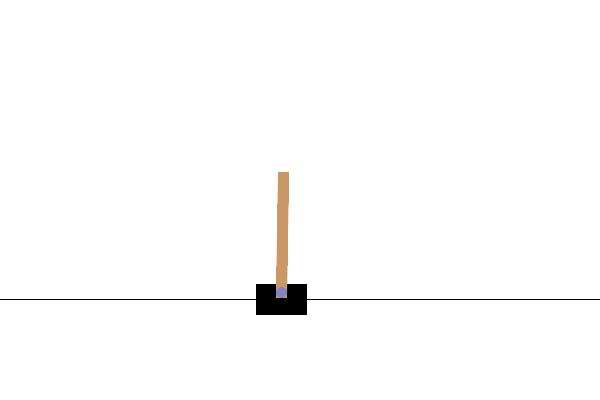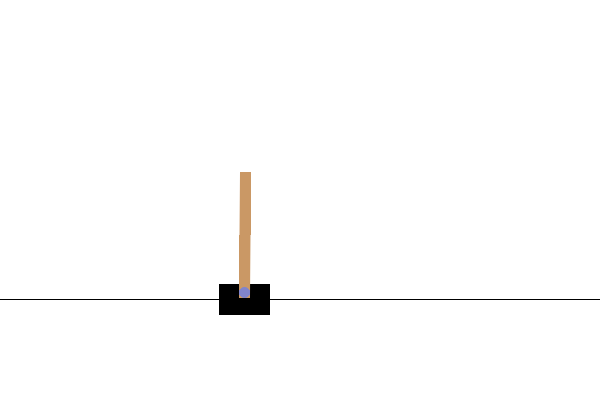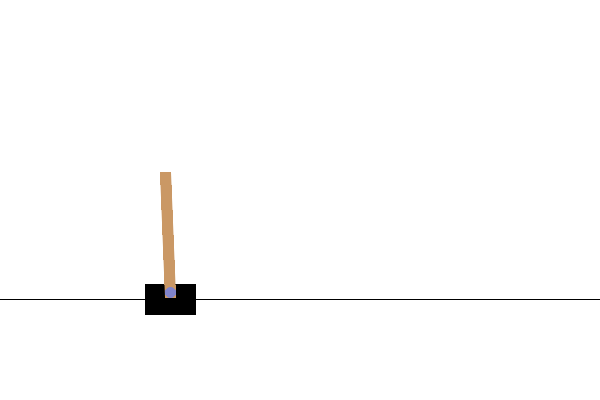
Po 100 epokach: Cartpole, niestabilne po 100 epokach


Po 400 epokach: Cartpole, stabilne po 400 epokach

Głębokie uczenie ze wzmocnieniem w Pythonie

PER w działaniu: środowiska Atari


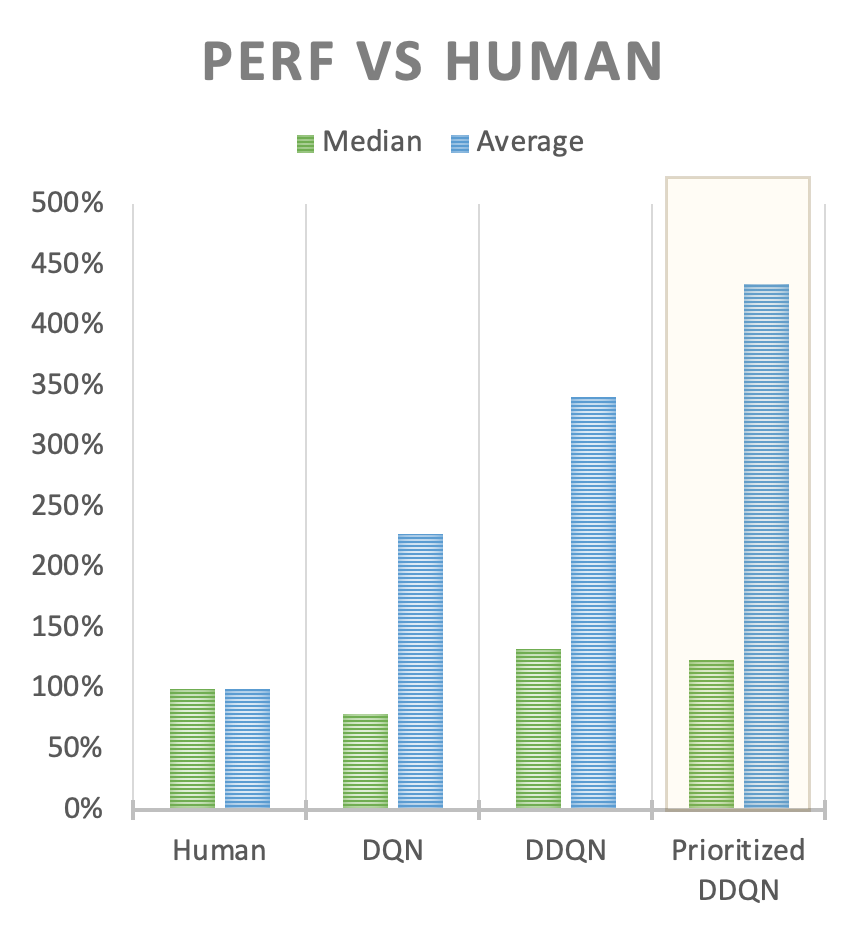
  • Znaczący wzrost wydajności dzięki PER w środowiskach Atari

Wykres słupkowy porównujący wyniki człowieka, DQN, DDQN, Dueling DDQN, Prioritized DDQN i Prioritized Dueling DQN. Pierwsze cztery są identyczne z poprzednią lekcją o Dueling DQN. Ostatni pokazuje, że wprowadzenie priorytetowego odtwarzania doświadczeń poprawia wyniki DDQN.

1 https://arxiv.org/abs/2303.11634
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...