Metode avansate de împărțire

Retrieval Augmented Generation (RAG) cu LangChain

Meri Nova

Machine Learning Engineer

Limitările strategiilor actuale de împărțire


  1. 🤦 Împărțirile sunt naive (fără context)

    • Ignoră contextul textului înconjurător
  2. 🖇 Împărțirile se fac pe caractere vs. tokeni

    • Tokenii sunt procesați de modele
    • Risc de depășire a ferestrei de context


→ SemanticChunker


→ TokenTextSplitter

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

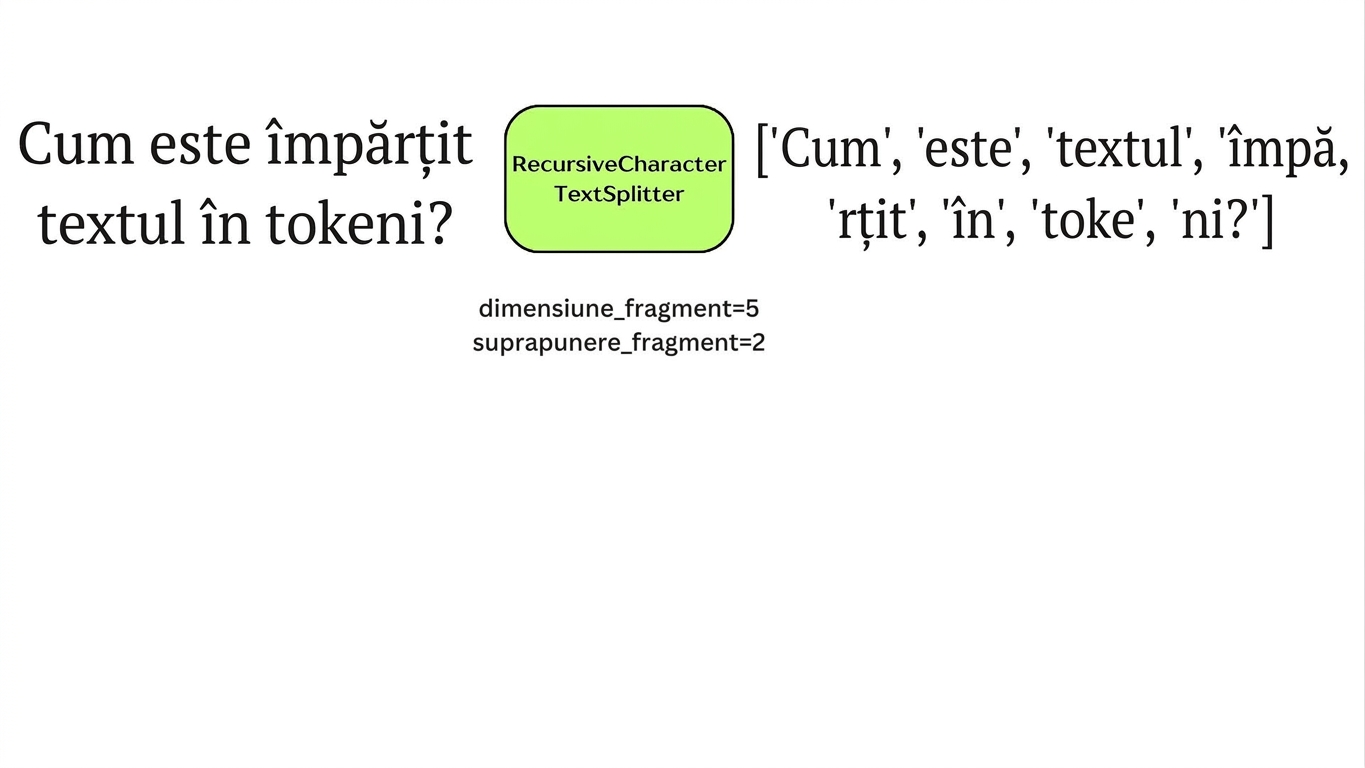
Un splitter de text pe caractere împarte textul în fragmente pe baza numărului de caractere.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

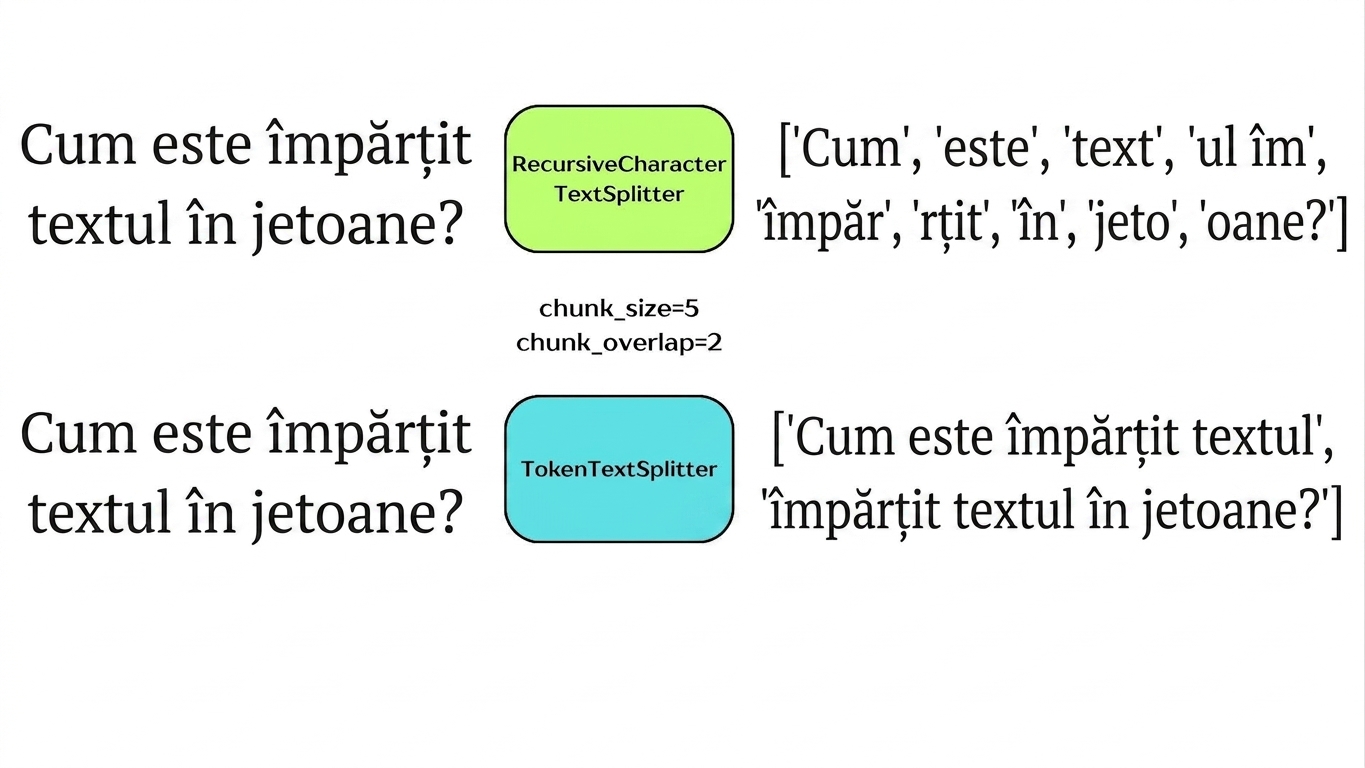
Un splitter de text pe tokeni împarte textul în fragmente pe baza numărului de tokeni.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

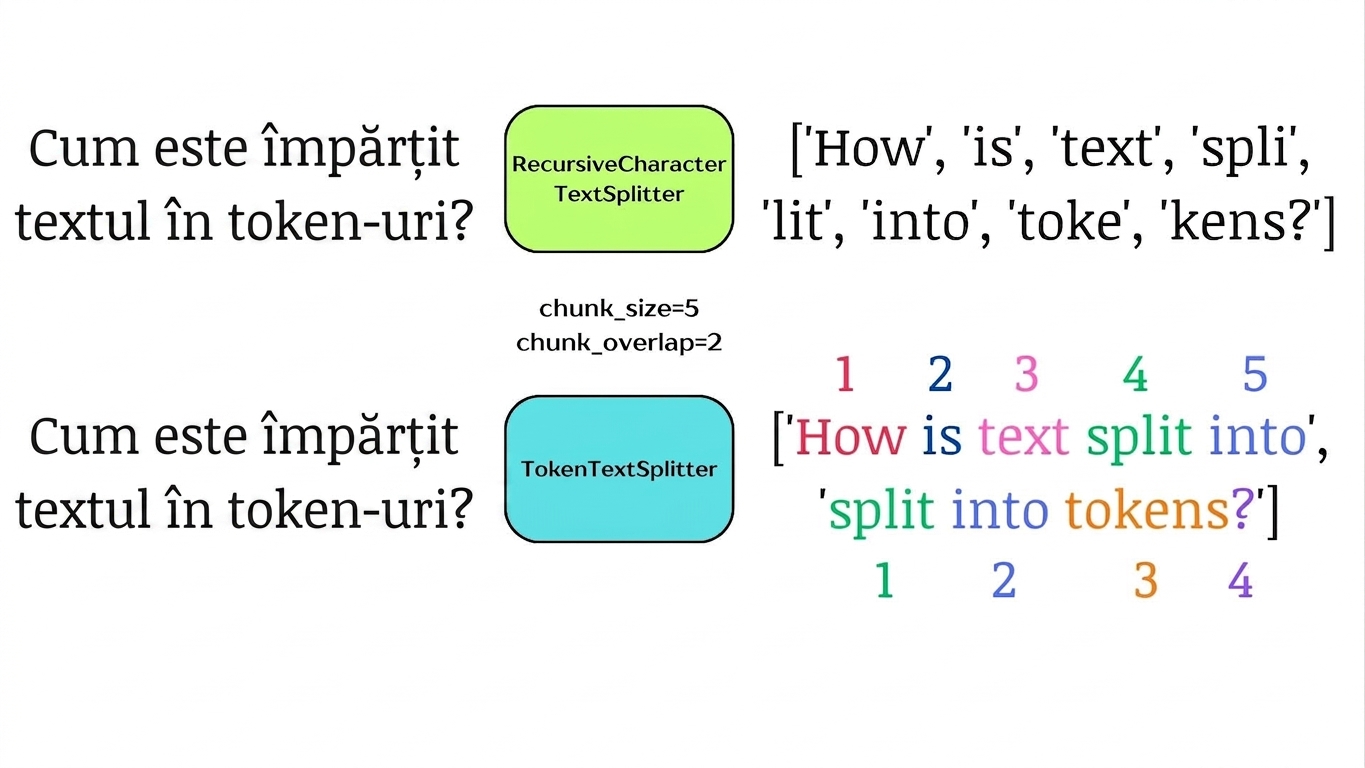
Tokenii sunt evidențiați pentru a arăta alinierea cu valorile chunk_size și chunk_overlap.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

import tiktoken
from langchain_text_splitters import TokenTextSplitter
example_string = "Mary had a little lamb, it's fleece was white as snow."

encoding = tiktoken.encoding_for_model('gpt-4o-mini')
splitter = TokenTextSplitter(encoding_name=encoding.name,
                             chunk_size=10,
                             chunk_overlap=2)

chunks = splitter.split_text(example_string) for i, chunk in enumerate(chunks): print(f"Chunk {i+1}:\n{chunk}\n")
Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

Chunk 1:
Mary had a little lamb, it's fleece

Chunk 2:
 fleece was white as snow.
Retrieval Augmented Generation (RAG) cu LangChain

Împărțire pe tokeni

for i, chunk in enumerate(chunks):
    print(f"Chunk {i+1}:\nNo. tokens: {len(encoding.encode(chunk))}\n{chunk}\n")
Chunk 1:
No. tokens: 10
Mary had a little lamb, it's fleece was

Chunk 2:
No. tokens: 6
 fleece was white as snow.
Retrieval Augmented Generation (RAG) cu LangChain

Împărțire semantică

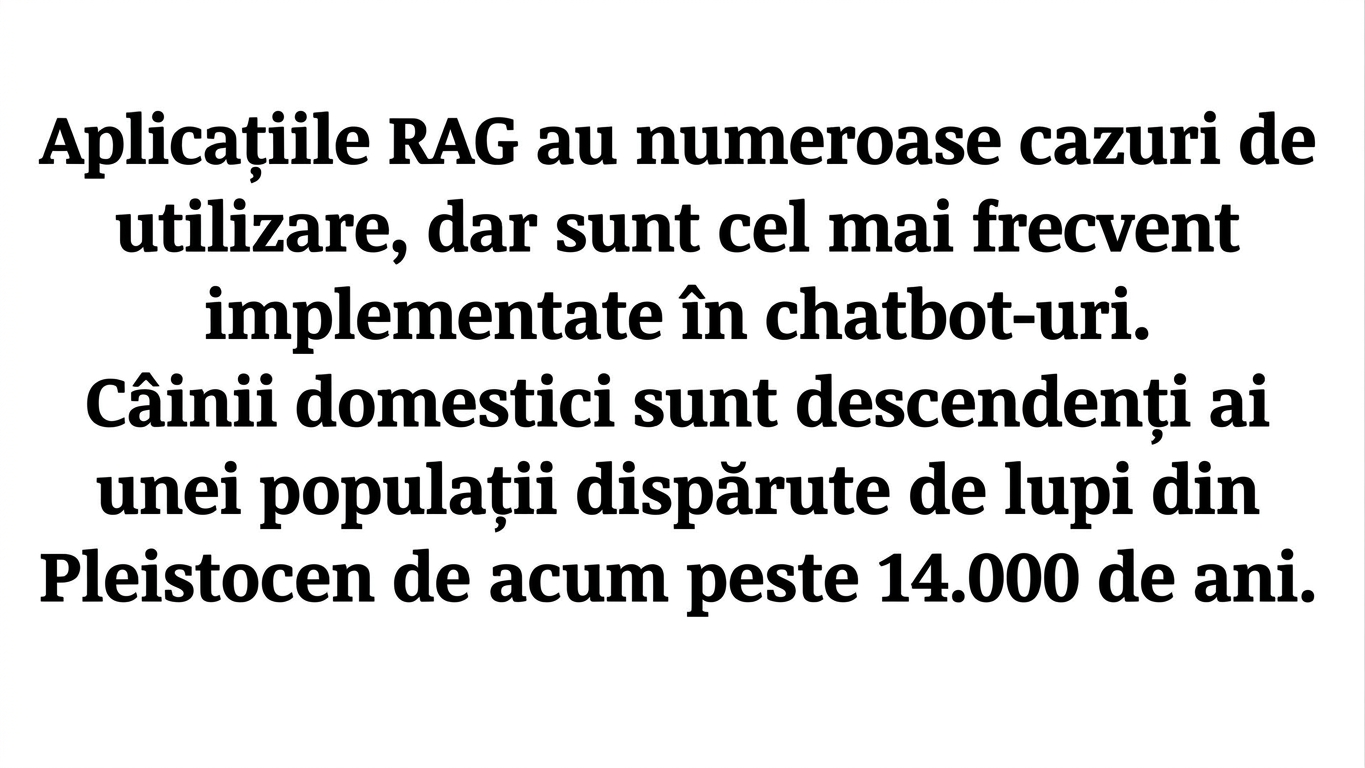
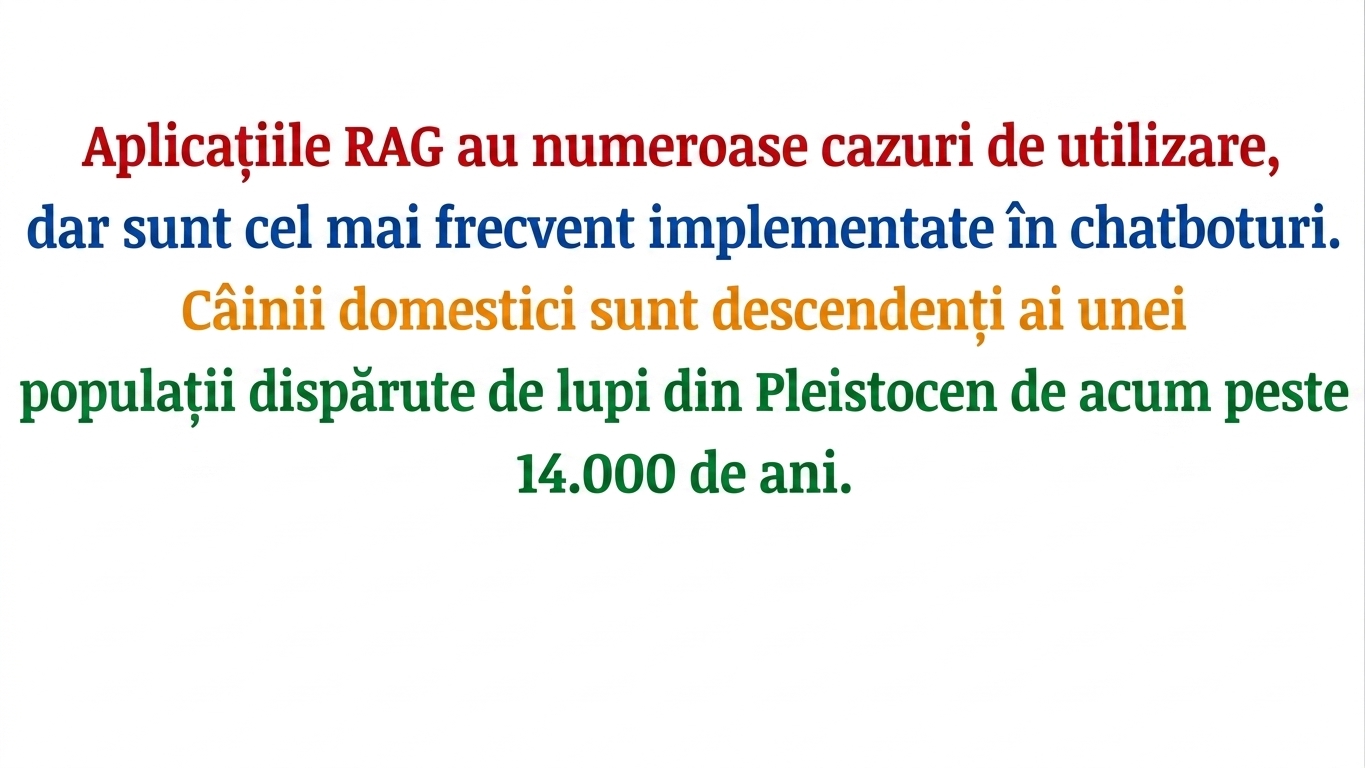
Un paragraf care conține o propoziție despre aplicații RAG și una despre câini.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire semantică

Paragraful a fost împărțit pe caractere sau tokeni, pierzând contextul.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire semantică

Un splitter semantic a împărțit paragraful acolo unde subiectul se schimbă de la RAG la câini.

Retrieval Augmented Generation (RAG) cu LangChain

Împărțire semantică

from langchain_openai import OpenAIEmbeddings
from langchain_experimental.text_splitter import SemanticChunker

embeddings = OpenAIEmbeddings(api_key="...", model='text-embedding-3-small')
semantic_splitter = SemanticChunker( embeddings=embeddings,
breakpoint_threshold_type="gradient", breakpoint_threshold_amount=0.8
)
1 https://api.python.langchain.com/en/latest/text_splitter/langchain_experimental.text_splitter. SemanticChunker.html
Retrieval Augmented Generation (RAG) cu LangChain

Împărțire semantică

chunks = semantic_splitter.split_documents(data)
print(chunks[0])
page_content='Retrieval-Augmented Generation for\nKnowledge-Intensive NLP Tasks\ Patrick Lewis,
Ethan Perez,\nAleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich
Küttler,\nMike Lewis, Wen-tau Yih, Tim Rocktäschel, Sebastian Riedel, Douwe Kiela\nFacebook AI
Research; University College London;New York University;\[email protected]\nAbstract\nLarge
pre-trained language models have been shown to store factual knowledge\nin their parameters,
and achieve state-of-the-art results when fine-tuned on down-\nstream NLP tasks. However, their
ability to access and precisely manipulate knowl-\nedge is still limited, and hence on
knowledge-intensive tasks, their performance\nlags behind task-specific architectures.'
metadata={'source': 'rag_paper.pdf', 'page': 0}
Retrieval Augmented Generation (RAG) cu LangChain

Să exersăm!

Retrieval Augmented Generation (RAG) cu LangChain

Preparing Video For Download...