Divizarea textului, embeddings și stocarea vectorilor

Retrieval Augmented Generation (RAG) cu LangChain

Meri Nova

Machine Learning Engineer

Pregătirea datelor pentru recuperare

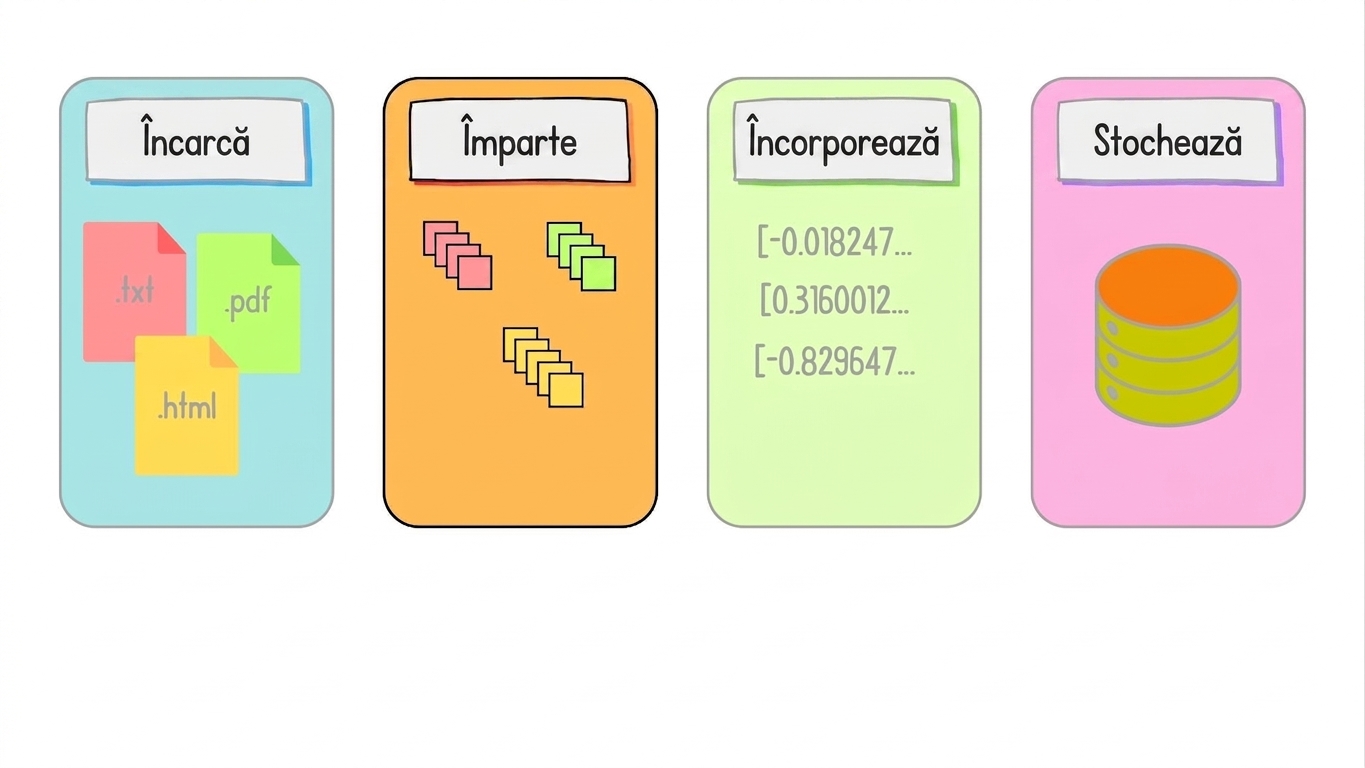
Documente being loaded.

Retrieval Augmented Generation (RAG) cu LangChain

Pregătirea datelor pentru recuperare

Documente being split.

Retrieval Augmented Generation (RAG) cu LangChain

Pregătirea datelor pentru recuperare

Fragmentele de document sunt incluse în embeddings.

Retrieval Augmented Generation (RAG) cu LangChain

Pregătirea datelor pentru recuperare

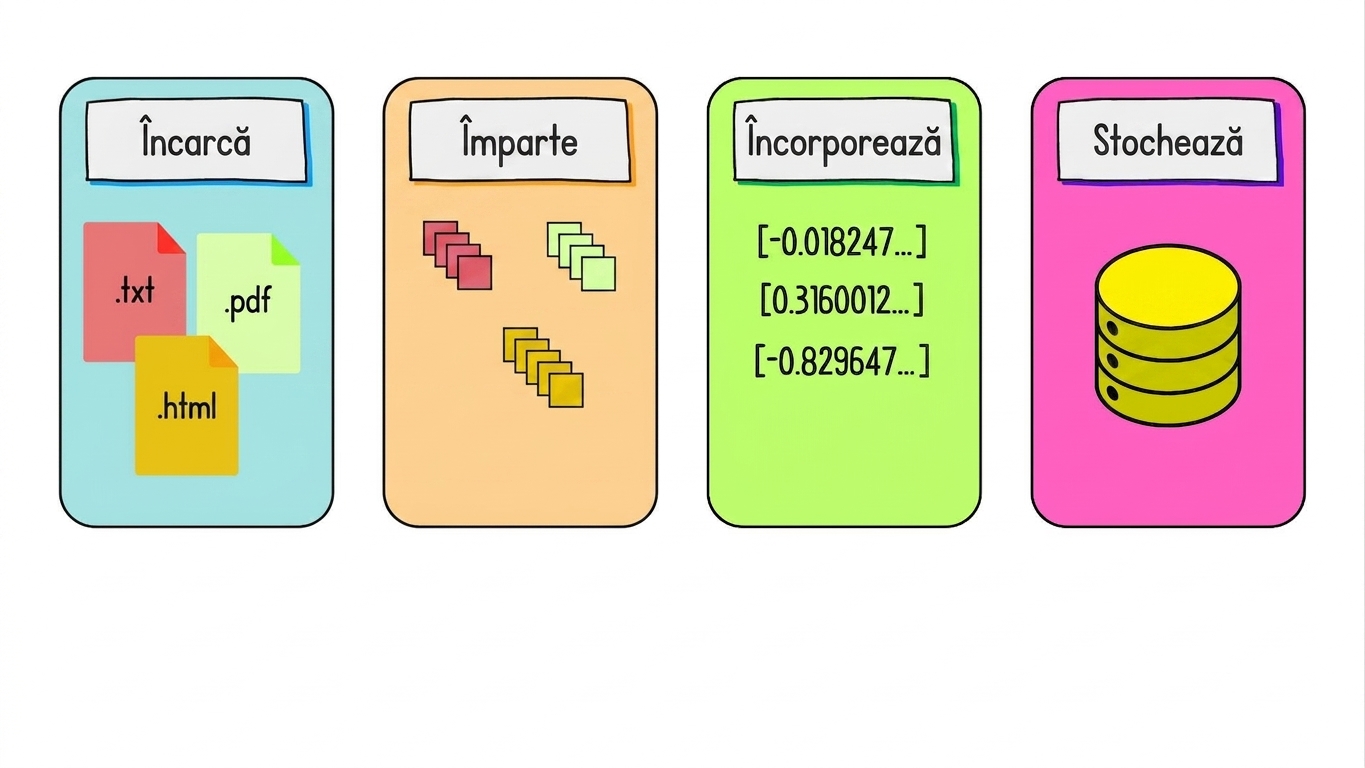
Fragmentele de document sunt stocate.

Retrieval Augmented Generation (RAG) cu LangChain

Pregătirea datelor pentru recuperare

Pasul de divizare este evidențiat în fluxul de dezvoltare RAG.

Retrieval Augmented Generation (RAG) cu LangChain

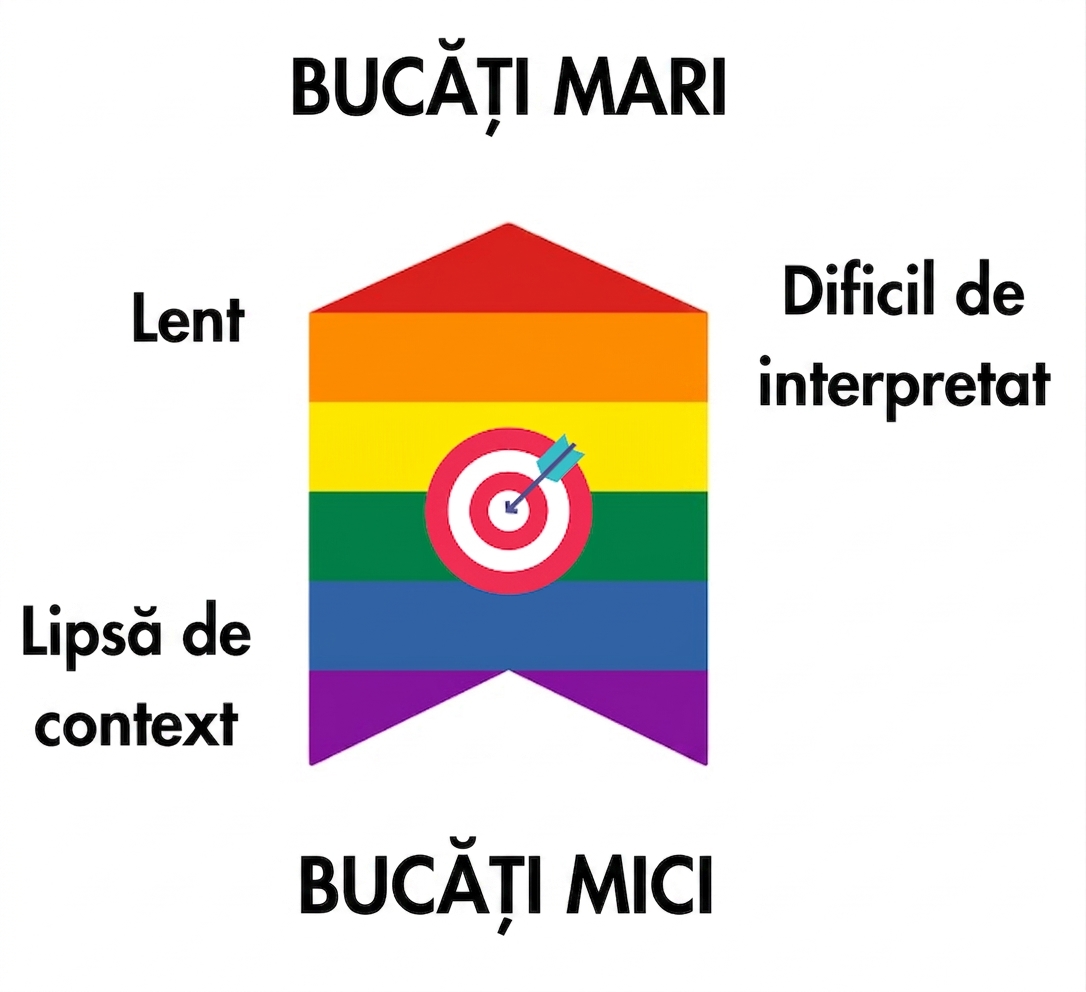
chunk_size

O săgeată care arată că dimensiunea ideală a fragmentului se află undeva la mijloc; fragmentele mari pot fi lente la recuperare și greu de interpretat, iar fragmentele mici pot conține context insuficient.

chunk_overlap

  • Includerea informațiilor dincolo de limită
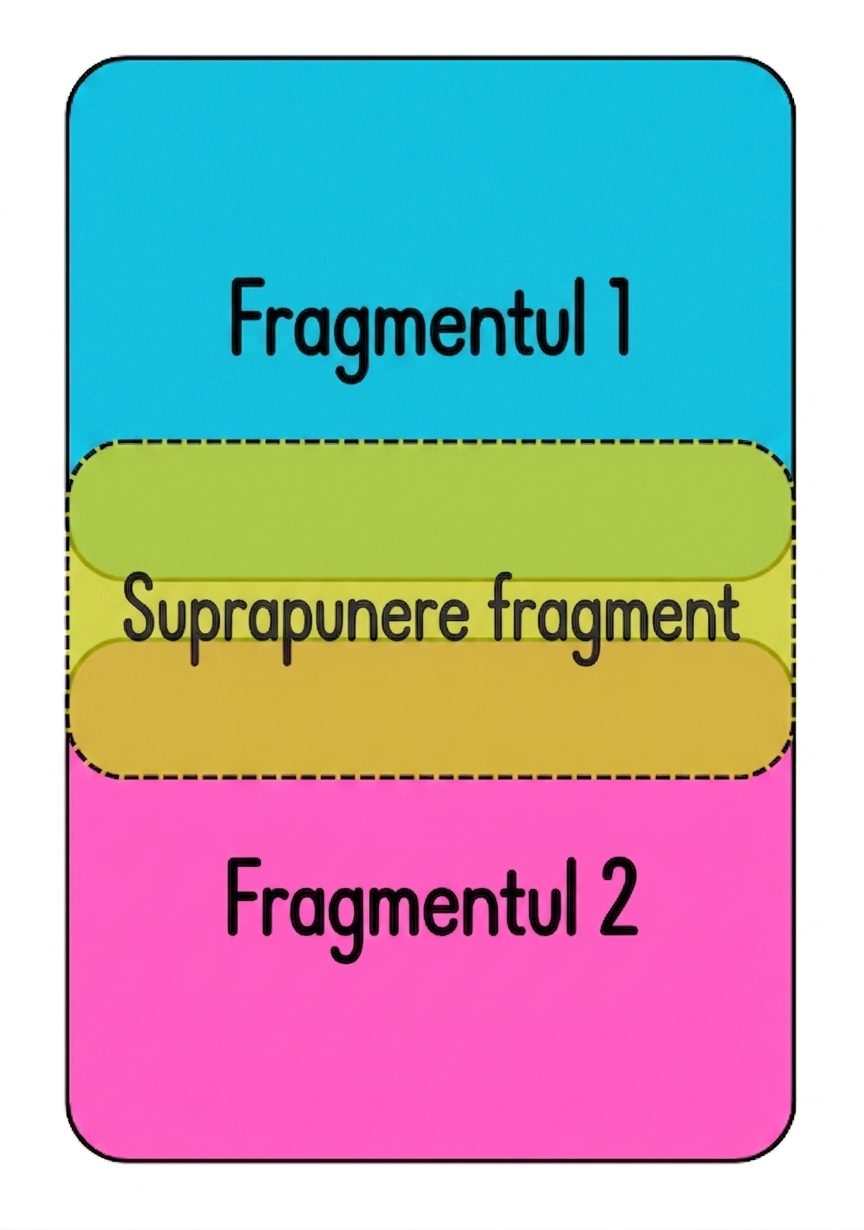
Două fragmente cu o zonă evidențiată care se suprapune pe ambele.

Retrieval Augmented Generation (RAG) cu LangChain

CharacterTextSplitter

from langchain_text_splitters import CharacterTextSplitter

text = """Machine learning is a fascinating field.\n\nIt involves algorithms and models that can learn from data. These models can then make predictions or decisions without being explicitly programmed to perform the task.\nThis capability is increasingly valuable in various industries, from finance to healthcare.\n\nThere are many types of machine learning, including supervised, unsupervised, and reinforcement learning.\nEach type has its own strengths and applications."""
text_splitter = CharacterTextSplitter( separator="\n\n", chunk_size=100, chunk_overlap=10 )
Retrieval Augmented Generation (RAG) cu LangChain

CharacterTextSplitter

chunks = text_splitter.split_text(text)

print(chunks) print([len(chunk) for chunk in chunks])
['Machine learning is a fascinating field.',
 'It involves algorithms and models that can learn from data. These models can...',
 'There are many types of machine learning, including supervised, unsupervised...']

[40, 260, 155]
  • Fragmentele pot lipsi de context
  • Fragmentele pot depăși chunk_size
Retrieval Augmented Generation (RAG) cu LangChain

RecursiveCharacterTextSplitter

from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(

separators=["\n\n", "\n", " ", ""],
chunk_size=100, chunk_overlap=10
)
Retrieval Augmented Generation (RAG) cu LangChain

RecursiveCharacterTextSplitter

chunks = splitter.split_text(text)

print(chunks)
print([len(chunk) for chunk in chunks])
['Machine learning is a fascinating field.',
 'It involves algorithms and models that can learn from data. These models ...',
 'or decisions without being explicitly programmed to perform the task.',
 'This capability is increasingly valuable in various industries, from ...',
 'There are many types of machine learning, including supervised, ...',
 'learning.',
 'Each type has its own strengths and applications.']
[40, 98, 69, 91, 95, 9, 49]
Retrieval Augmented Generation (RAG) cu LangChain

Divizarea documentelor

from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader("research_paper.pdf")
documents = loader.load()

splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = splitter.split_documents(documents)
Retrieval Augmented Generation (RAG) cu LangChain

Divizarea documentelor

print(chunks)

print([len(chunk.page_content) for chunk in chunks])
[Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...'),
 Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...'),
 Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...')]

[928, 946, 921,...]
Retrieval Augmented Generation (RAG) cu LangChain

Embedding și stocare

Pașii de embedding și stocare sunt evidențiați.

Retrieval Augmented Generation (RAG) cu LangChain

Ce sunt embeddings-urile?

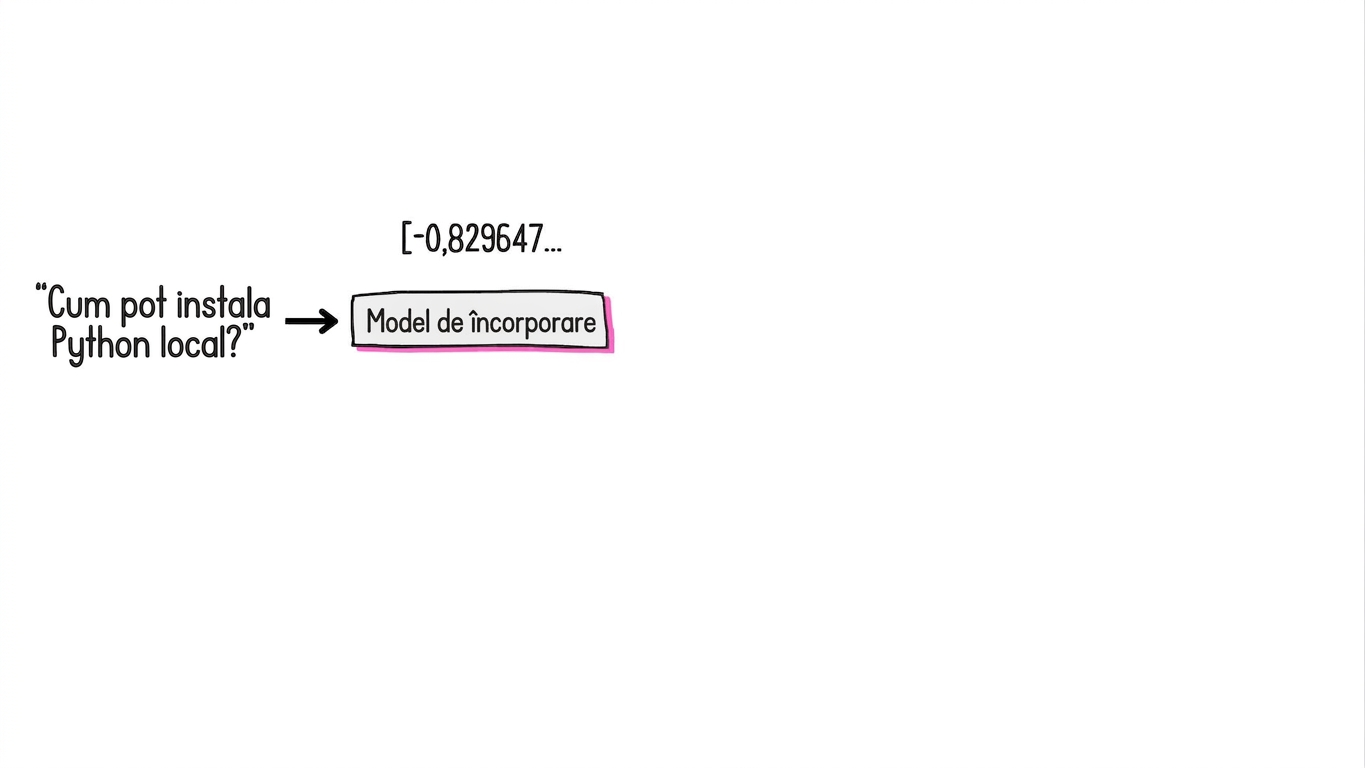
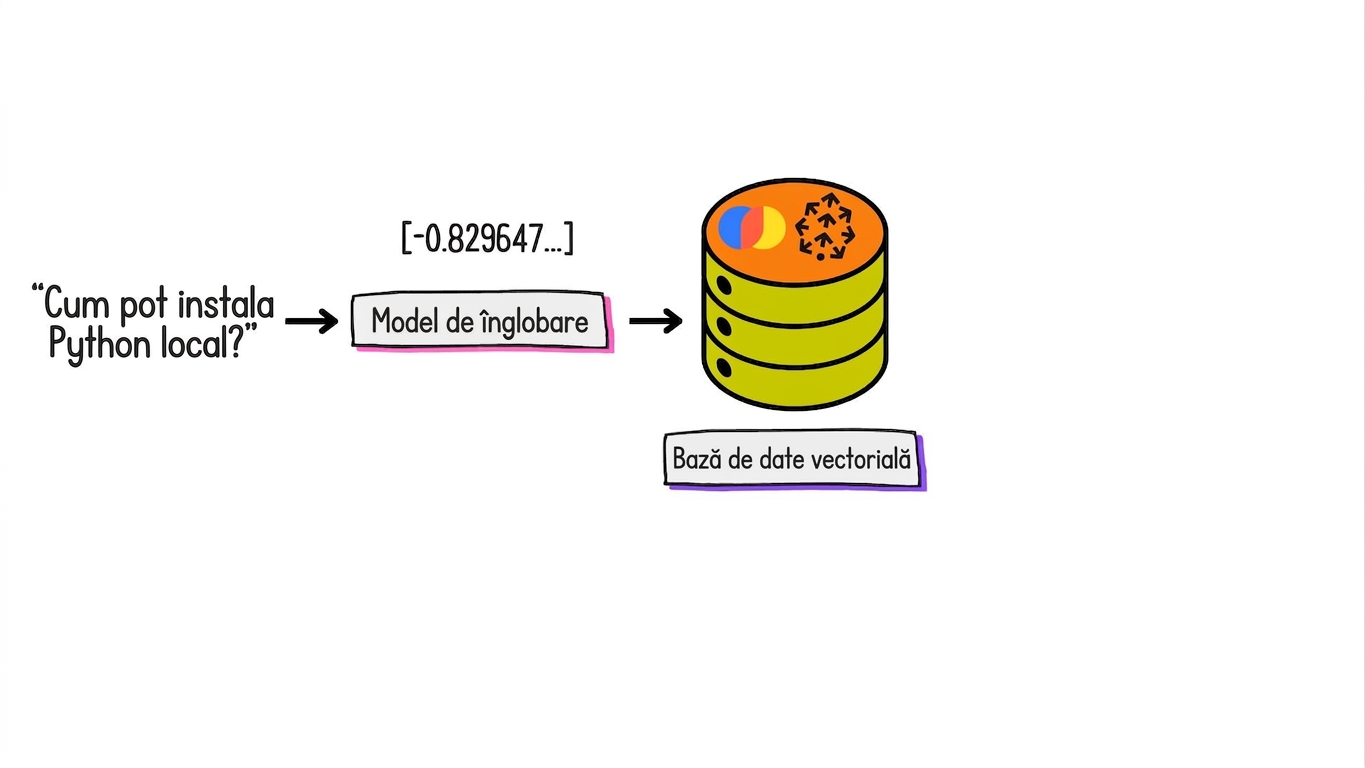
O propoziție este introdusă într-un model de embedding.

Retrieval Augmented Generation (RAG) cu LangChain

Ce sunt embeddings-urile?

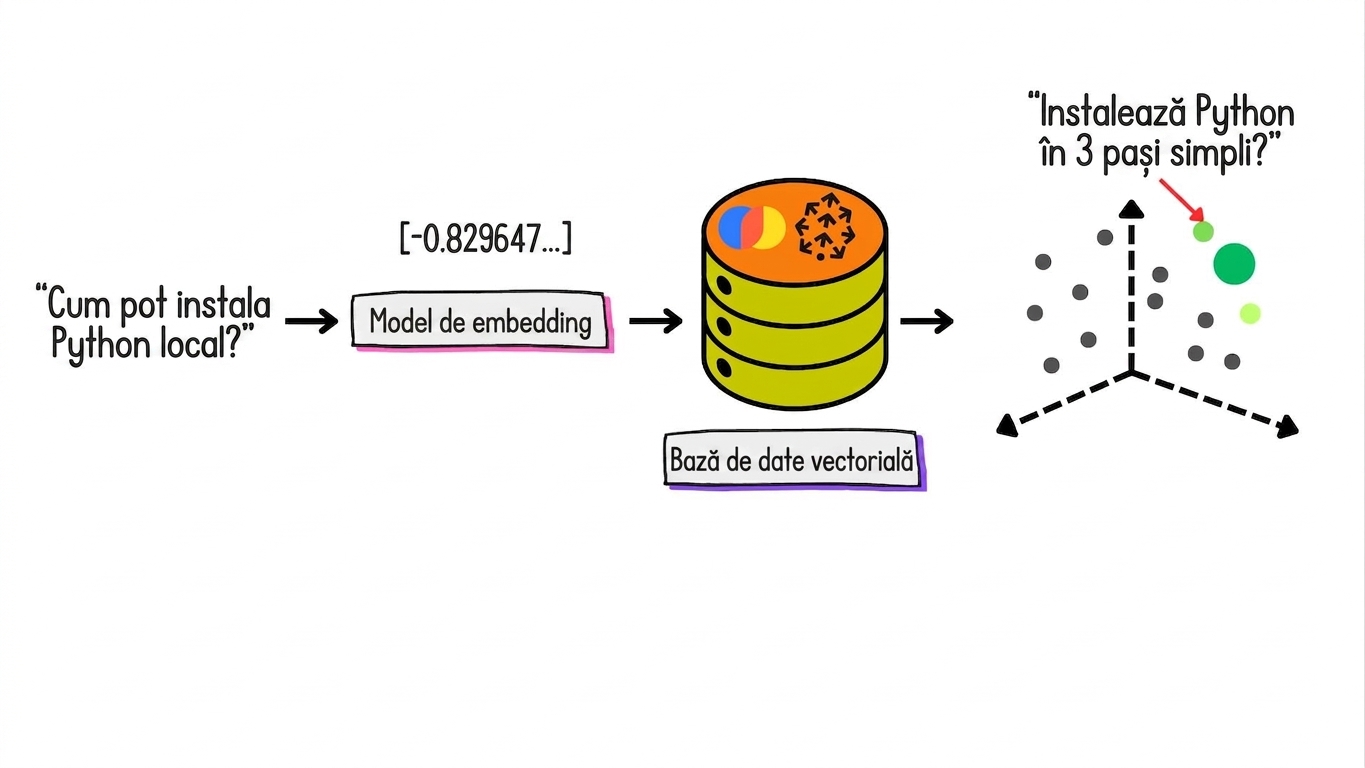
Modelul de embedding reprezintă textul ca vector de valori numerice.

Retrieval Augmented Generation (RAG) cu LangChain

Ce sunt embeddings-urile?

what_are_embeddings3.jpg

Retrieval Augmented Generation (RAG) cu LangChain

Ce sunt embeddings-urile?

what_are_embeddings4.jpg

Retrieval Augmented Generation (RAG) cu LangChain

Embedding și stocarea fragmentelor

  • Embedding și stocare cu: OpenAI și ChromaDB
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma

embedding_model = OpenAIEmbeddings(
    api_key=openai_api_key,
    model="text-embedding-3-small"
)


vector_store = Chroma.from_documents( documents=chunks, embedding=embedding_model )
Retrieval Augmented Generation (RAG) cu LangChain

Să exersăm!

Retrieval Augmented Generation (RAG) cu LangChain

Preparing Video For Download...