Optimizatori, antrenare și evaluare

Deep Learning intermediar cu PyTorch

Michal Oleszak

Machine Learning Engineer

Bucla de antrenare

import torch.nn as nn
import torch.optim as optim

criterion = nn.BCELoss()
optimizer = optim.SGD(net.parameters(), lr=0.01)


for epoch in range(1000): for features, labels in dataloader_train:
optimizer.zero_grad()
outputs = net(features)
loss = criterion( outputs, labels.view(-1, 1) )
loss.backward()
optimizer.step()
  • Definirea funcției de pierdere și a optimizatorului
    • BCELoss pentru clasificare binară
    • Optimizatorul SGD
  • Iterare peste epoci și loturi de antrenare
  • Resetarea gradienților
  • Propagare înainte: obținerea ieșirilor modelului
  • Calculul pierderii
  • Calculul gradienților
  • Pasul optimizatorului: actualizarea parametrilor
Deep Learning intermediar cu PyTorch

Cum funcționează un optimizator


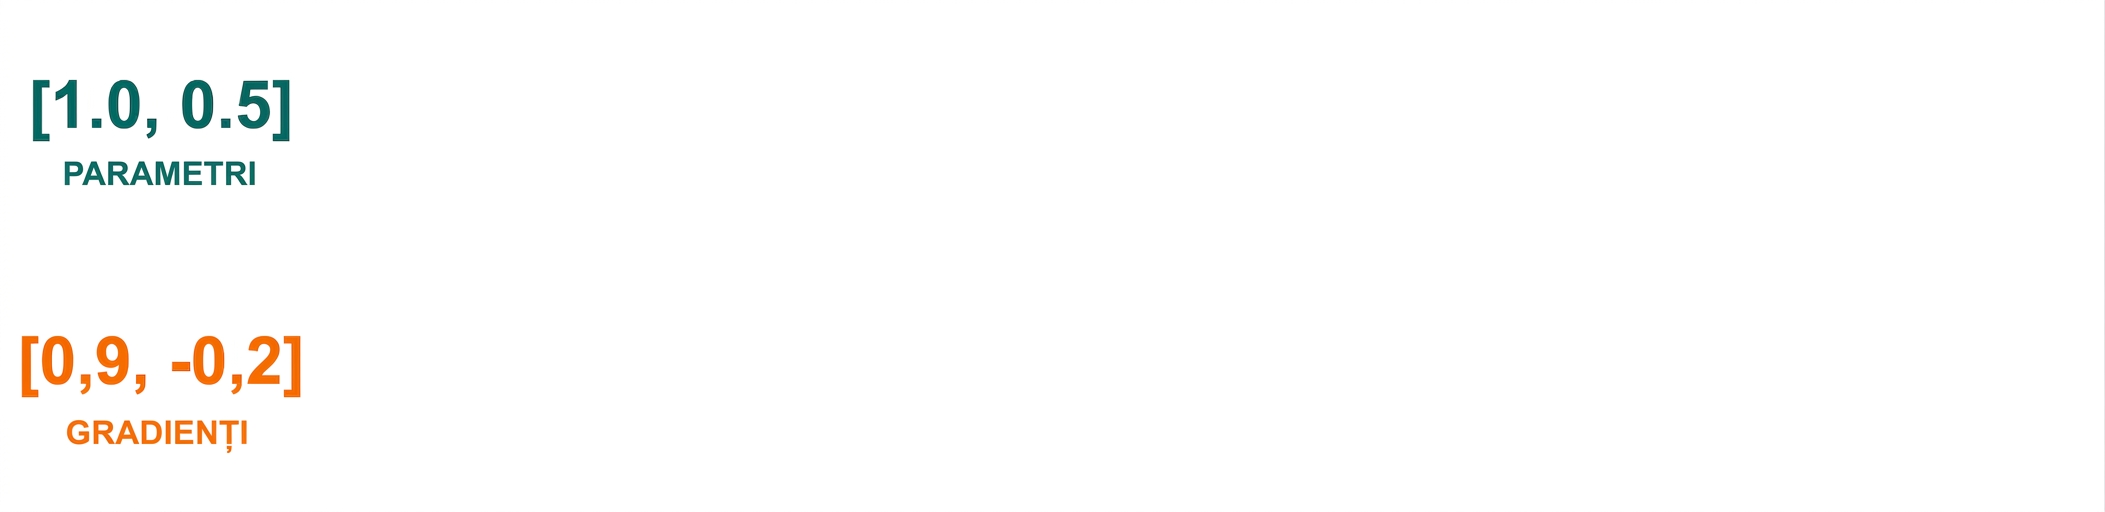
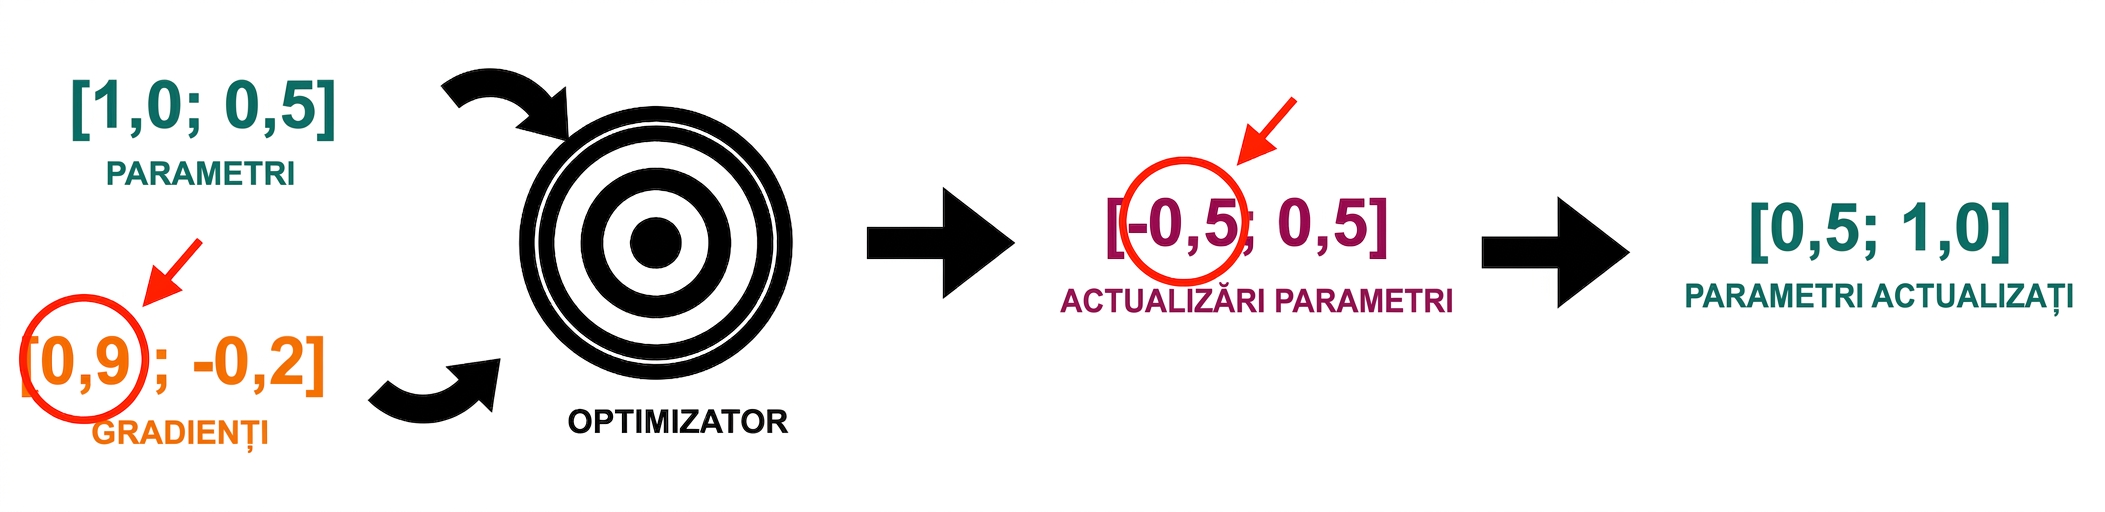
Doi vectori de lungime doi: unul cu valorile parametrilor (1 și 0.5), altul cu gradienții (0.9 și -0.2).

Deep Learning intermediar cu PyTorch

Cum funcționează un optimizator


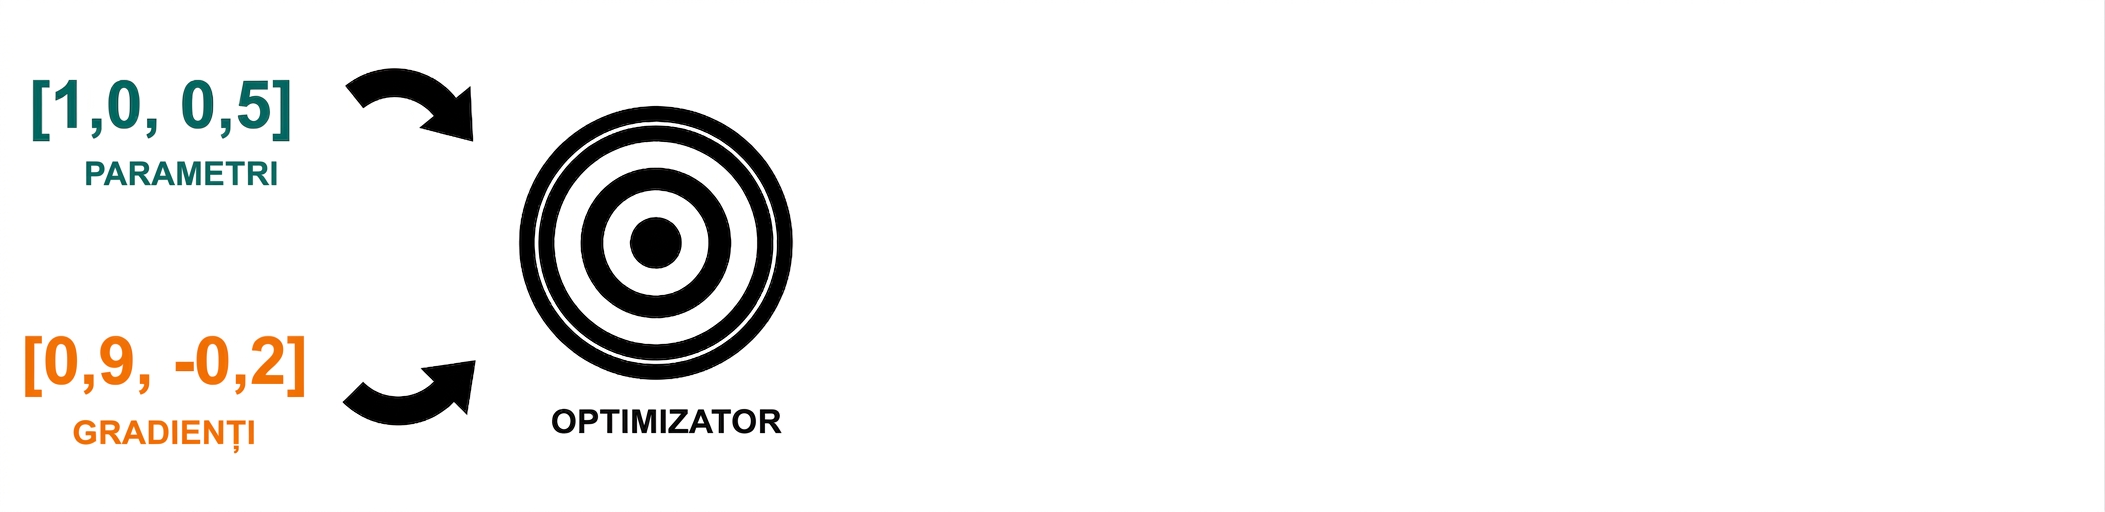
Săgețile indică modul în care cei doi vectori cu parametri și gradienți sunt transmisi optimizatorului, reprezentat ca o țintă.

Deep Learning intermediar cu PyTorch

Cum funcționează un optimizator


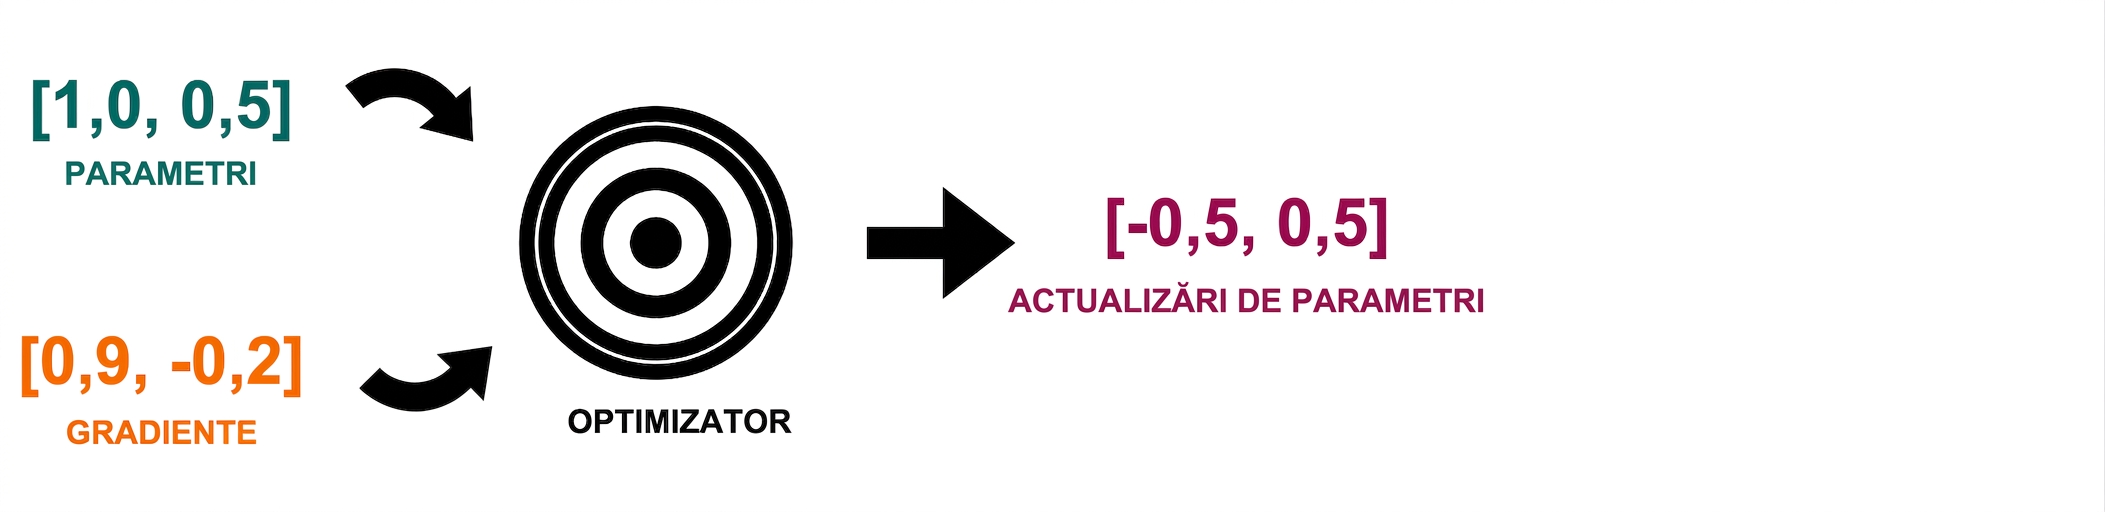
O săgeată de la optimizator indică un vector cu două actualizări ale parametrilor: -0.5 și 0.5.

Deep Learning intermediar cu PyTorch

Cum funcționează un optimizator


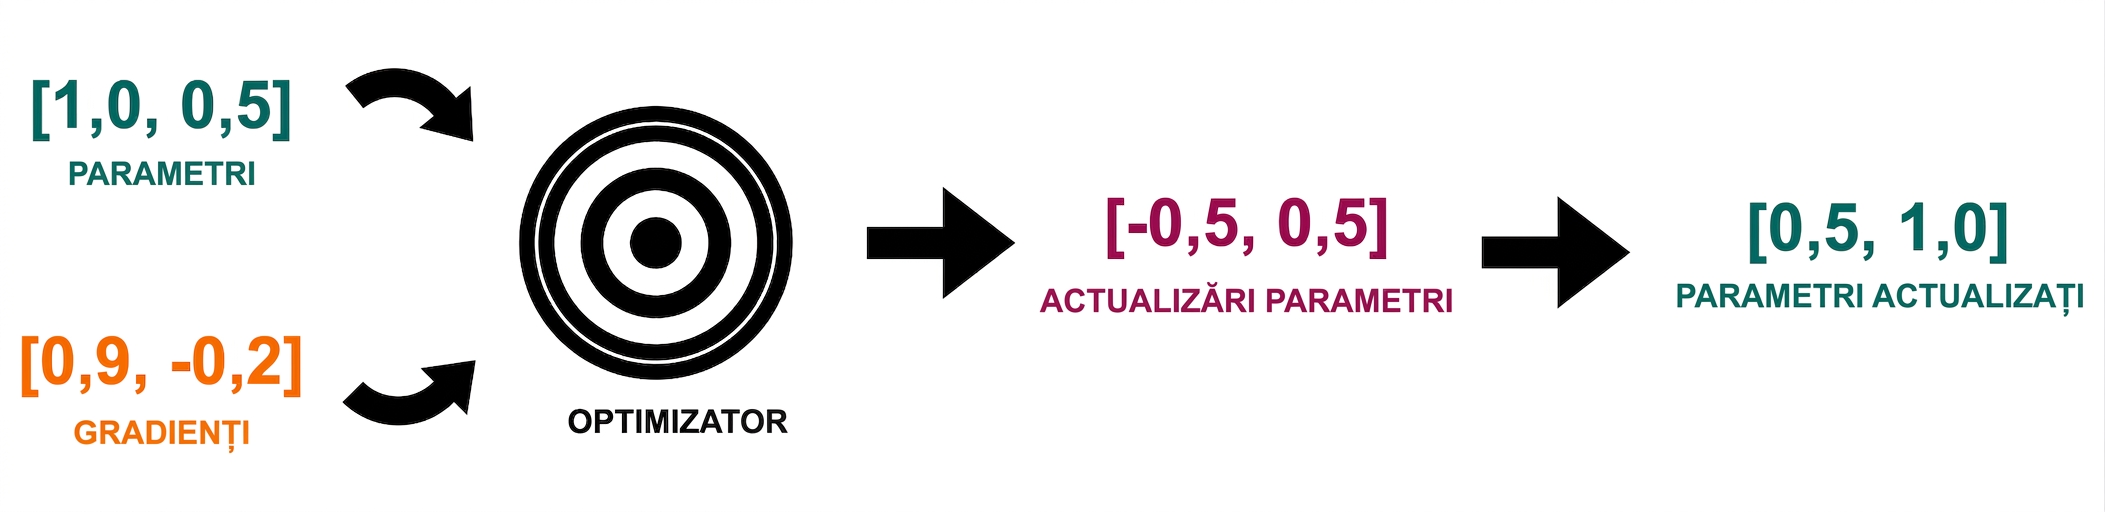
O săgeată de la actualizările parametrilor indică valorile actualizate ale parametrilor: 0.5 și 1.0

Deep Learning intermediar cu PyTorch

Cum funcționează un optimizator


O săgeată de la actualizările parametrilor indică valorile actualizate ale parametrilor: 0.5 și 1.0

Deep Learning intermediar cu PyTorch

Stochastic Gradient Descent (SGD)

optimizer = optim.SGD(net.parameters(), lr=0.01)
  • Actualizarea depinde de rata de învățare
  • Simplu și eficient, pentru modele de bază
  • Rar utilizat în practică
Deep Learning intermediar cu PyTorch

Adaptive Gradient (Adagrad)

optimizer = optim.Adagrad(net.parameters(), lr=0.01)
  • Adaptează rata de învățare pentru fiecare parametru
  • Potrivit pentru date rare
  • Poate reduce rata de învățare prea rapid
Deep Learning intermediar cu PyTorch

Root Mean Square Propagation (RMSprop)

optimizer = optim.RMSprop(net.parameters(), lr=0.01)
  • Actualizarea fiecărui parametru se bazează pe mărimea gradienților anteriori
Deep Learning intermediar cu PyTorch

Adaptive Moment Estimation (Adam)

optimizer = optim.Adam(net.parameters(), lr=0.01)
  • Considerat cel mai versatil și utilizat pe scară largă
  • RMSprop + momentul gradientului
  • Adesea ales ca optimizator implicit
Deep Learning intermediar cu PyTorch

Evaluarea modelului

from torchmetrics import Accuracy

acc = Accuracy(task="binary")


net.eval() with torch.no_grad(): for features, labels in dataloader_test:
outputs = net(features)
preds = (outputs >= 0.5).float()
acc(preds, labels.view(-1, 1))
accuracy = acc.compute() print(f"Accuracy: {accuracy}")
Accuracy: 0.6759443283081055
  • Configurarea metricii de acuratețe
  • Setarea modelului în modul de evaluare și iterarea peste loturile de test fără gradienți
  • Transmiterea datelor către model pentru probabilitățile prezise
  • Calculul etichetelor prezise
  • Actualizarea metricii de acuratețe
Deep Learning intermediar cu PyTorch

Să exersăm!

Deep Learning intermediar cu PyTorch

Preparing Video For Download...