Celulele LSTM și GRU

Deep Learning intermediar cu PyTorch

Michal Oleszak

Machine Learning Engineer

Problema memoriei de scurtă durată
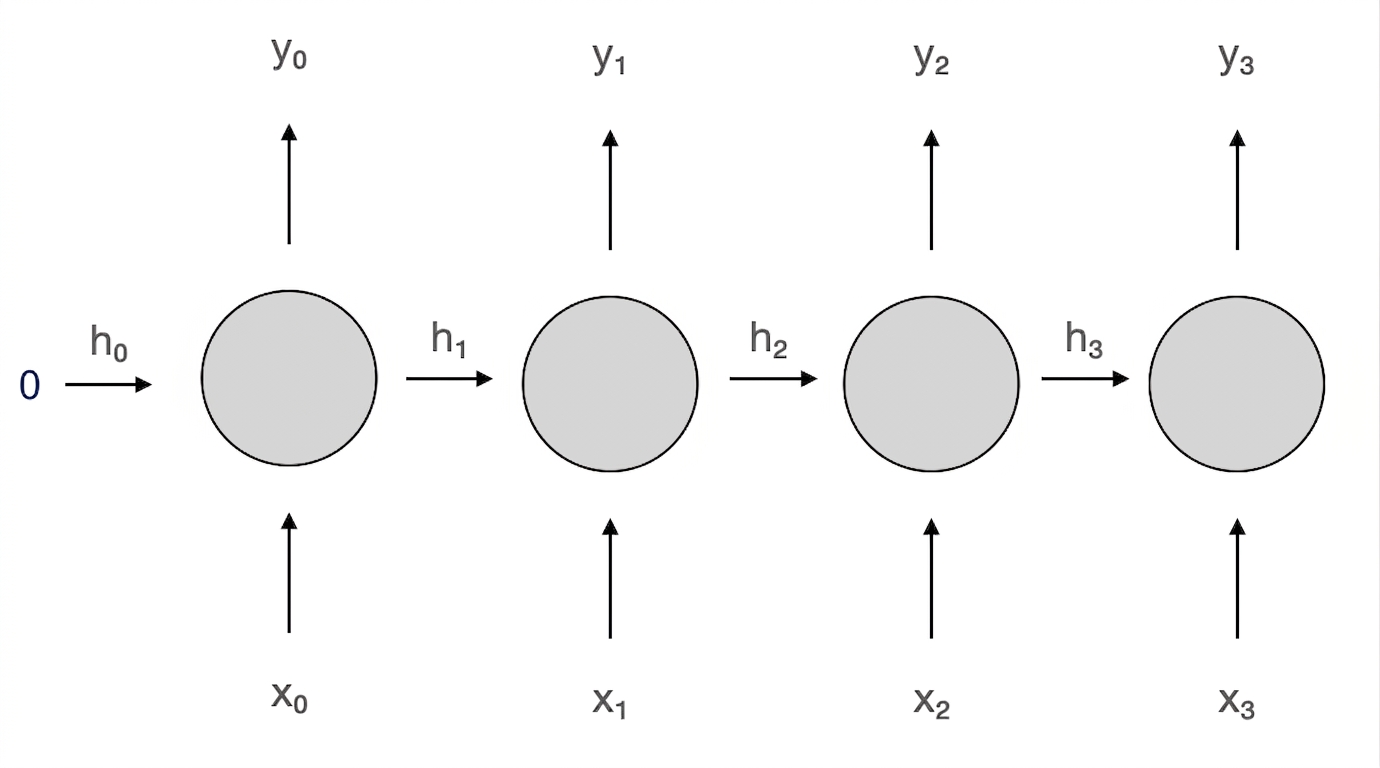
  • Celulele RNN mențin memoria prin starea ascunsă
  • Această memorie este de foarte scurtă durată
  • Două celule mai puternice rezolvă problema:
    • Celula LSTM (Long Short-Term Memory)
    • Celula GRU (Gated Recurrent Unit)

Schema neuronului recurrent. La pasul de timp 2, primește intrările h2 și x2 și produce ieșirile y2 și h3.

Deep Learning intermediar cu PyTorch

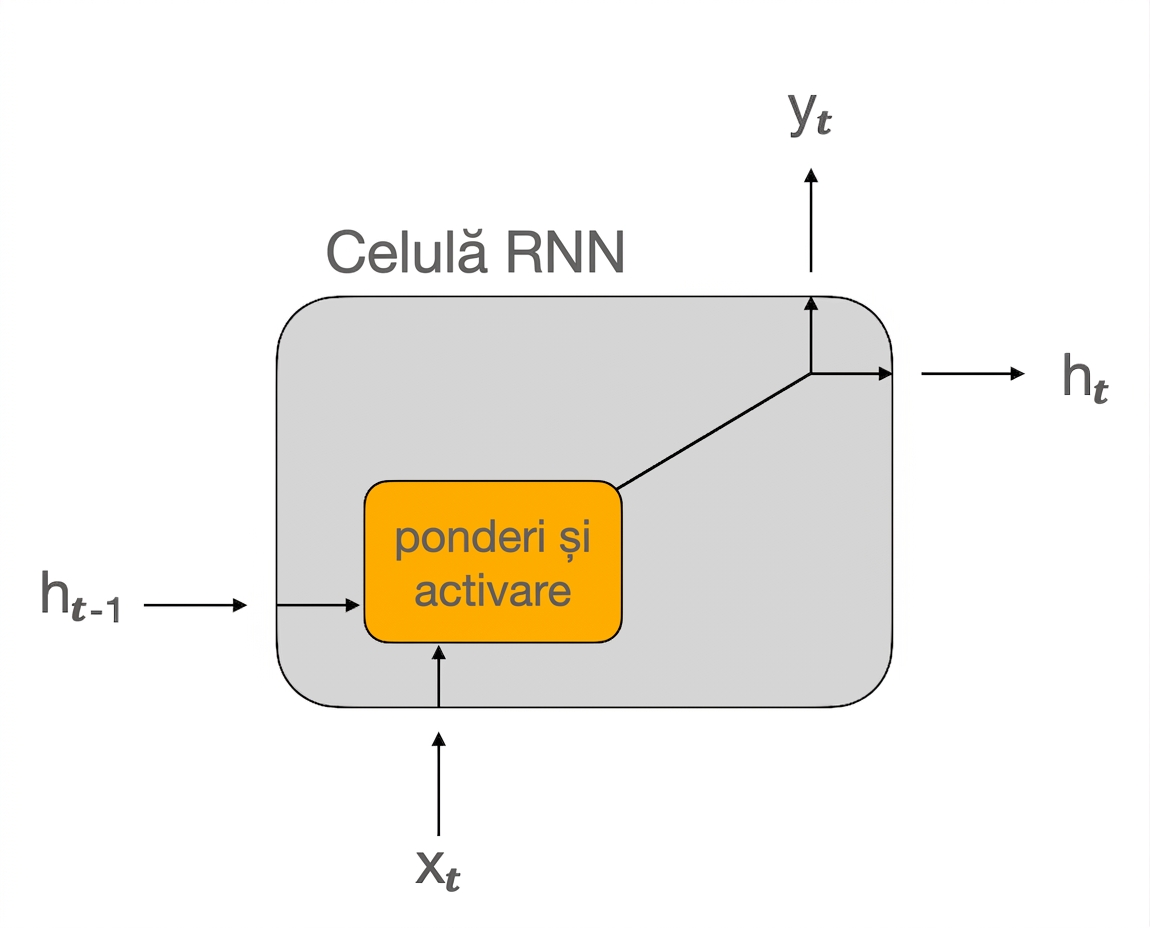
Celula RNN

Schema celulei RNN.

  • Două intrări:
    • date de intrare curente x
    • starea ascunsă anterioară h
  • Două ieșiri:
    • ieșirea curentă y
    • starea ascunsă următoare h
Deep Learning intermediar cu PyTorch

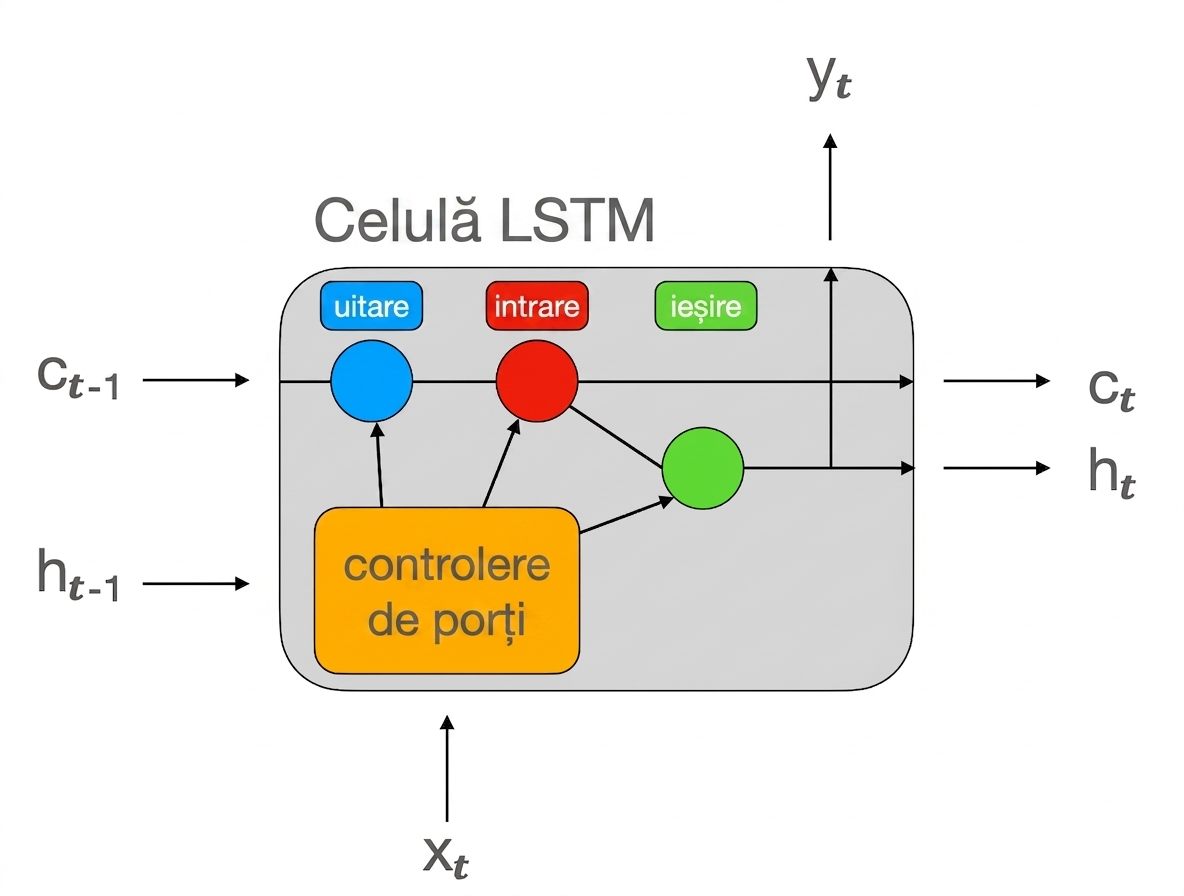
Celula LSTM

Schema celulei LSTM.

  • Ieșirile h și y sunt identice
  • Trei intrări și ieșiri (două stări ascunse):

    • h: stare pe termen scurt
    • c: stare pe termen lung
  • Trei "porți":

    • Poarta de uitare: ce se elimină din memoria pe termen lung
    • Poarta de intrare: ce se salvează în memoria pe termen lung
    • Poarta de ieșire: ce se returnează la pasul de timp curent
Deep Learning intermediar cu PyTorch

LSTM în PyTorch

class Net(nn.Module):
    def __init__(self, input_size):
        super().__init__()

self.lstm = nn.LSTM( input_size=1, hidden_size=32, num_layers=2, batch_first=True, ) self.fc = nn.Linear(32, 1)
def forward(self, x): h0 = torch.zeros(2, x.size(0), 32) c0 = torch.zeros(2, x.size(0), 32)
out, _ = self.lstm(x, (h0, c0))
out = self.fc(out[:, -1, :]) return out
  • __init__():
    • Înlocuiți nn.RNN cu nn.LSTM
  • forward():
    • Adăugați starea ascunsă c
    • Inițializați c și h cu zerouri
    • Transmiteți ambele stări ascunse stratului lstm
Deep Learning intermediar cu PyTorch

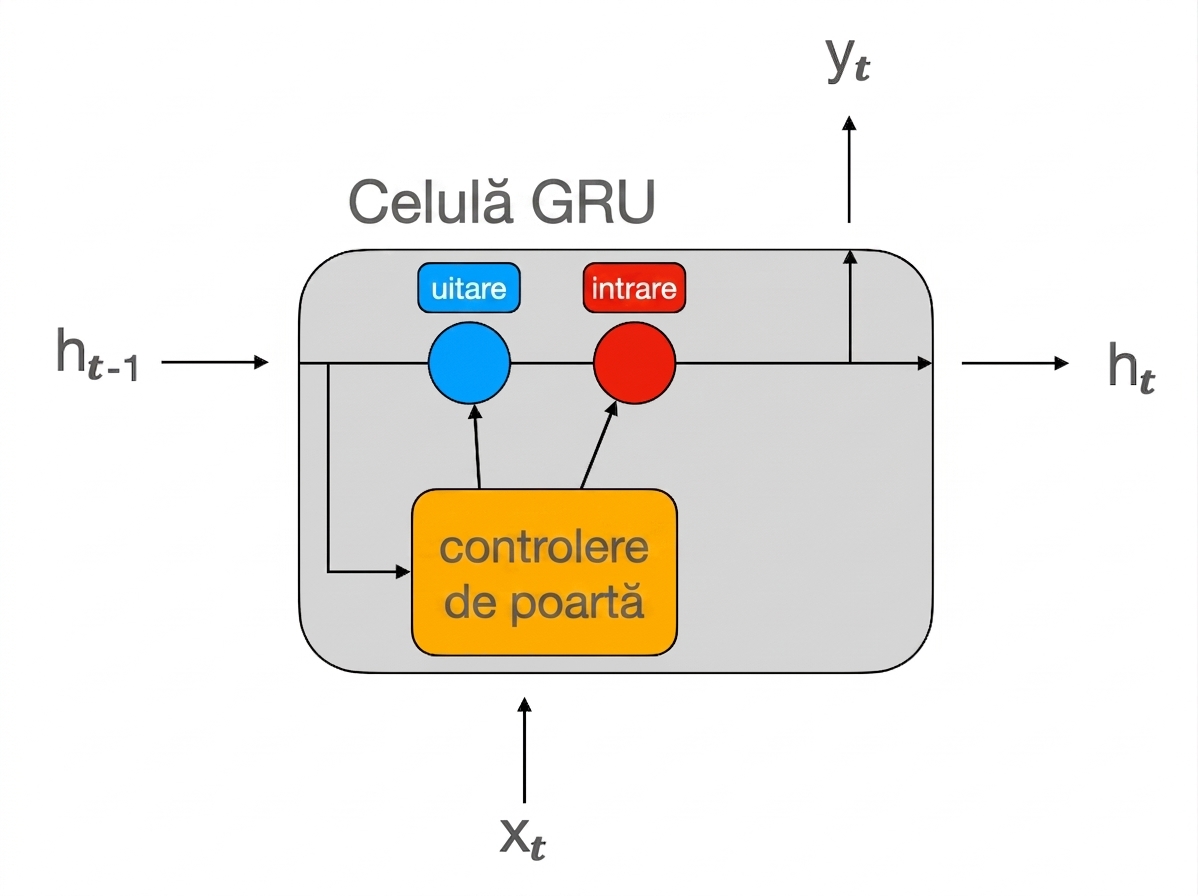
Celula GRU

Schema celulei GRU.

  • Versiune simplificată a celulei LSTM
  • O singură stare ascunsă
  • Fără poartă de ieșire
Deep Learning intermediar cu PyTorch

GRU în PyTorch

class Net(nn.Module):
    def __init__(self, input_size):
        super().__init__()

self.gru = nn.GRU( input_size=1, hidden_size=32, num_layers=2, batch_first=True, ) self.fc = nn.Linear(32, 1)
def forward(self, x): h0 = torch.zeros(2, x.size(0), 32) out, _ = self.gru(x, h0) out = self.fc(out[:, -1, :]) return out
  • __init__():
    • Înlocuiți nn.RNN cu nn.GRU
  • forward():
    • Utilizați stratul gru
Deep Learning intermediar cu PyTorch

RNN, LSTM sau GRU?

  • RNN nu mai este folosit frecvent
  • GRU este mai simplu decât LSTM = calcul redus
  • Performanța relativă variază în funcție de caz
  • Testați ambele și comparați

Schemele celulelor LSTM și GRU.

Deep Learning intermediar cu PyTorch

Să exersăm!

Deep Learning intermediar cu PyTorch

Preparing Video For Download...