Gradienți care dispar și explodează

Deep Learning intermediar cu PyTorch

Michal Oleszak

Machine Learning Engineer

Gradienți care dispar
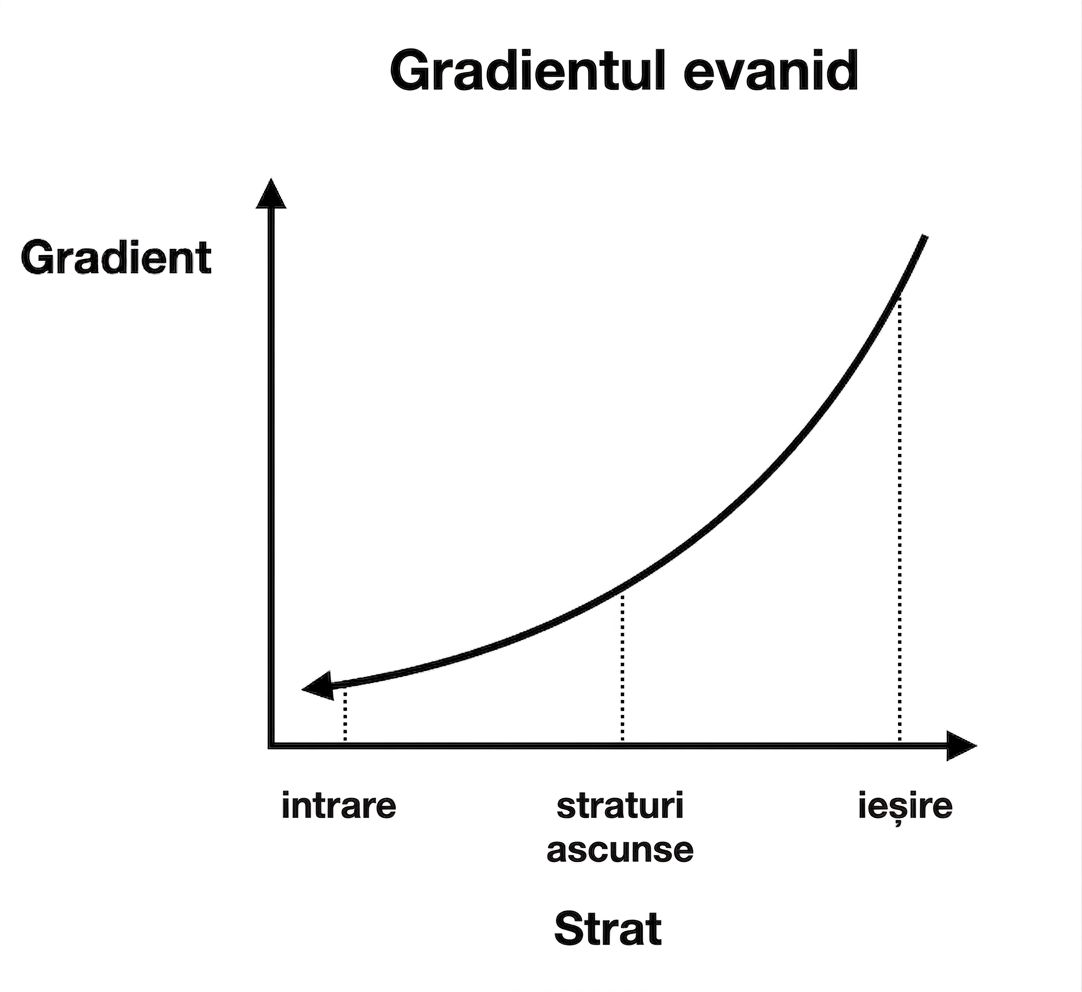
  • Gradienții devin din ce în ce mai mici în backpropagation
  • Straturile timpurii primesc actualizări mici ale parametrilor
  • Modelul nu învață

Grafice care arată mărimea gradientului în funcție de indexul stratului: pentru straturile timpurii, gradienții sunt mai mici

Deep Learning intermediar cu PyTorch

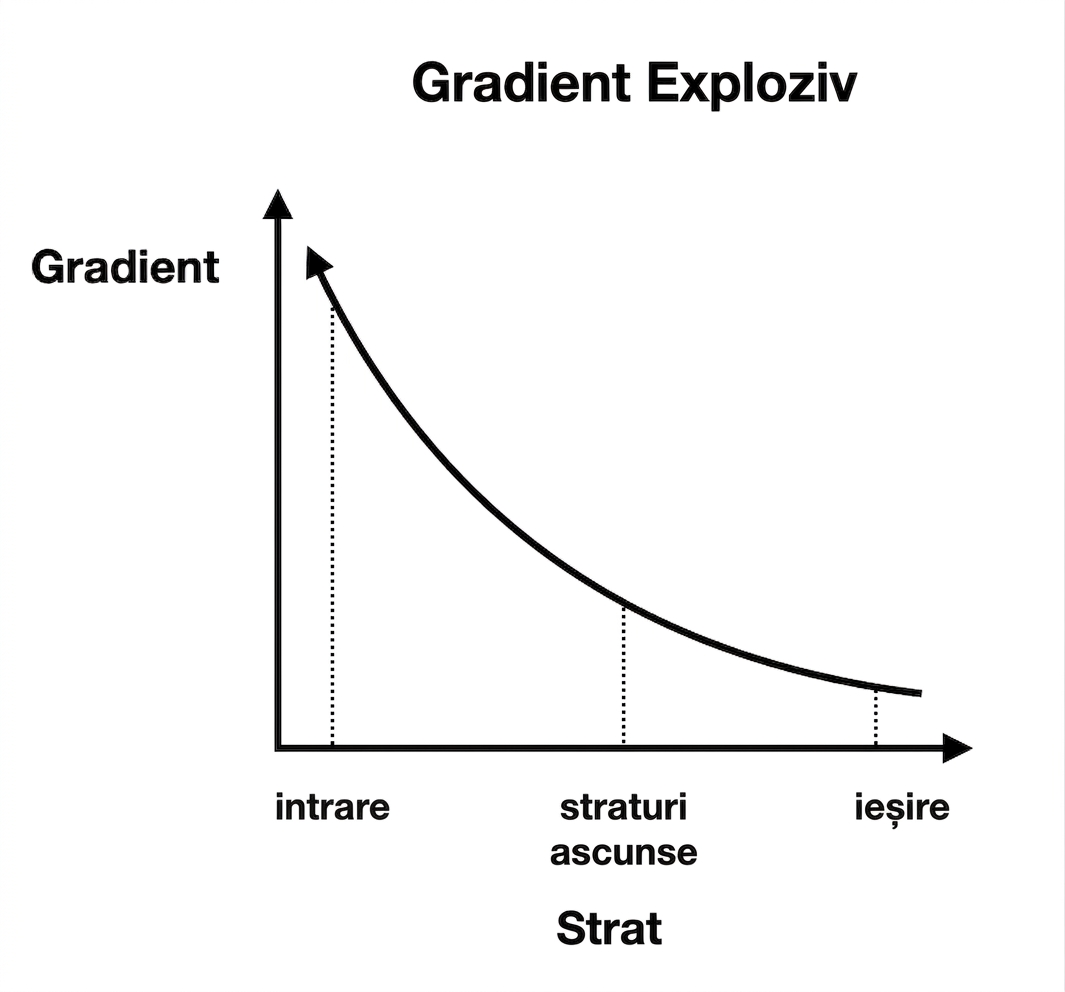
Gradienți care explodează

  • Gradienții devin din ce în ce mai mari
  • Actualizările parametrilor sunt prea mari
  • Antrenarea diverge

Grafice care arată mărimea gradientului în funcție de indexul stratului: pentru straturile timpurii, gradienții sunt mai mari

Deep Learning intermediar cu PyTorch

Soluții pentru gradienți instabili

  1. Inițializare corectă a ponderilor
  2. Activări potrivite
  3. Normalizare pe lot


Trei pași

Deep Learning intermediar cu PyTorch

Inițializarea ponderilor

layer = nn.Linear(8, 1)
print(layer.weight)
Parameter containing:
tensor([[-0.0195,  0.0992,  0.0391,  0.0212,
         -0.3386, -0.1892, -0.3170,  0.2148]])
Deep Learning intermediar cu PyTorch

Inițializarea ponderilor

O inițializare bună asigură:

  • Varianța intrărilor = varianța ieșirilor unui strat
  • Varianța gradienților identică înainte și după un strat


Depinde de funcția de activare:

  • Pentru ReLU și similare, se folosește inițializarea He/Kaiming
Deep Learning intermediar cu PyTorch

Inițializarea ponderilor

import torch.nn.init as init

init.kaiming_uniform_(layer.weight)
print(layer.weight)
Parameter containing:
tensor([[-0.3063, -0.2410,  0.0588,  0.2664,
          0.0502, -0.0136,  0.2274,  0.0901]])
Deep Learning intermediar cu PyTorch

Inițializarea He / Kaiming

init.kaiming_uniform_(self.fc1.weight)
init.kaiming_uniform_(self.fc2.weight)
init.kaiming_uniform_(
  self.fc3.weight,
  nonlinearity="sigmoid",
)
Deep Learning intermediar cu PyTorch

Inițializarea He / Kaiming

import torch.nn as nn
import torch.nn.init as init

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.fc2 = nn.Linear(16, 8)
        self.fc3 = nn.Linear(8, 1)


init.kaiming_uniform_(self.fc1.weight) init.kaiming_uniform_(self.fc2.weight) init.kaiming_uniform_( self.fc3.weight, nonlinearity="sigmoid", )


    def forward(self, x):
        x = nn.functional.relu(self.fc1(x))
        x = nn.functional.relu(self.fc2(x))
        x = nn.functional.sigmoid(self.fc3(x))
        return x


Deep Learning intermediar cu PyTorch

Funcții de activare

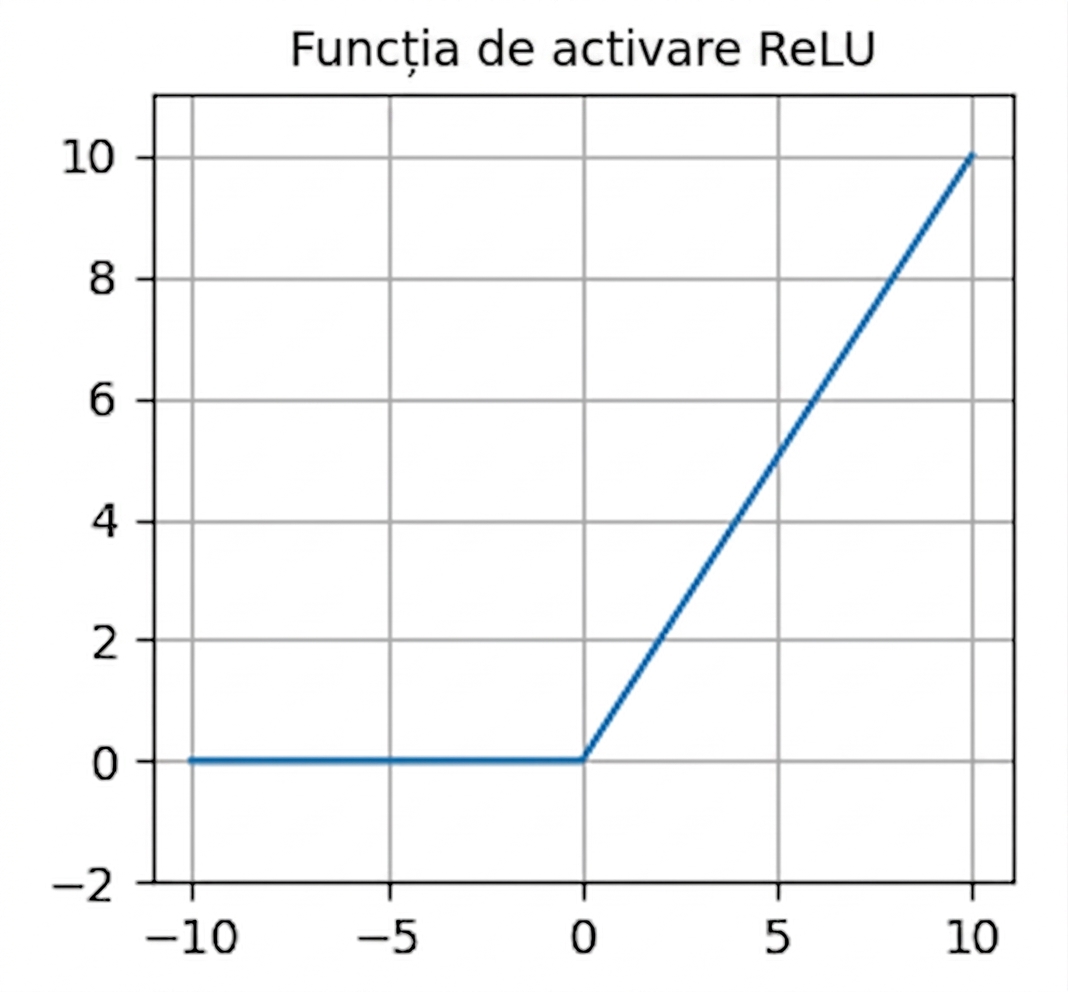
Grafic al funcției ReLU. Sub zero, linia este orizontală; deasupra zero, are o pantă pozitivă.

  • Folosită adesea ca activare implicită
  • nn.functional.relu()
  • Zero pentru valori negative — neuroni inactivi
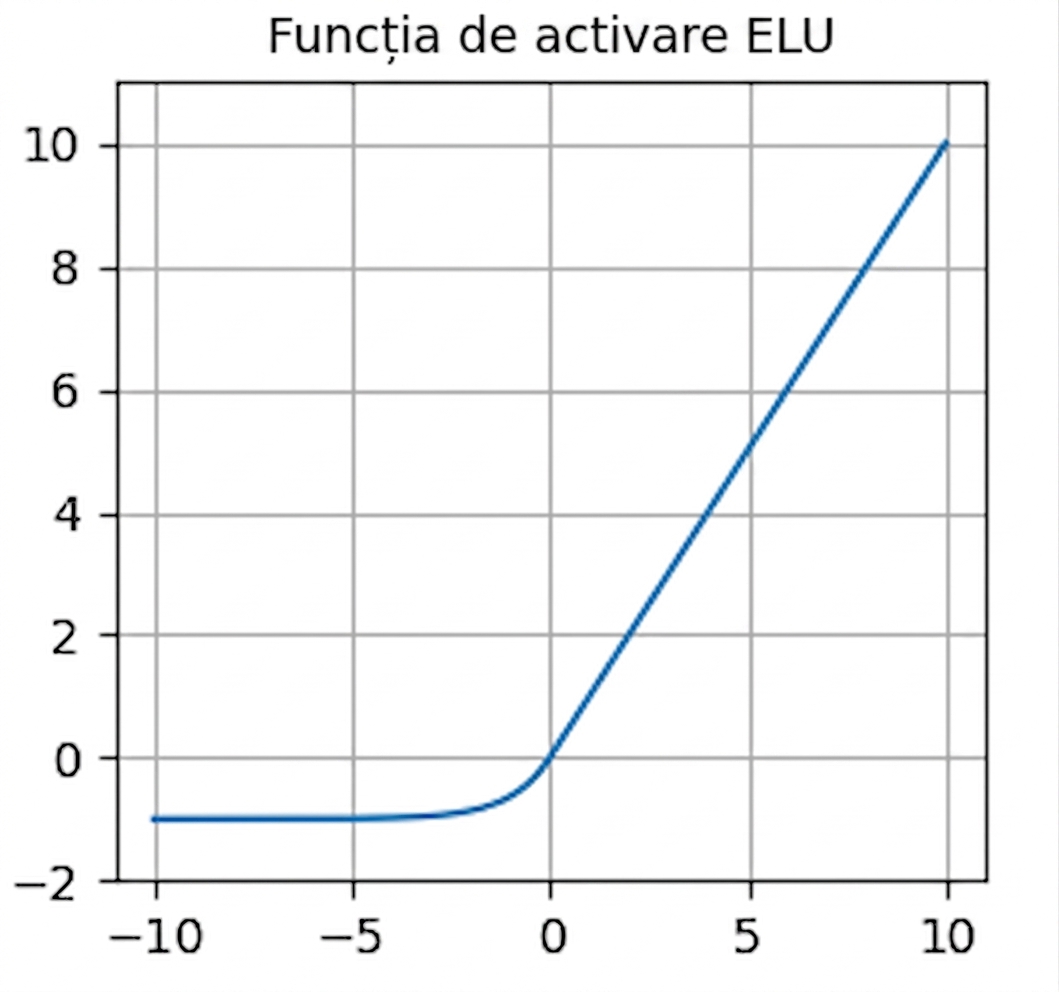
Grafic al funcției ELU. Similară cu ReLU, dar cu o tranziție netedă și curbată din zona negativă spre cea pozitivă.

  • nn.functional.elu()
  • Gradienți nenuli pentru valori negative — reduce neuronii inactivi
  • Ieșire medie aproape de zero — ajută împotriva gradienților care dispar
Deep Learning intermediar cu PyTorch

Normalizare pe lot

După un strat:

  1. Normalizarea ieșirilor stratului prin:

    • Scăderea mediei
    • Împărțirea la deviația standard
  2. Scalarea și deplasarea ieșirilor normalizate cu parametri învățați

Modelul învață distribuția optimă a intrărilor pentru fiecare strat:

  • Scădere mai rapidă a pierderii
  • Ajută împotriva gradienților instabili
Deep Learning intermediar cu PyTorch

Normalizare pe lot

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.bn1 = nn.BatchNorm1d(16)

        ...


def forward(self, x): x = self.fc1(x) x = self.bn1(x) x = nn.functional.elu(x) ...
Deep Learning intermediar cu PyTorch

Să exersăm!

Deep Learning intermediar cu PyTorch

Preparing Video For Download...