Optimizarea AI pentru viteză, cost și calitate
Programare asistată de AI pentru dezvoltatori
Francesca Donadoni
AI Curriculum Manager, DataCamp
Metrici
Latență
(timp de răspuns): Timpul necesar modelului pentru a genera un răspuns
Metrici
Latență
(timp de răspuns): Timpul necesar modelului pentru a genera un răspuns
$$
Costul tokenilor
(per 1M tokeni): Costul monetar al utilizării unui model AI
Metrici
Latență
(timp de răspuns): Timpul necesar modelului pentru a genera un răspuns
$$
Costul tokenilor
(per 1M tokeni): Costul monetar al utilizării unui model AI
$$
Calitate
(rata de succes a testelor/acoperire): Frecvența cu care codul generat funcționează conform așteptărilor
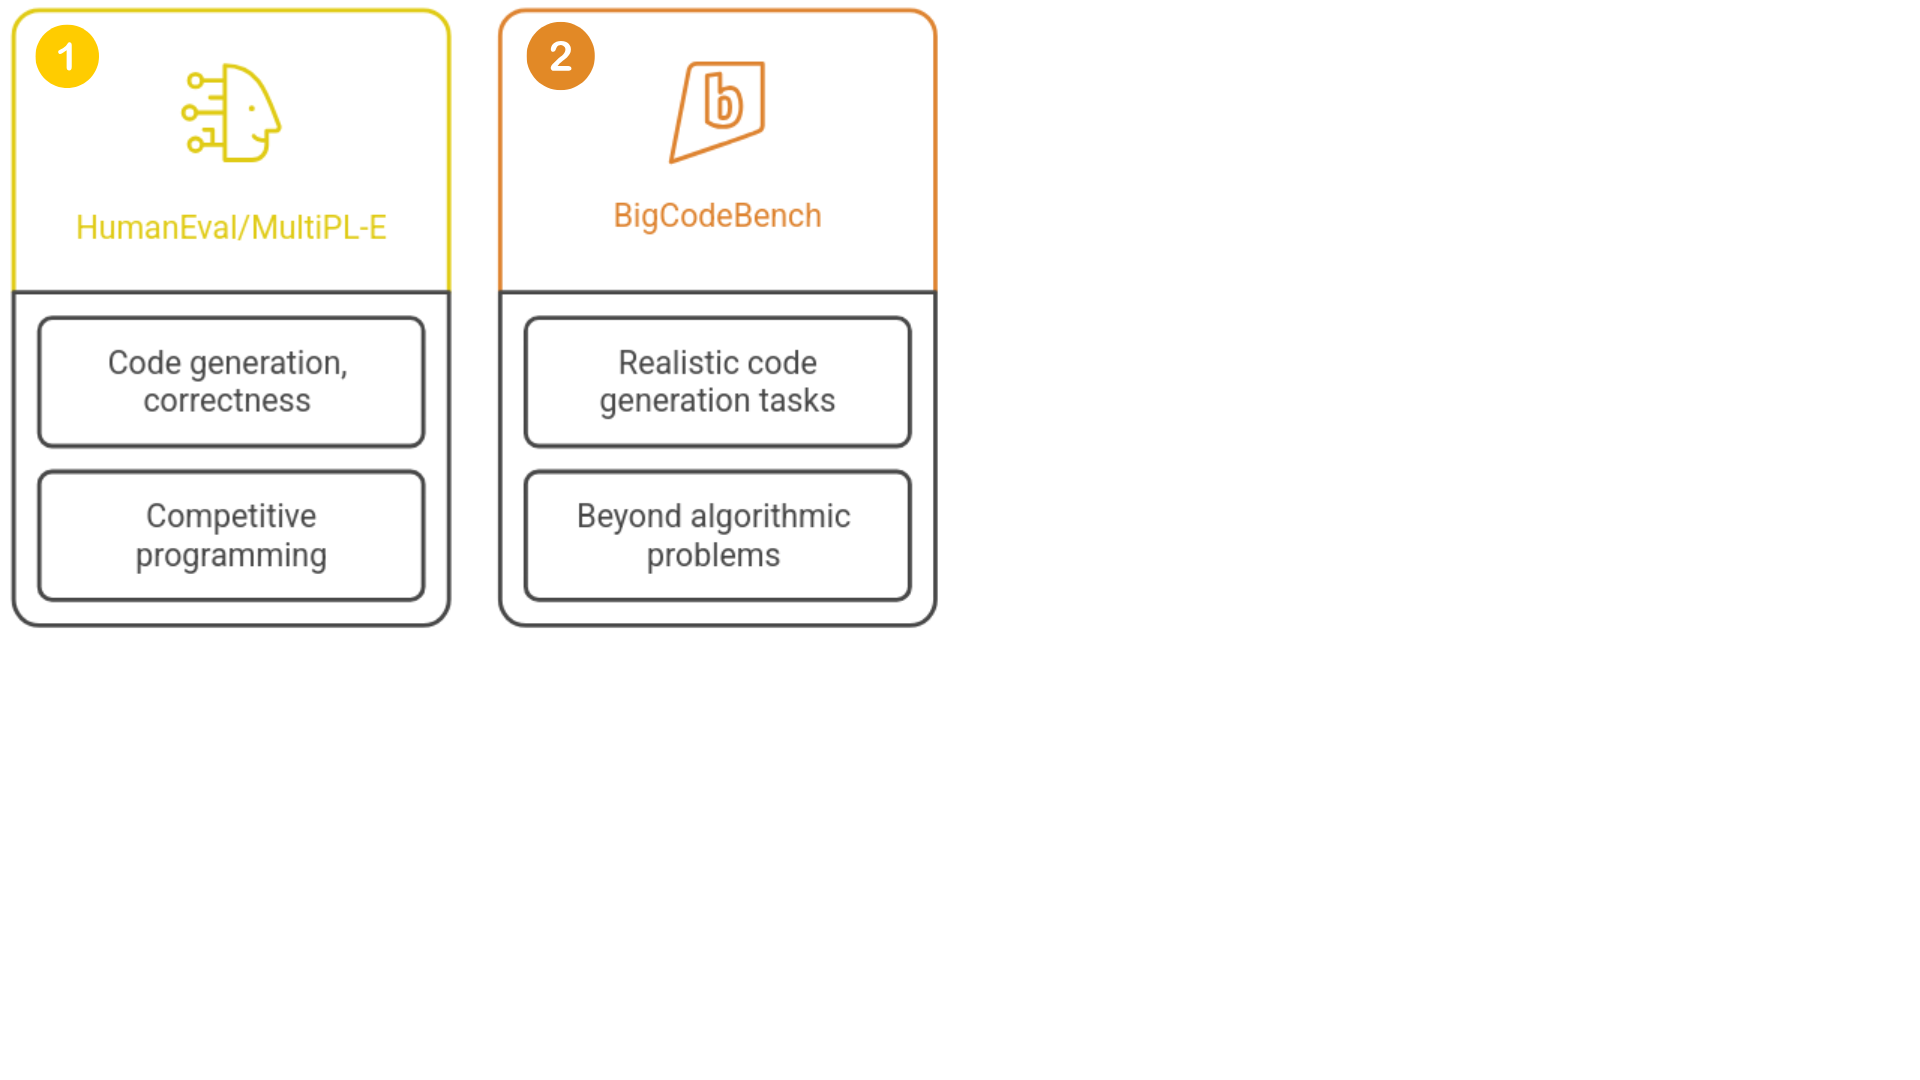
Benchmarking modele
$$
1
https://github.com/openai/human-eval
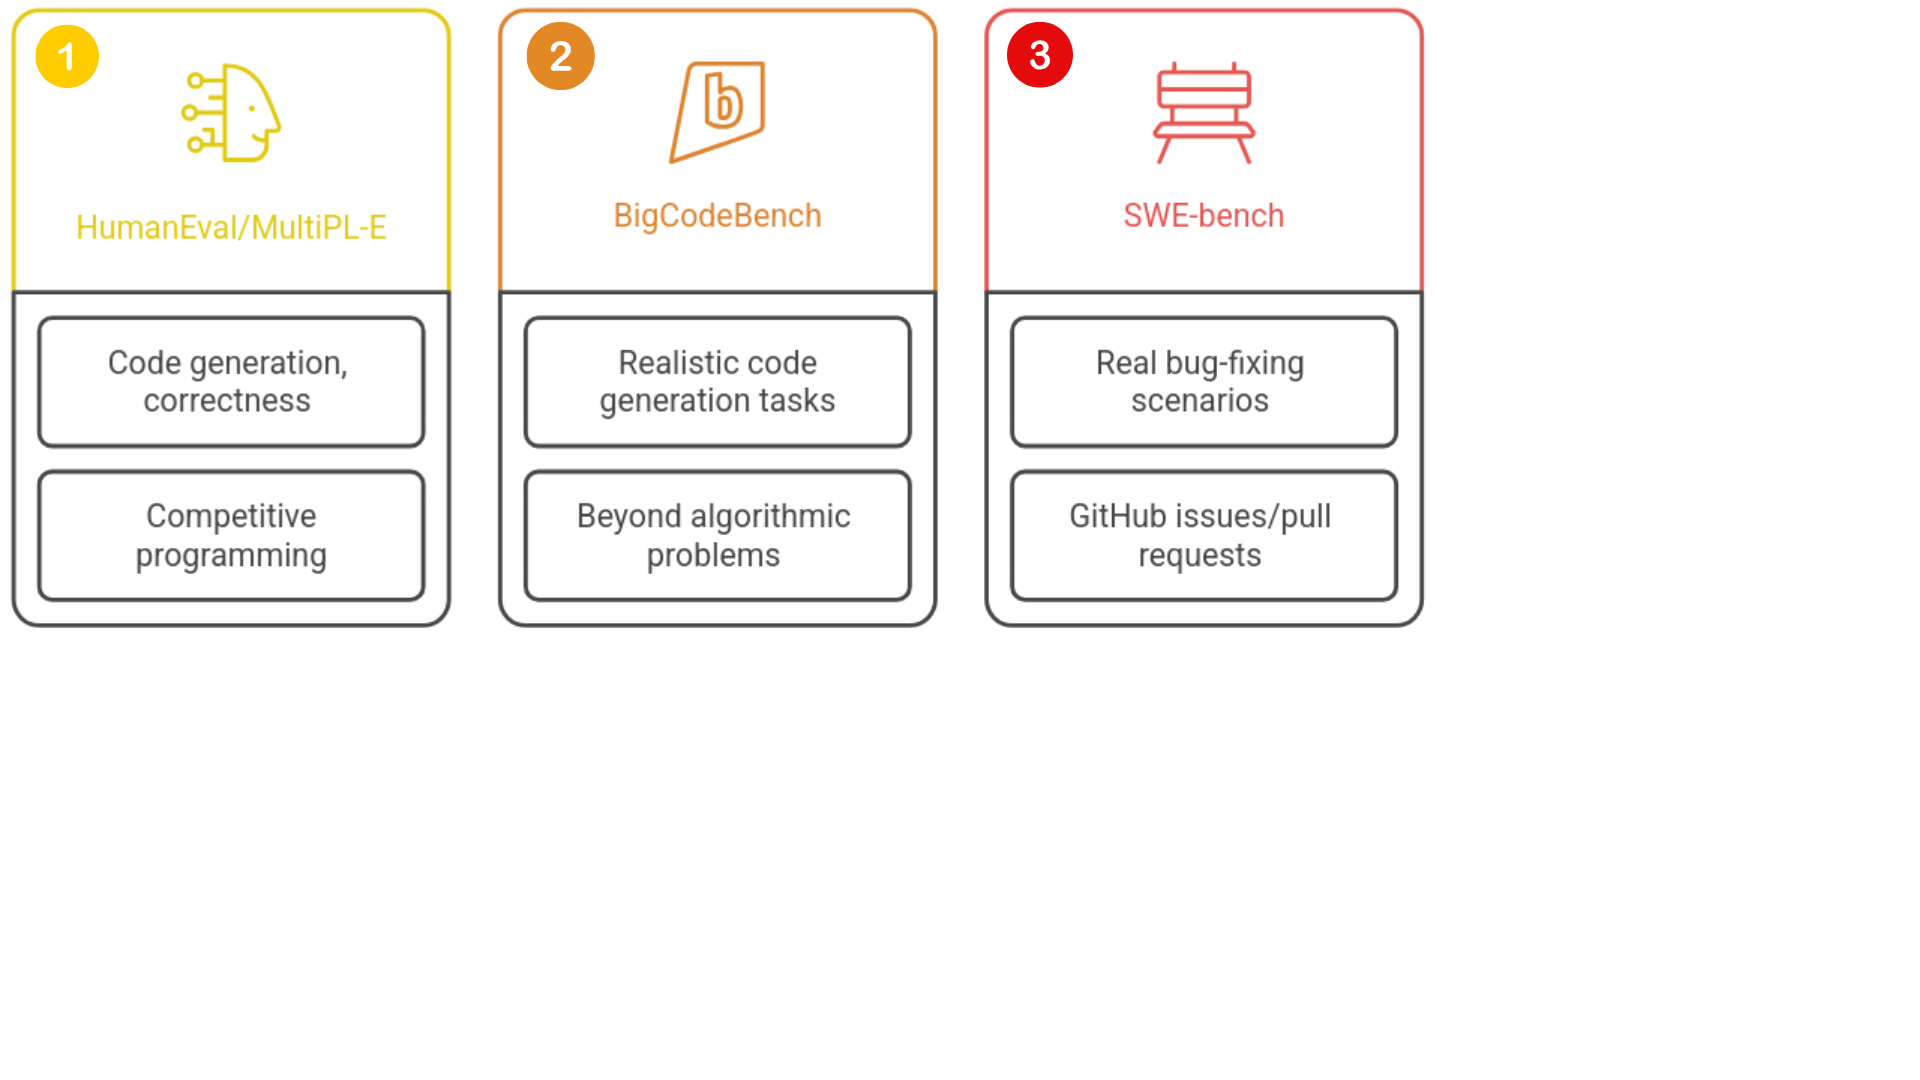
Benchmarking modele
$$
1
https://github.com/bigcode-project/bigcodebench
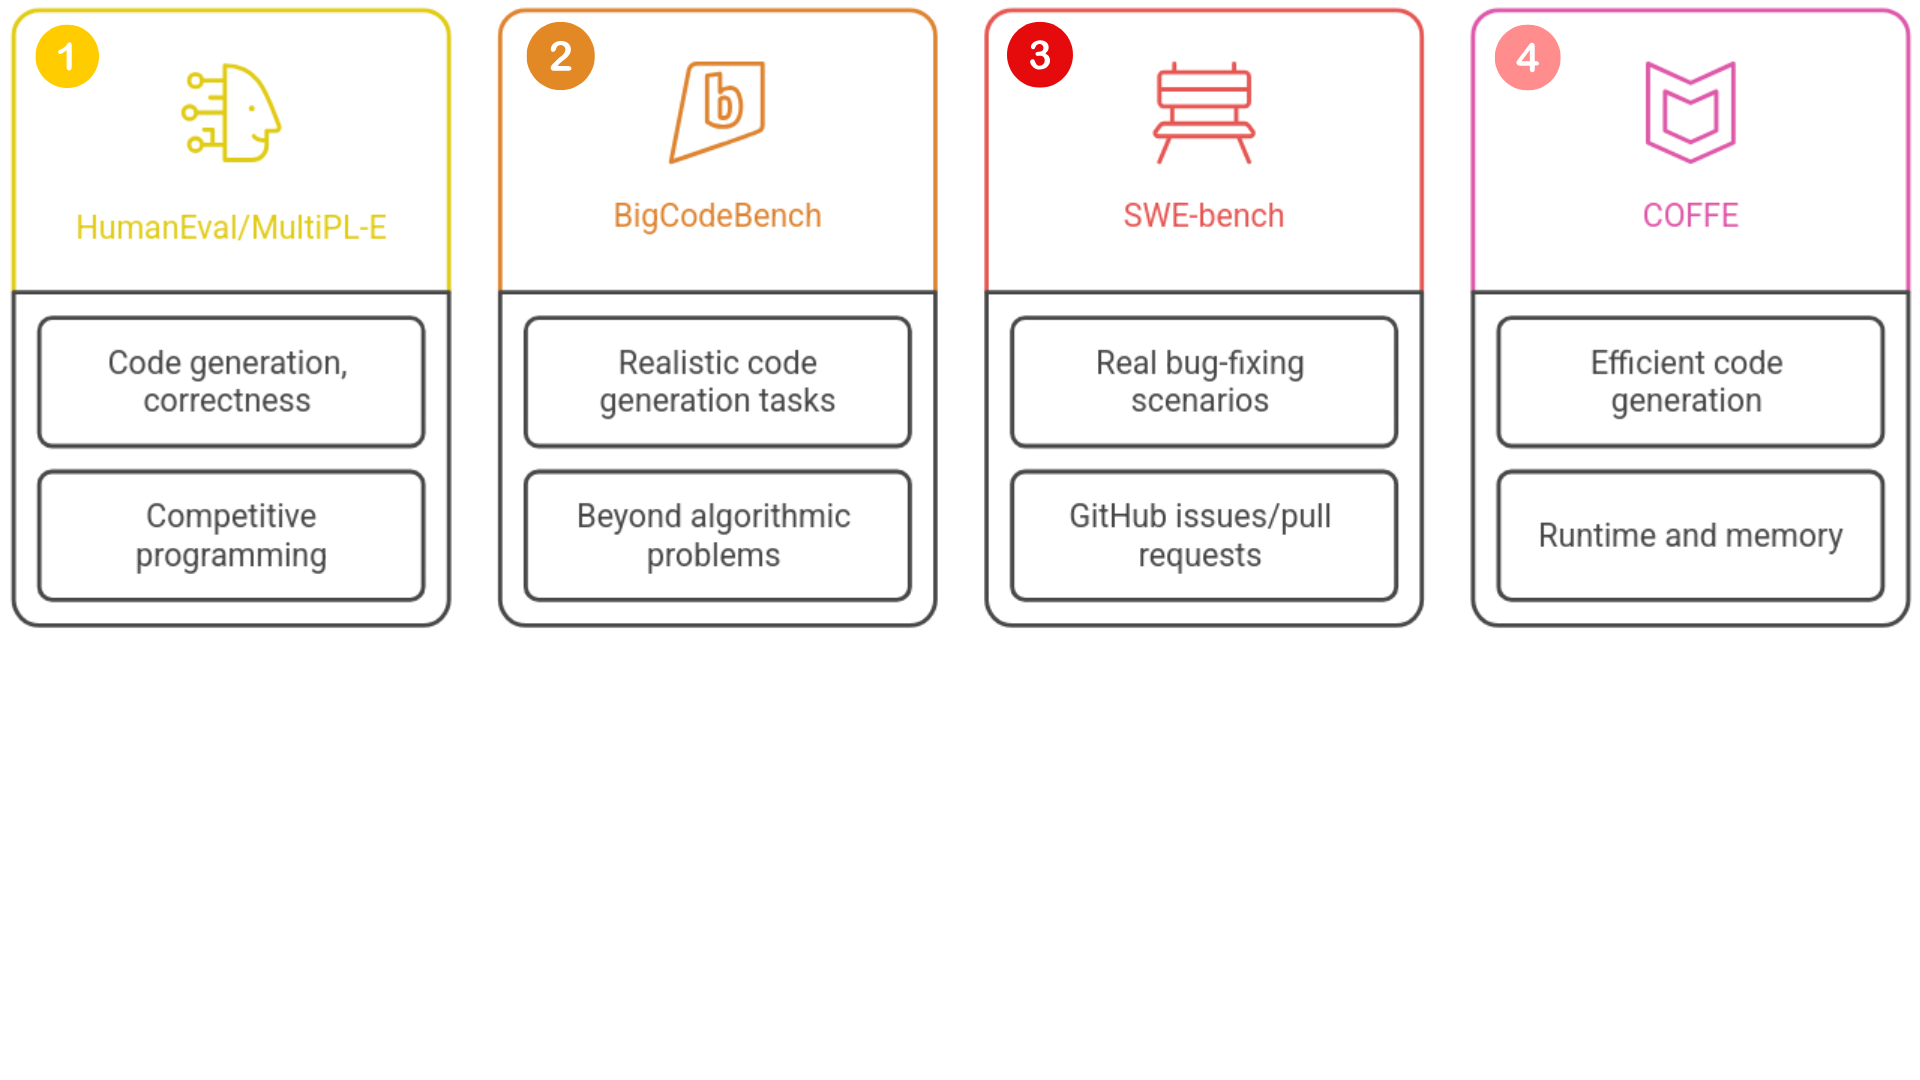
Benchmarking modele
$$
1
https://github.com/SWE-bench/SWE-bench
Benchmarking modele
$$
1
https://github.com/JohnnyPeng18/Coffe
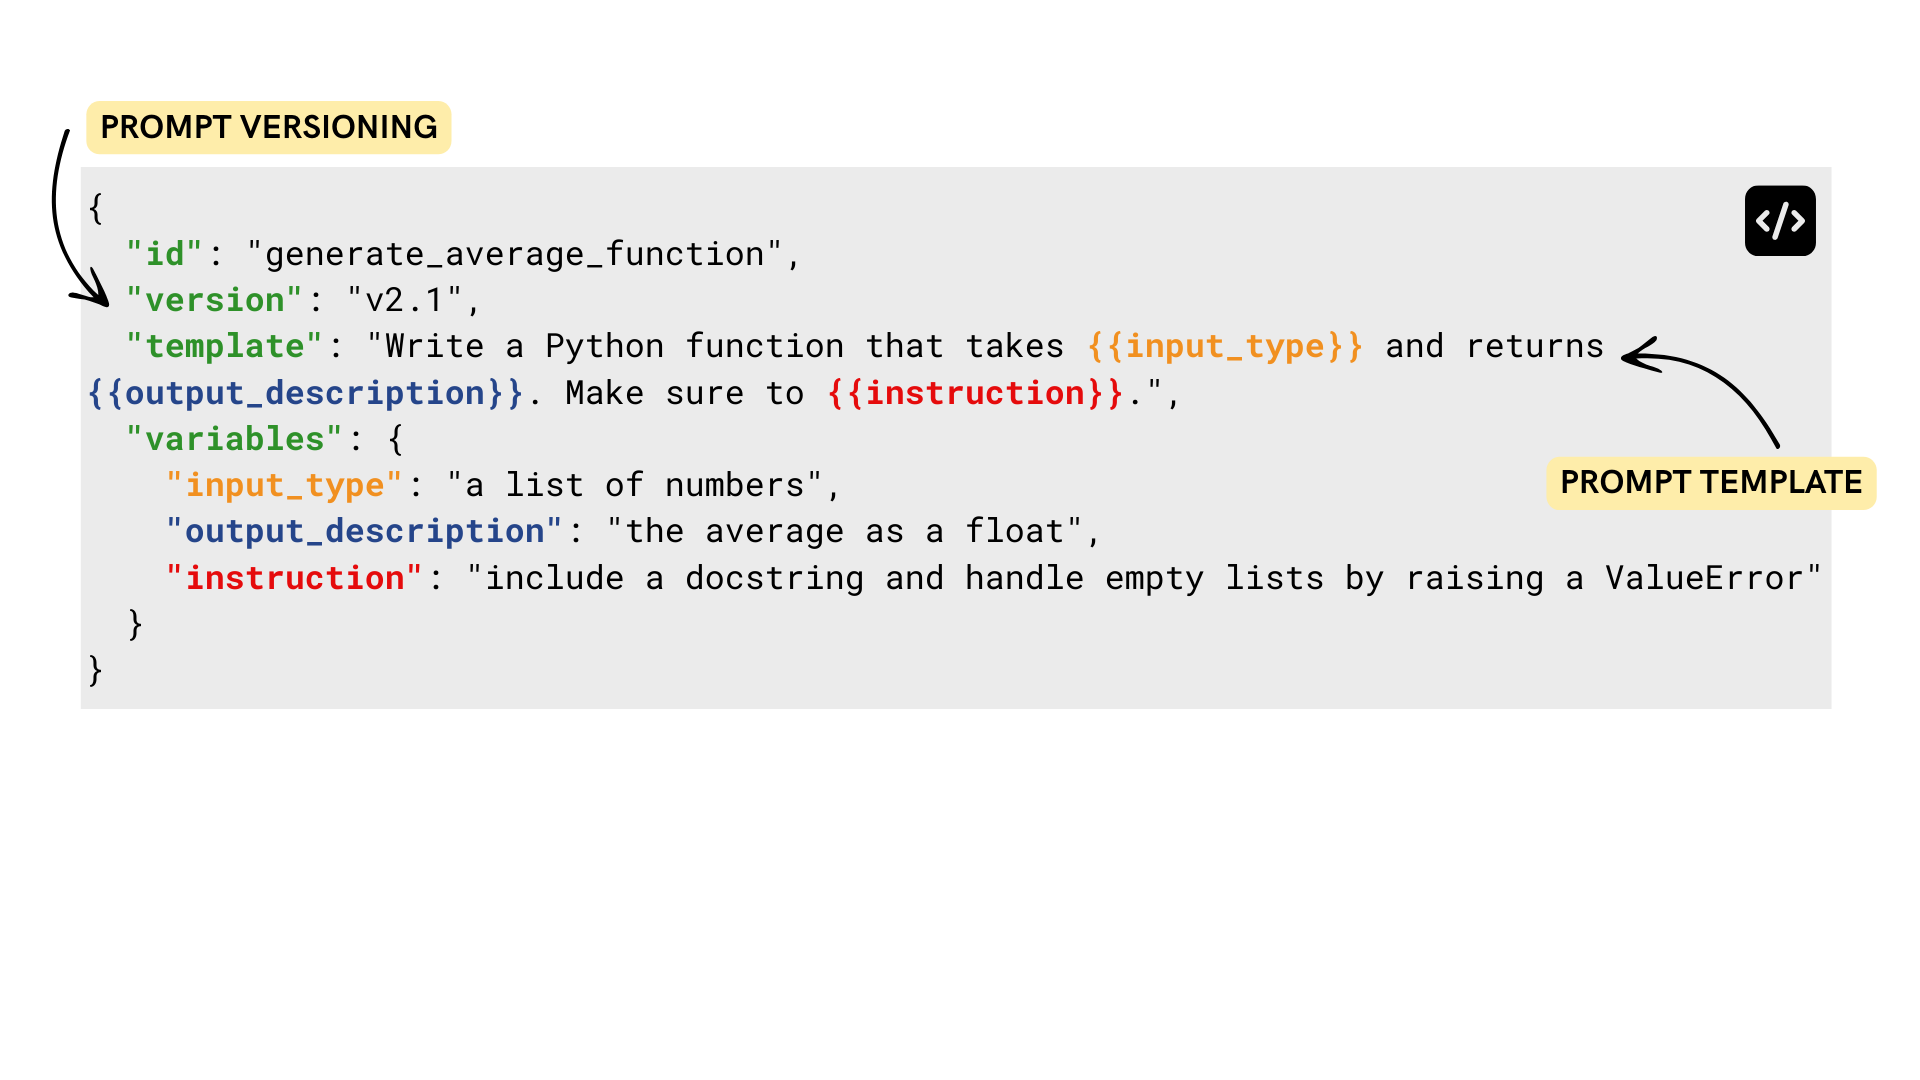
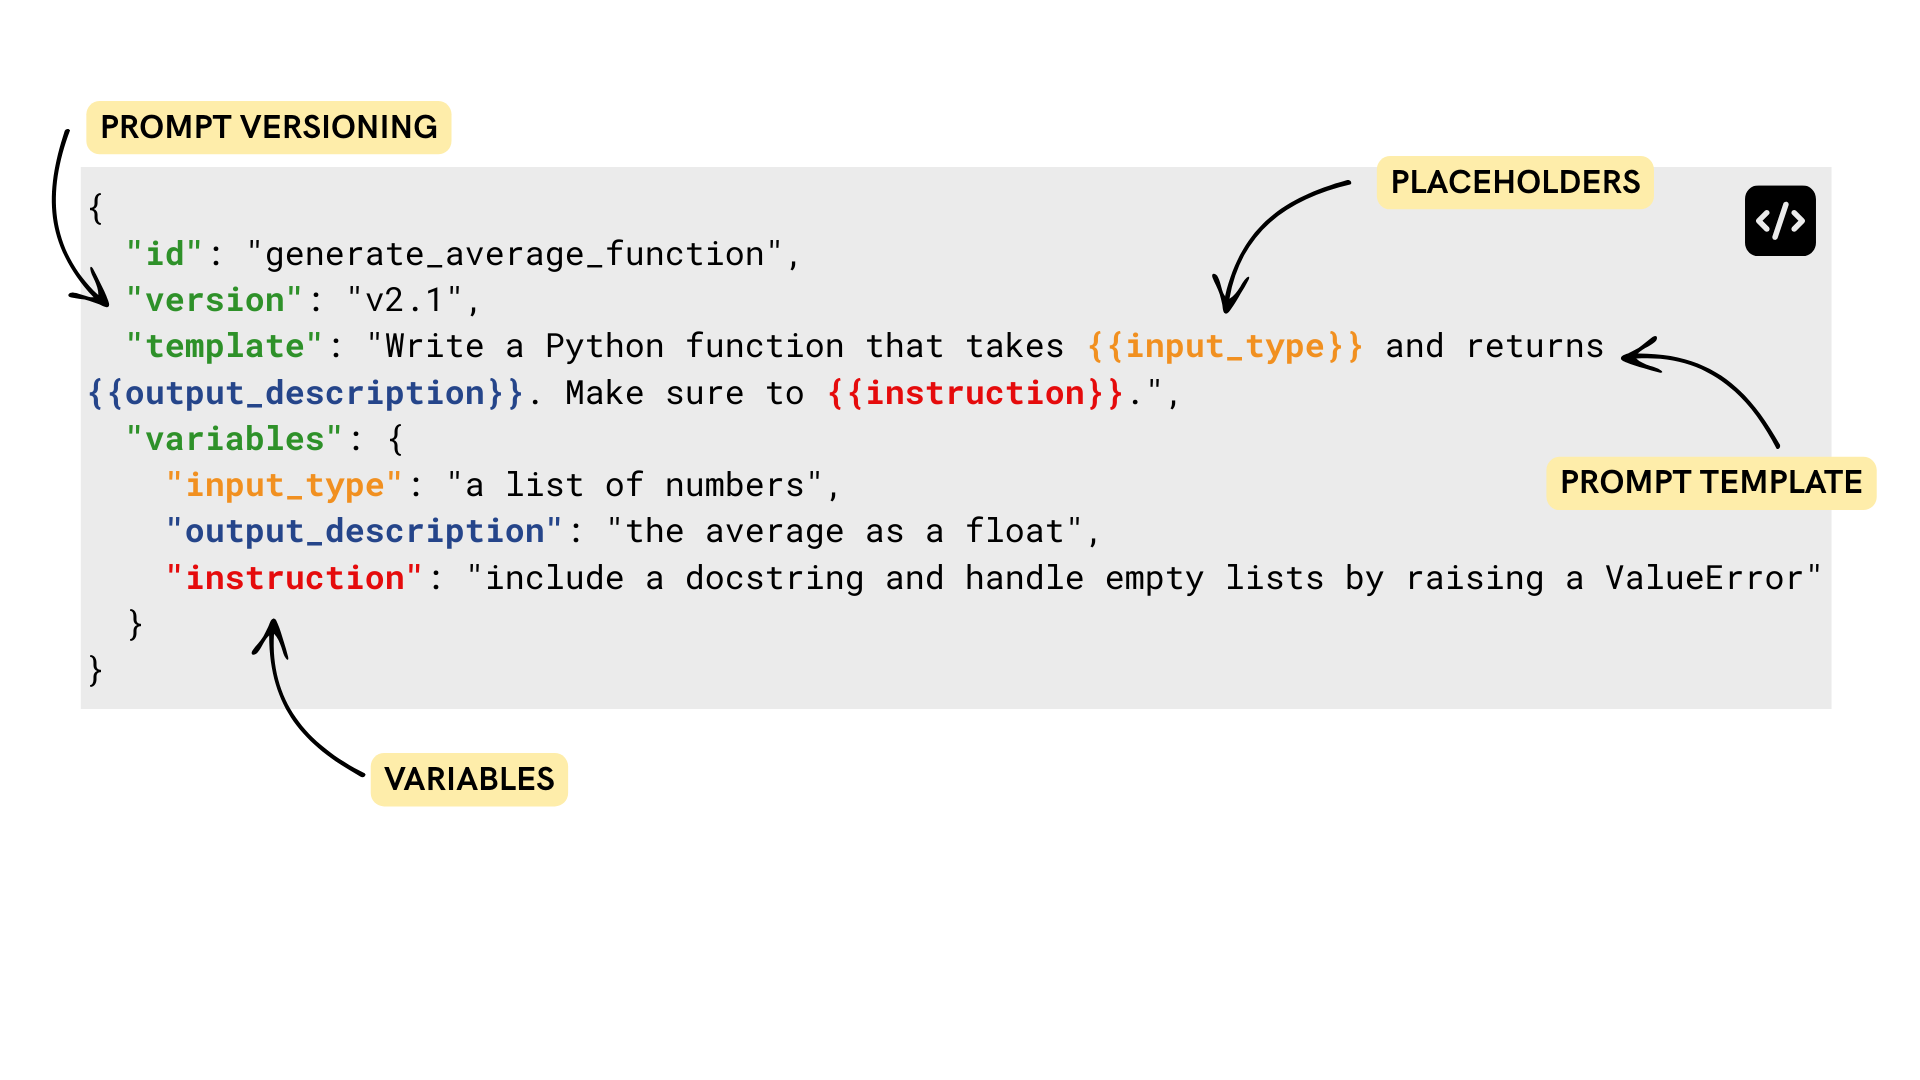
Versionarea prompturilor
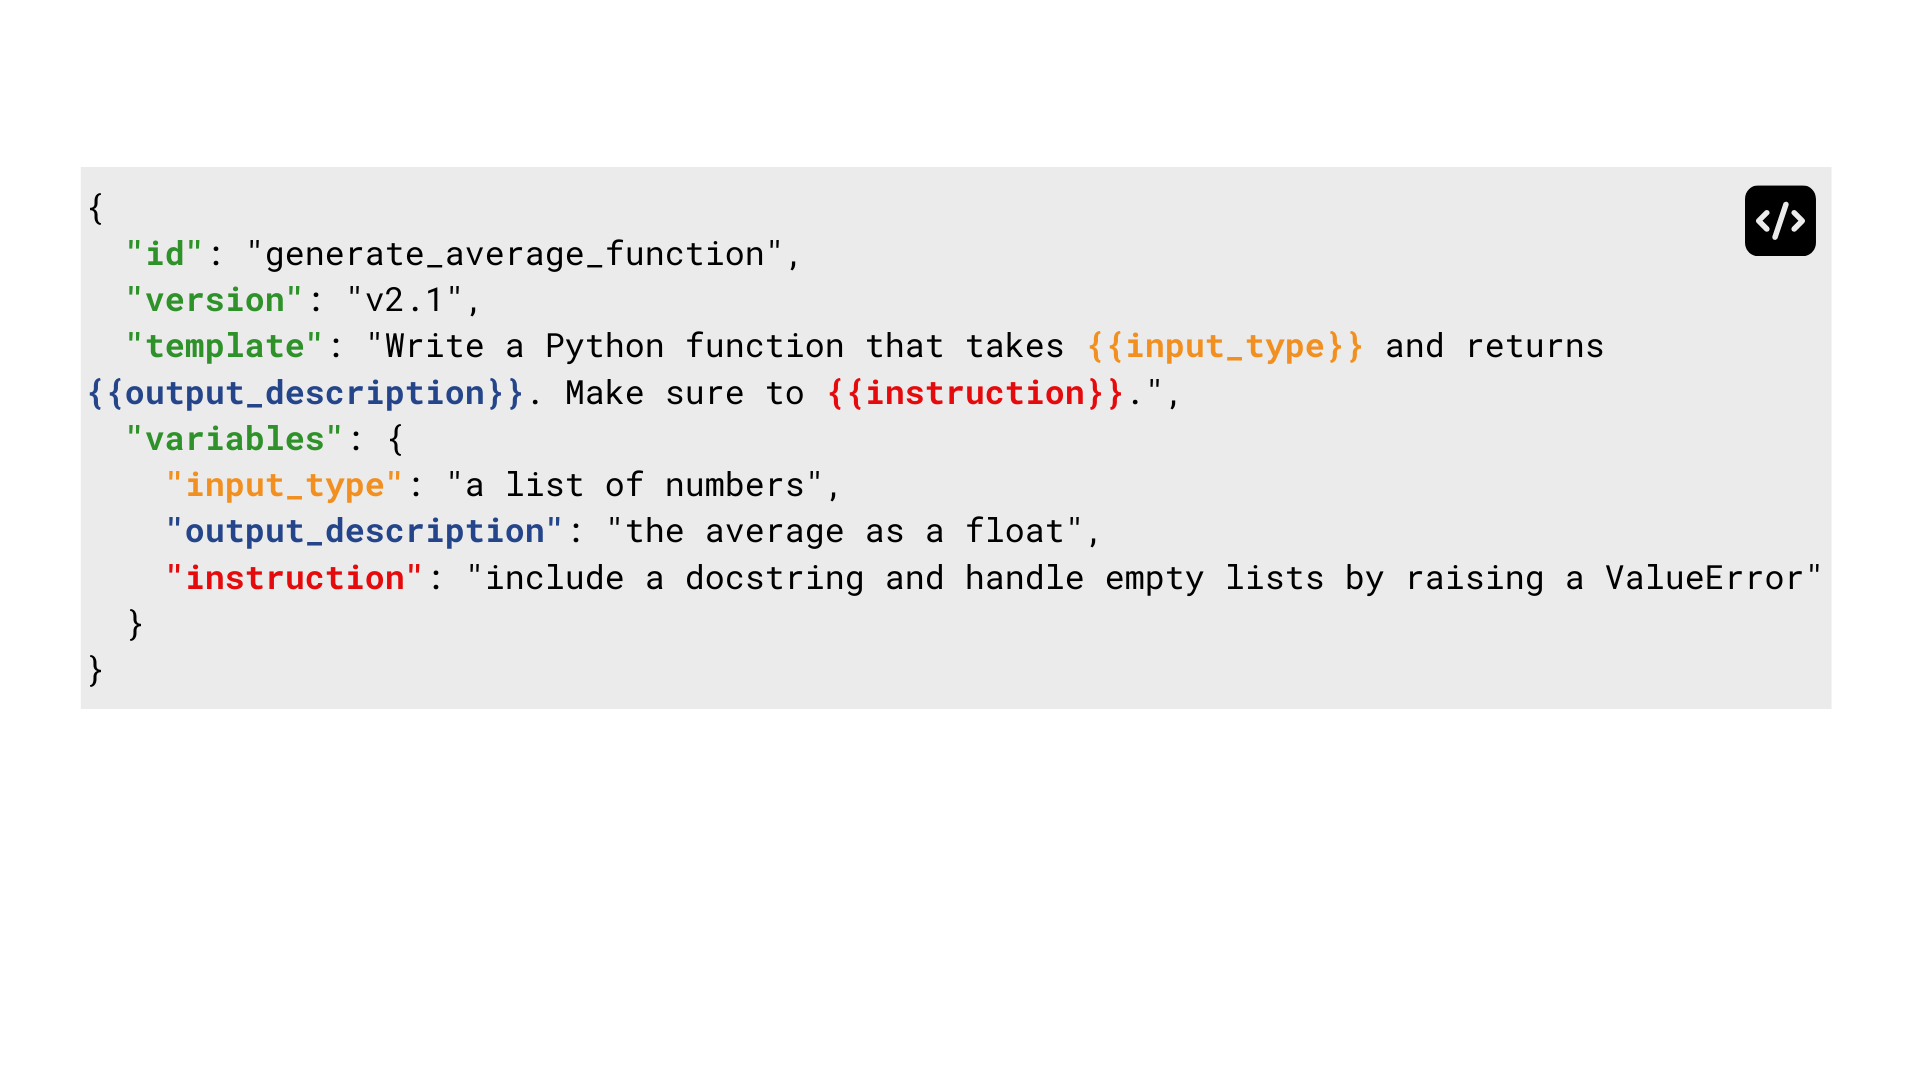
Stocarea în cache a prompturilor
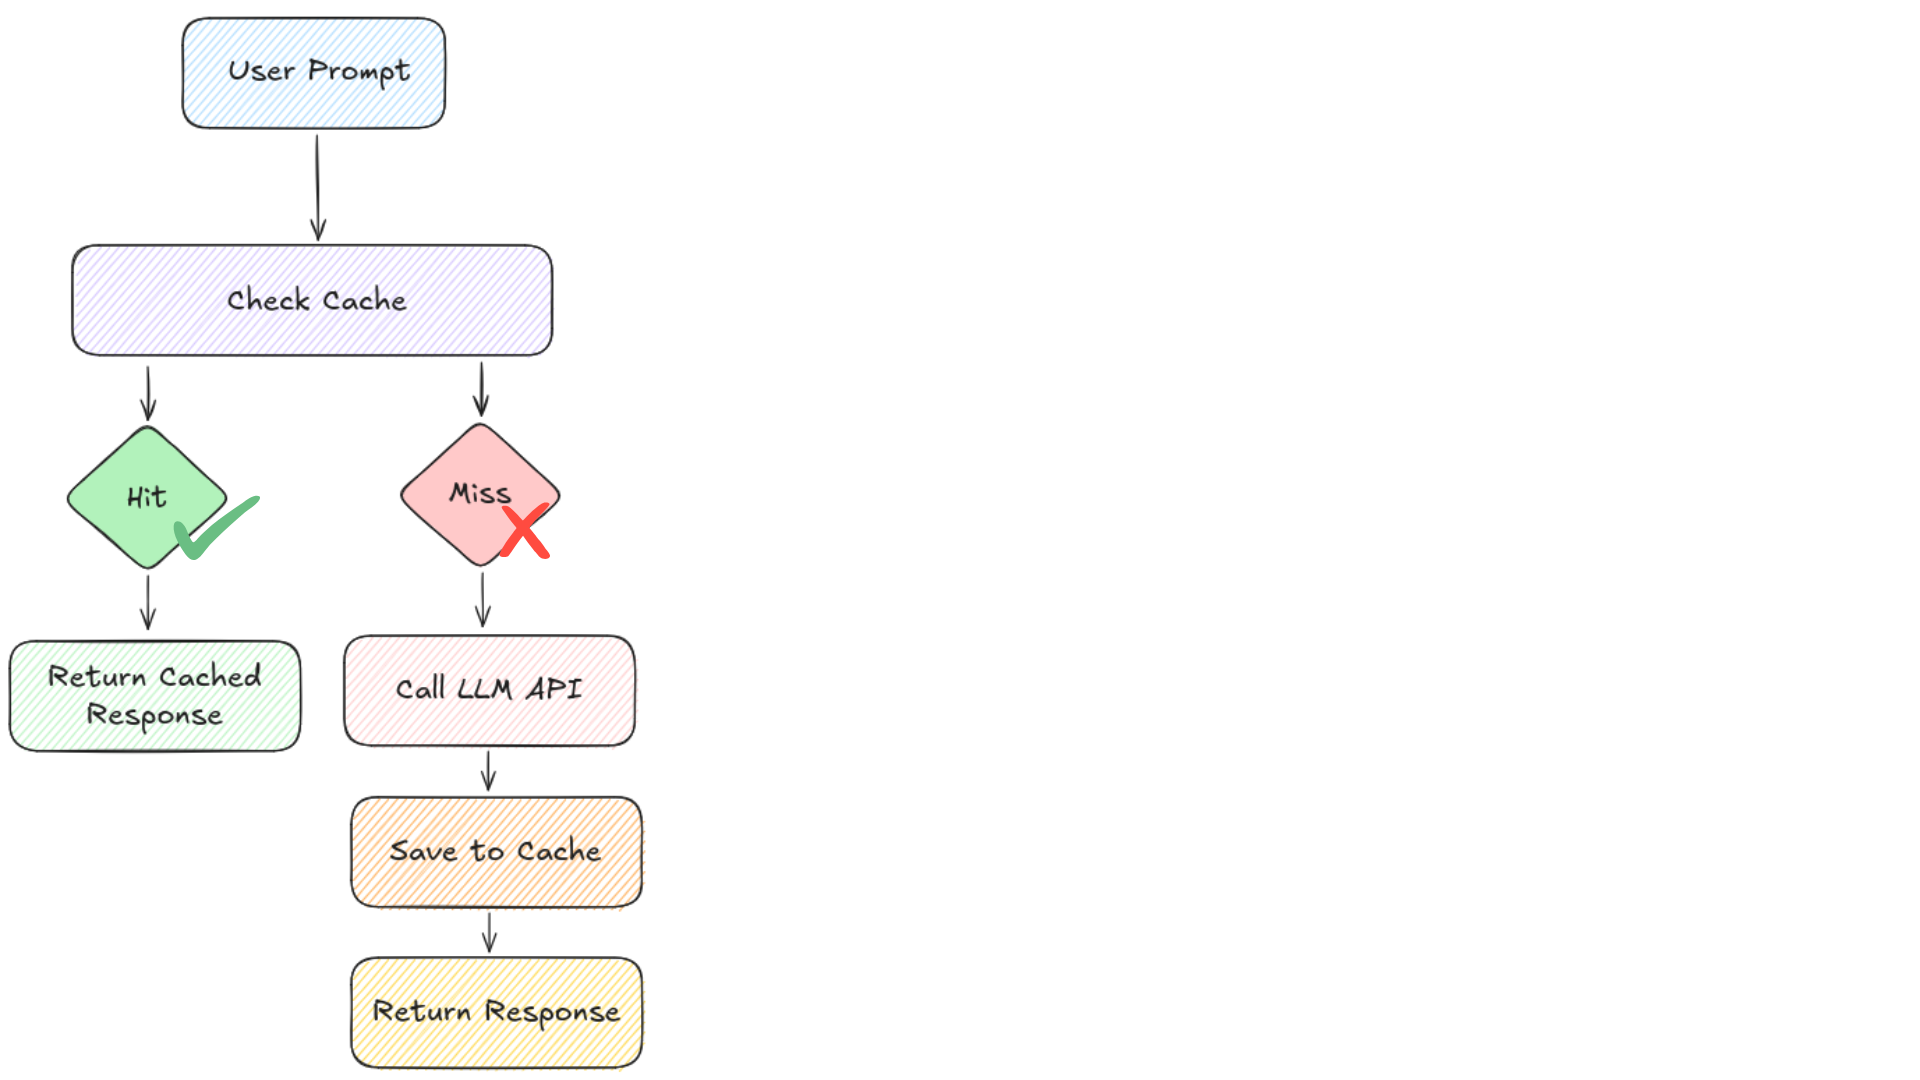
Stocarea în cache include:
Promptul
Intrarea
Modelul
Temperatura
Să exersăm!
Programare asistată de AI pentru dezvoltatori
Preparing Video For Download...