Évaluer plusieurs modèles
Apprentissage supervisé avec scikit-learn

George Boorman
Core Curriculum Manager, DataCamp
Des modèles adaptés aux problèmes
Quelques principes directeurs
- Taille de l'ensemble de données
- Moins d'attributs = modèle plus simple, entraînement plus rapide
- Certains modèles exigent beaucoup de données pour bien performer
- Interprétabilité
- Certains modèles s'expliquent plus facilement, utile pour les parties prenantes
- La régression linéaire est très interprétable : on comprend les coefficients
- Souplesse
- Peut améliorer la précision en supposant moins de choses sur les données
- KNN est plus souple : n'assume aucune relation linéaire
Tout est dans les mesures
Performance en régression :
- RMSE
- R-carré
Performance en classification :
- Exactitude
- Matrice de confusion
- Précision, rappel, F1
- ROC AUC
Entraîner plusieurs modèles et évaluer la performance telle quelle
Note sur la mise à l'échelle
- Modèles sensibles à la mise à l'échelle :
- KNN
- Régression linéaire (ainsi que Ridge, Lasso)
- Régression logistique
- Artificial Neural Network
- Mieux vaut mettre les données à l'échelle avant d'évaluer les modèles
Évaluer des modèles de classification
import matplotlib.pyplot as plt from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_val_score, KFold, train_test_split from sklearn.neighbors import KNeighborsClassifier from sklearn.linear_model import LogisticRegression from sklearn.tree import DecisionTreeClassifierX = music.drop("genre", axis=1).values y = music["genre"].values X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)scaler = StandardScaler() X_train_scaled = scaler.fit_transform(X_train)X_test_scaled = scaler.transform(X_test)
Évaluer des modèles de classification
models = {"Logistic Regression": LogisticRegression(), "KNN": KNeighborsClassifier(), "Decision Tree": DecisionTreeClassifier()} results = []for model in models.values():kf = KFold(n_splits=6, random_state=42, shuffle=True)cv_results = cross_val_score(model, X_train_scaled, y_train, cv=kf)results.append(cv_results)plt.boxplot(results, labels=models.keys()) plt.show()
Visualiser les résultats
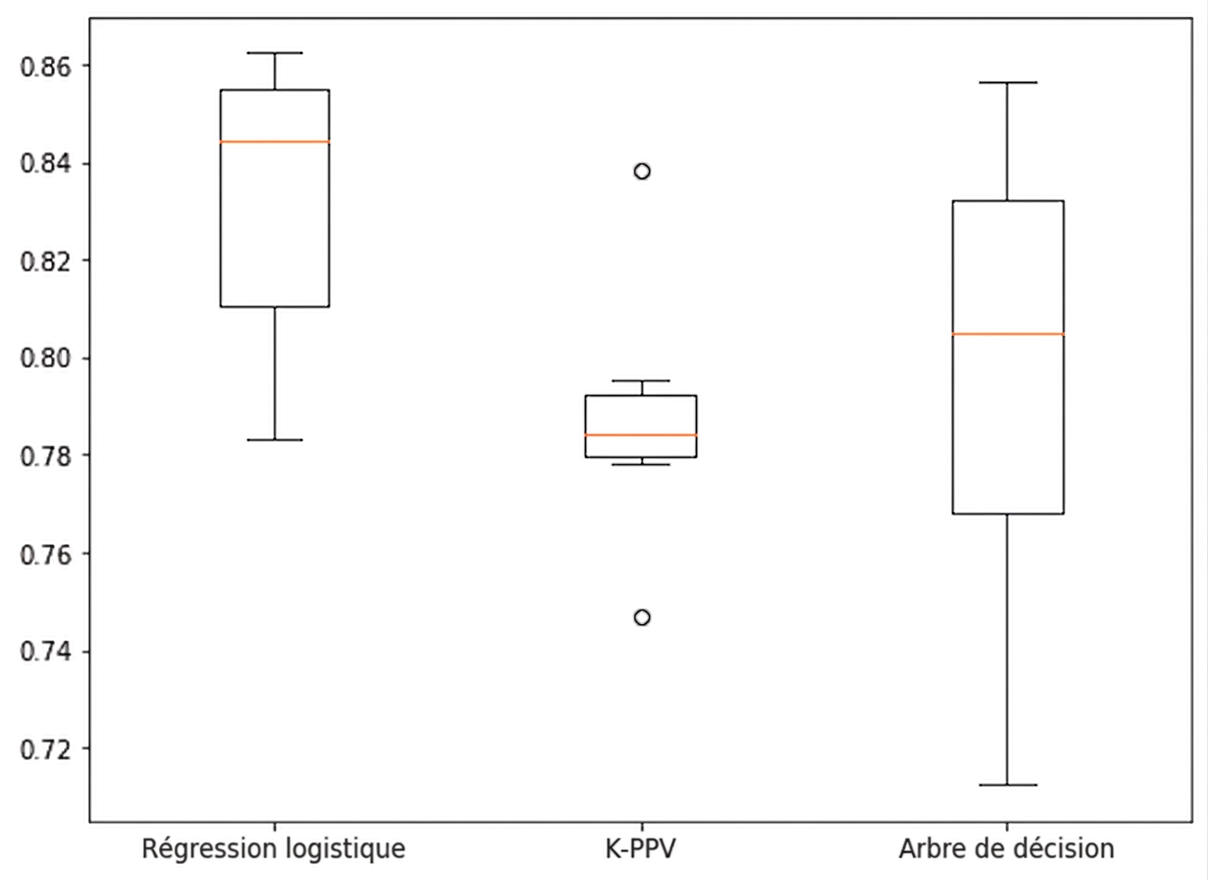
Performance sur l'ensemble de test
for name, model in models.items():model.fit(X_train_scaled, y_train)test_score = model.score(X_test_scaled, y_test)print("{} Test Set Accuracy: {}".format(name, test_score))
Logistic Regression Test Set Accuracy: 0.844
KNN Test Set Accuracy: 0.82
Decision Tree Test Set Accuracy: 0.832
Passons à la pratique !
Apprentissage supervisé avec scikit-learn

