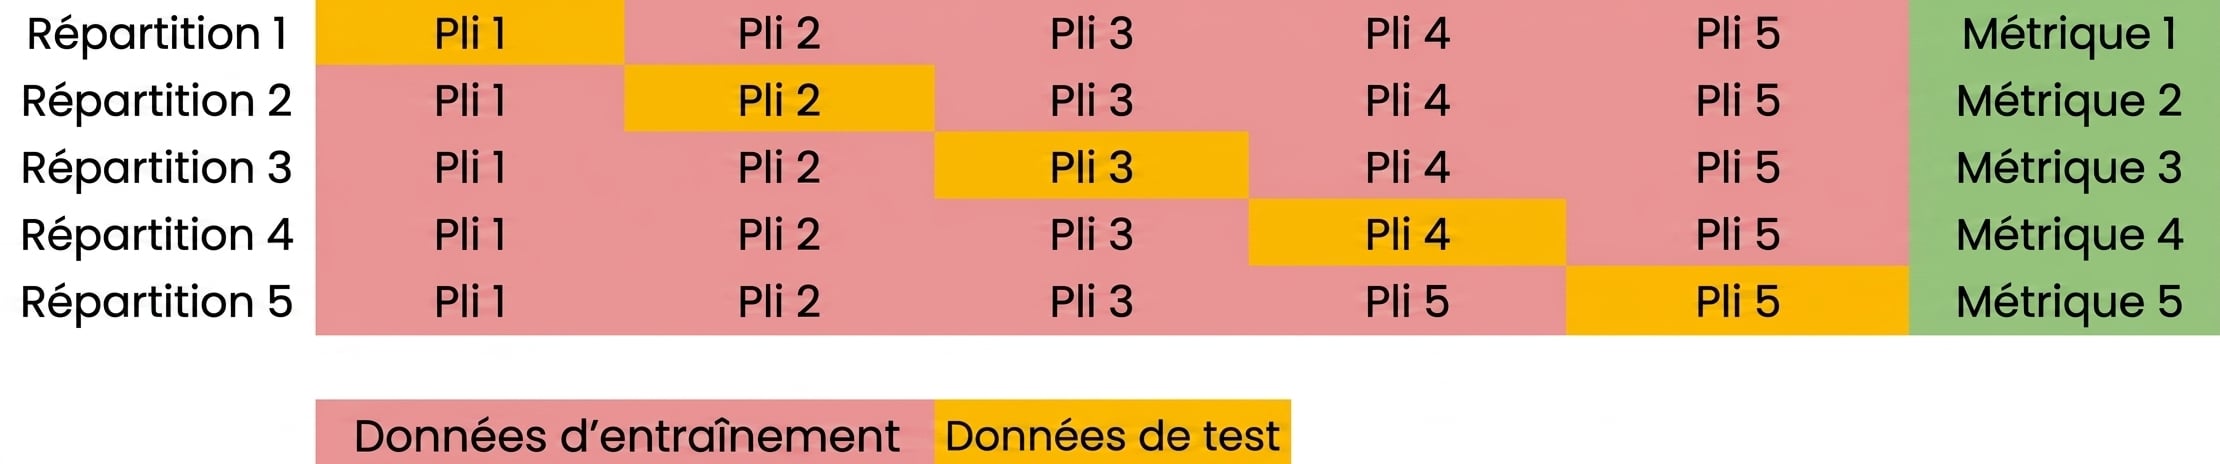
Validation croisée
Apprentissage supervisé avec scikit-learn

George Boorman
Core Curriculum Manager, DataCamp
Notions de base de la validation croisée

Notions de base de la validation croisée
Notions de base de la validation croisée
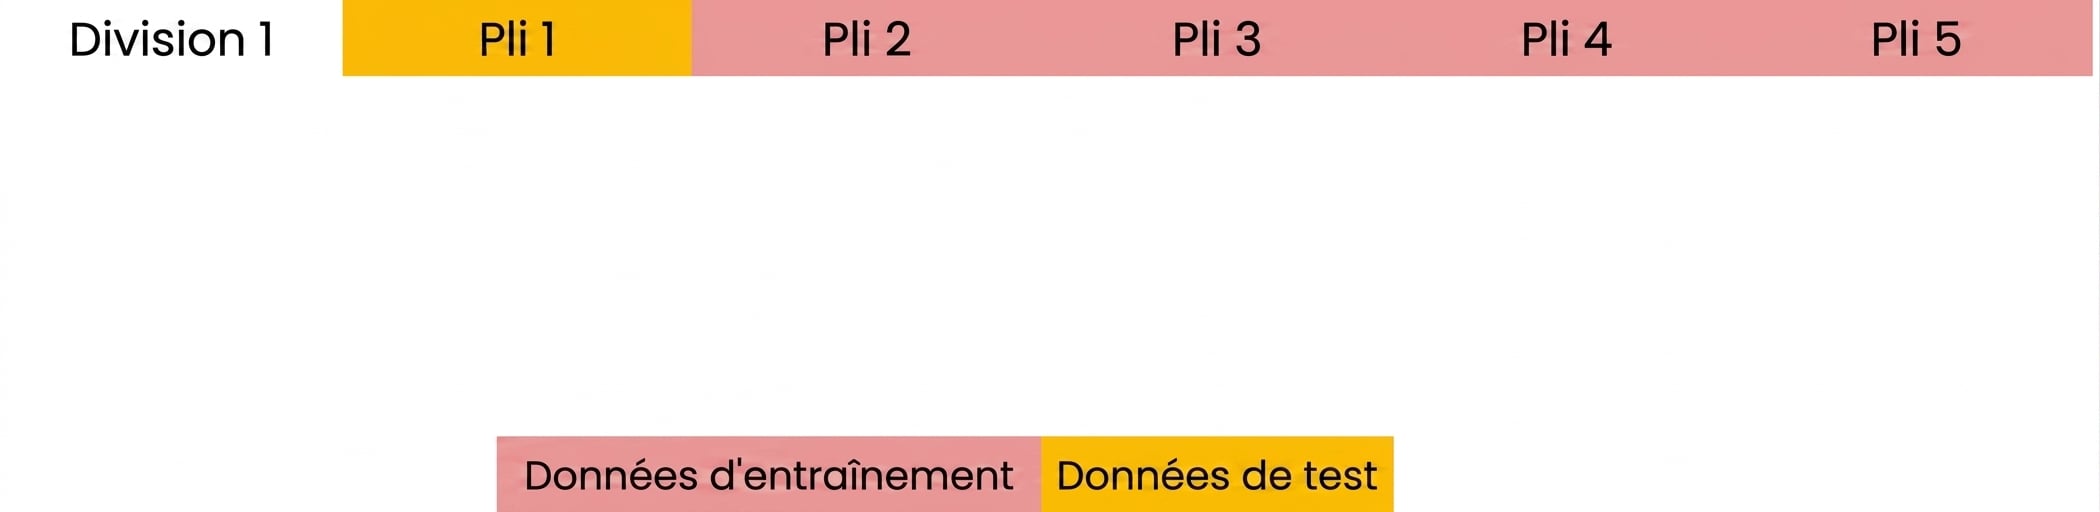
Notions de base de la validation croisée
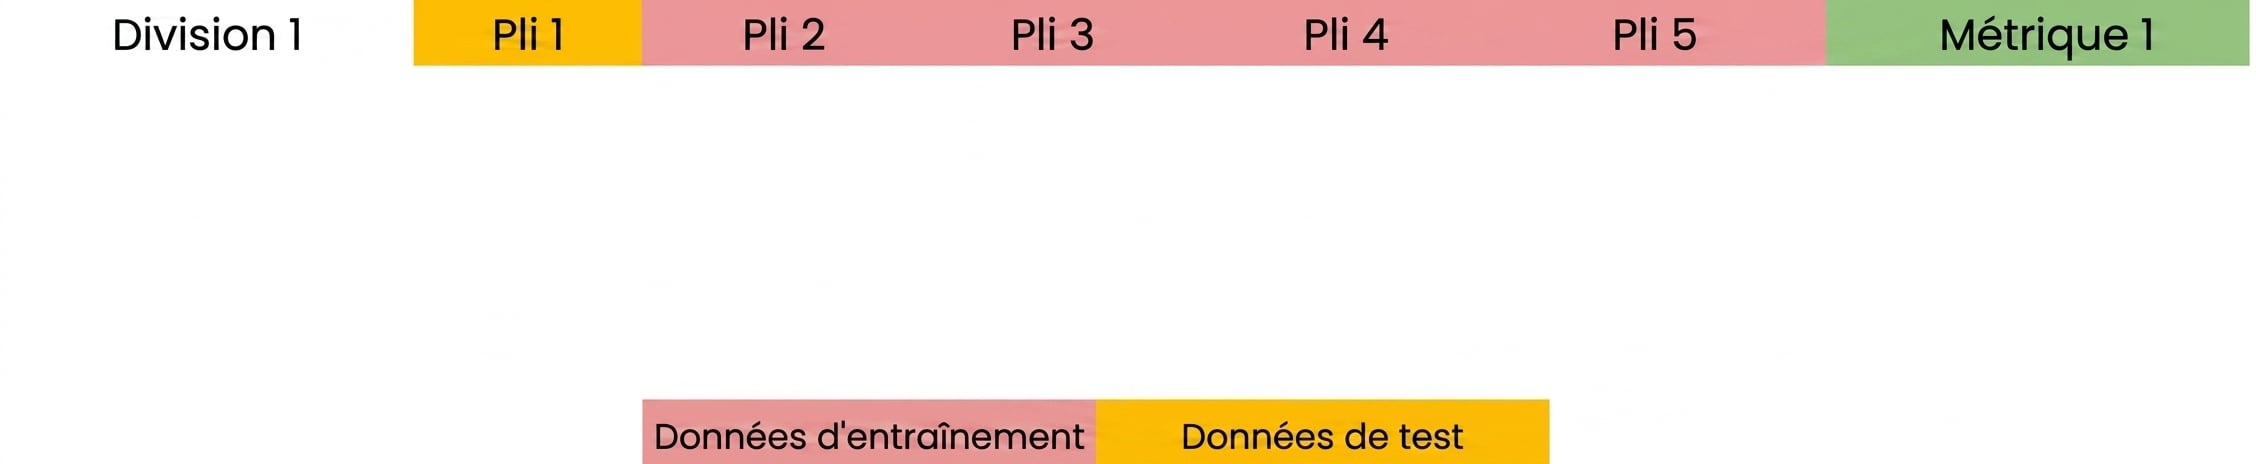
Notions de base de la validation croisée
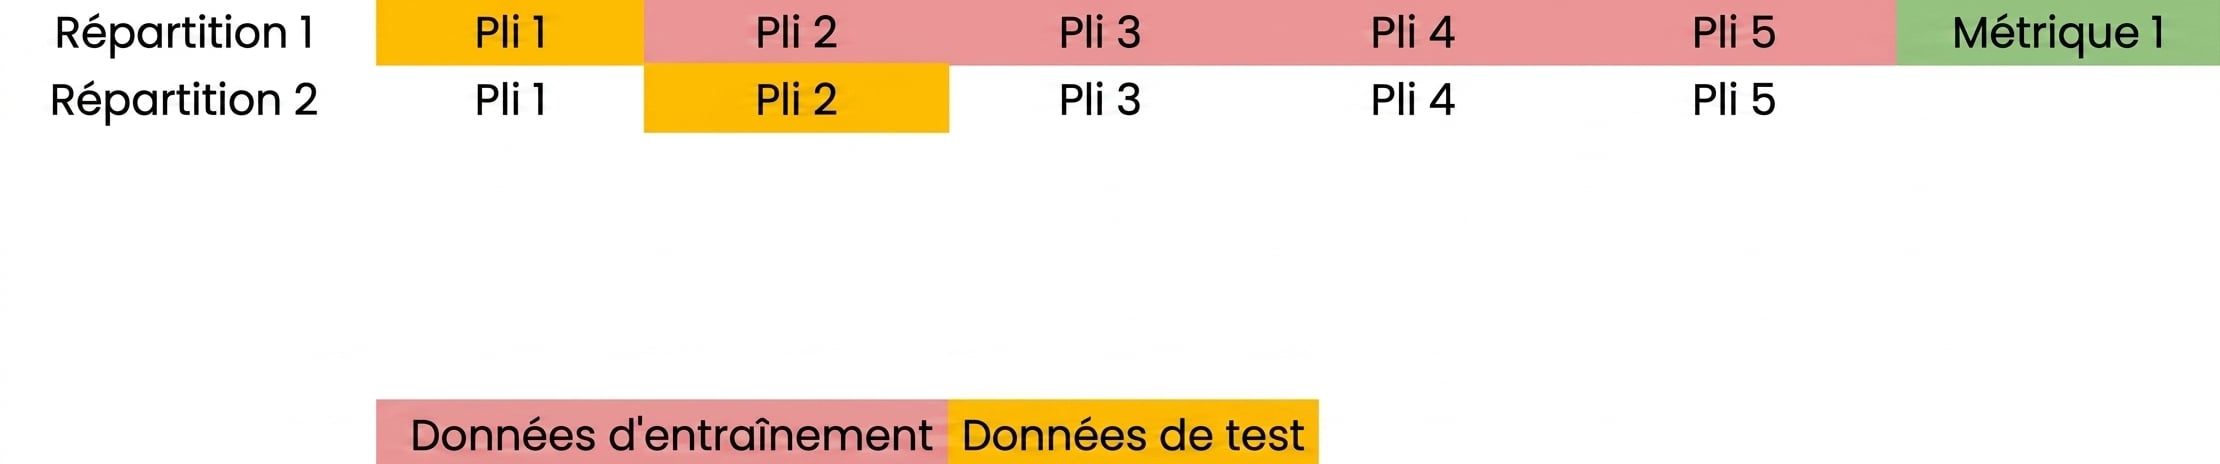
Notions de base de la validation croisée
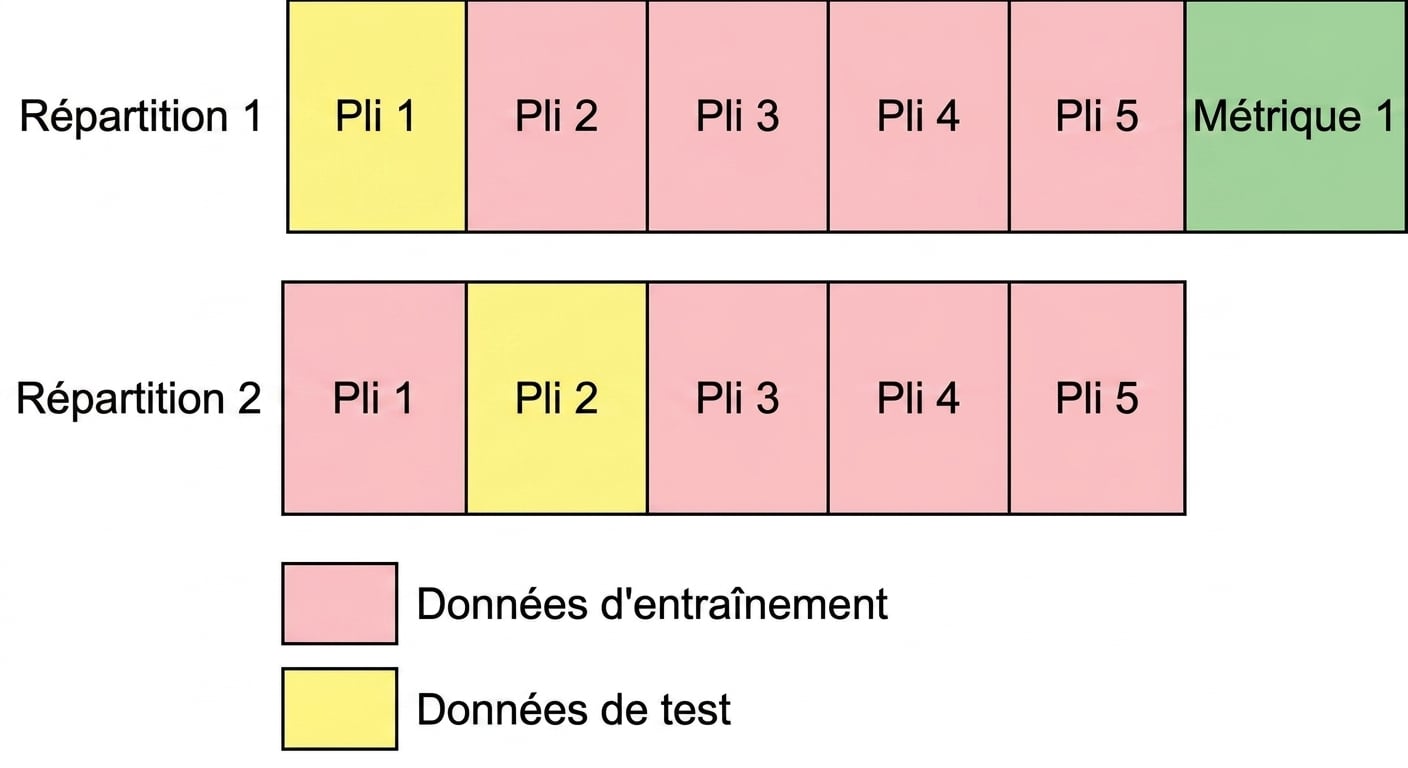
Notions de base de la validation croisée
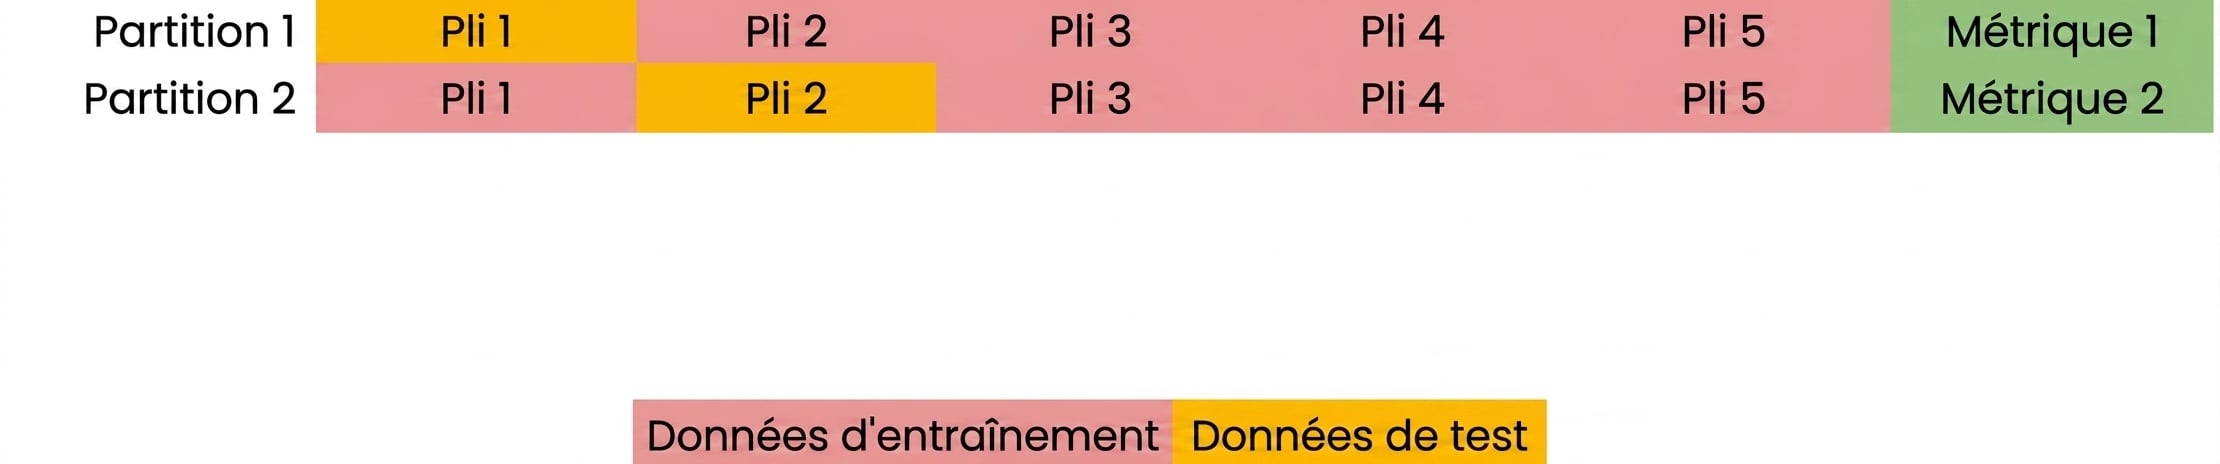
Notions de base de la validation croisée
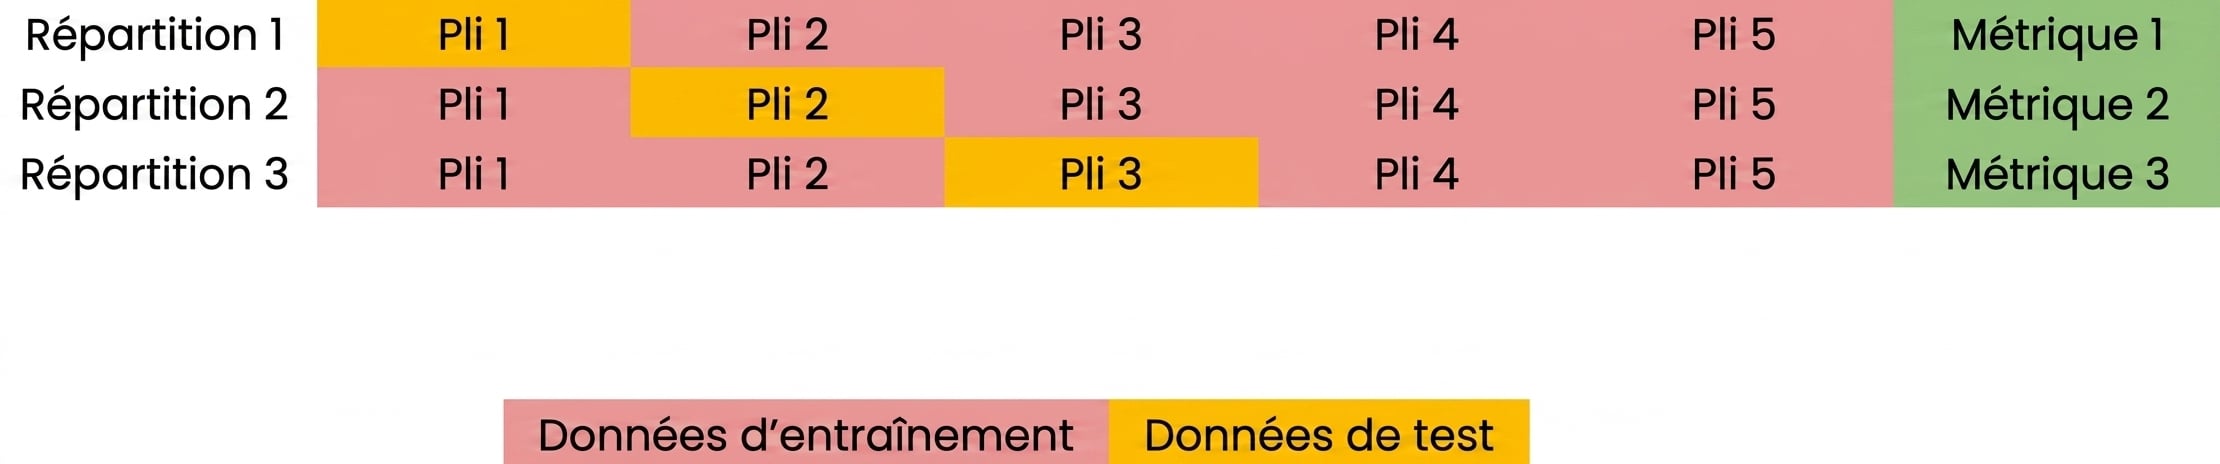
Notions de base de la validation croisée
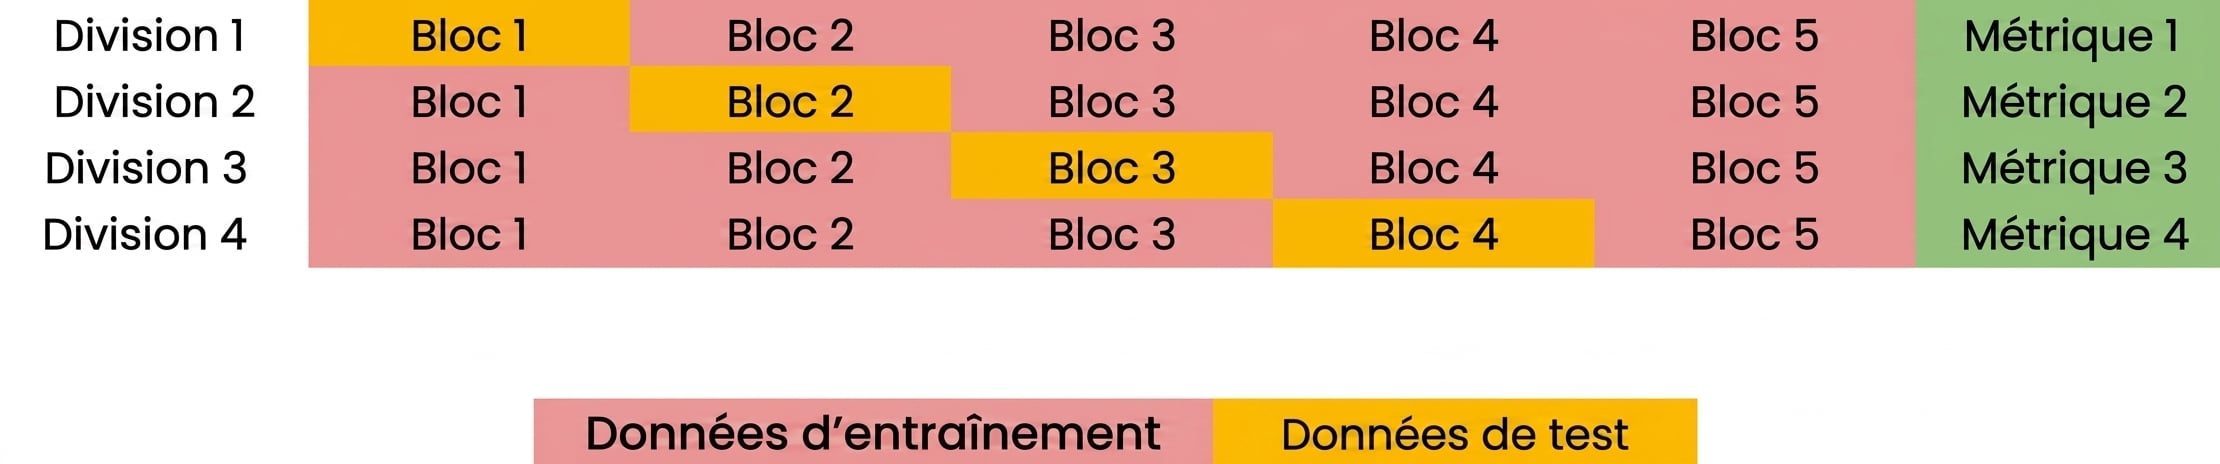
Notions de base de la validation croisée