Apprentissage supervisé avec scikit-learn
George Boorman
Core Curriculum Manager, DataCamp
En classification, l'exactitude est un indicateur courant
Exactitude :
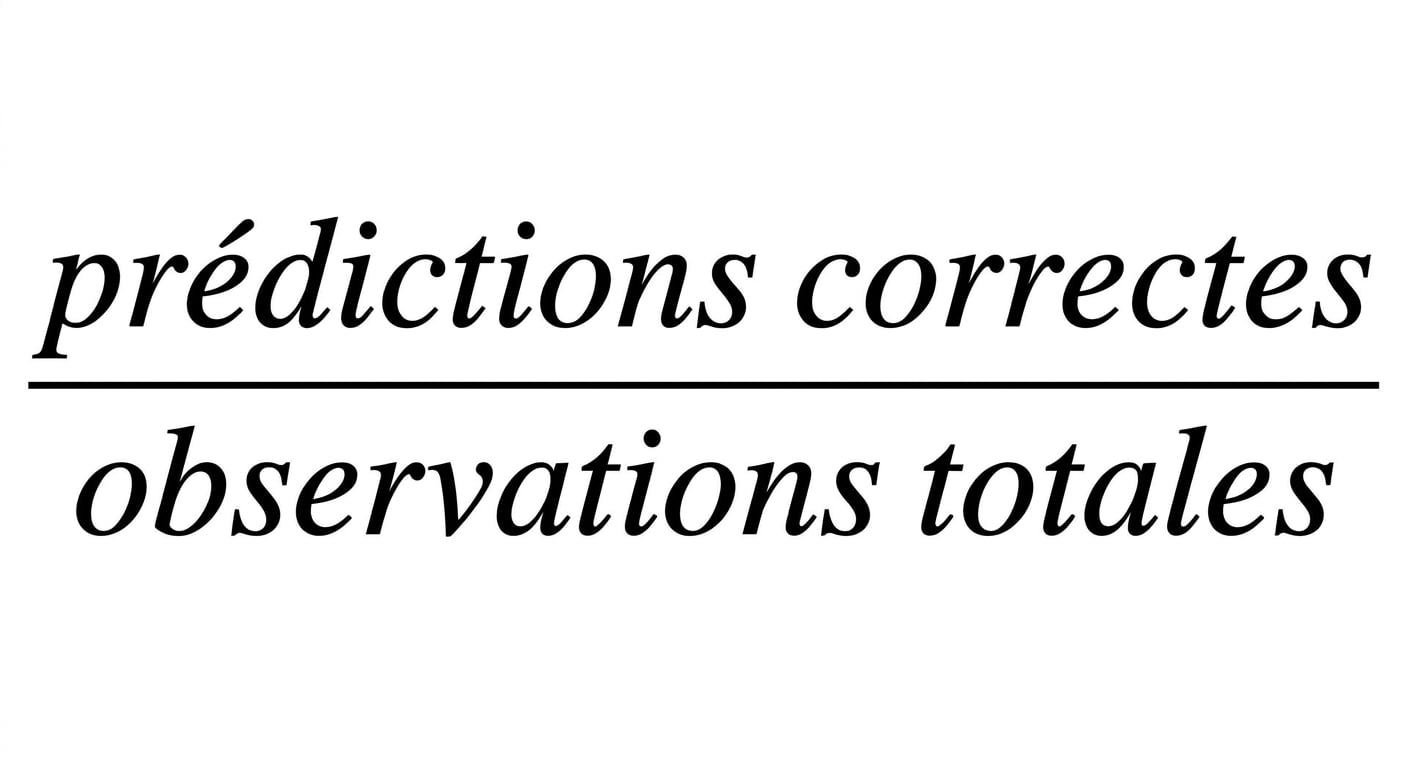
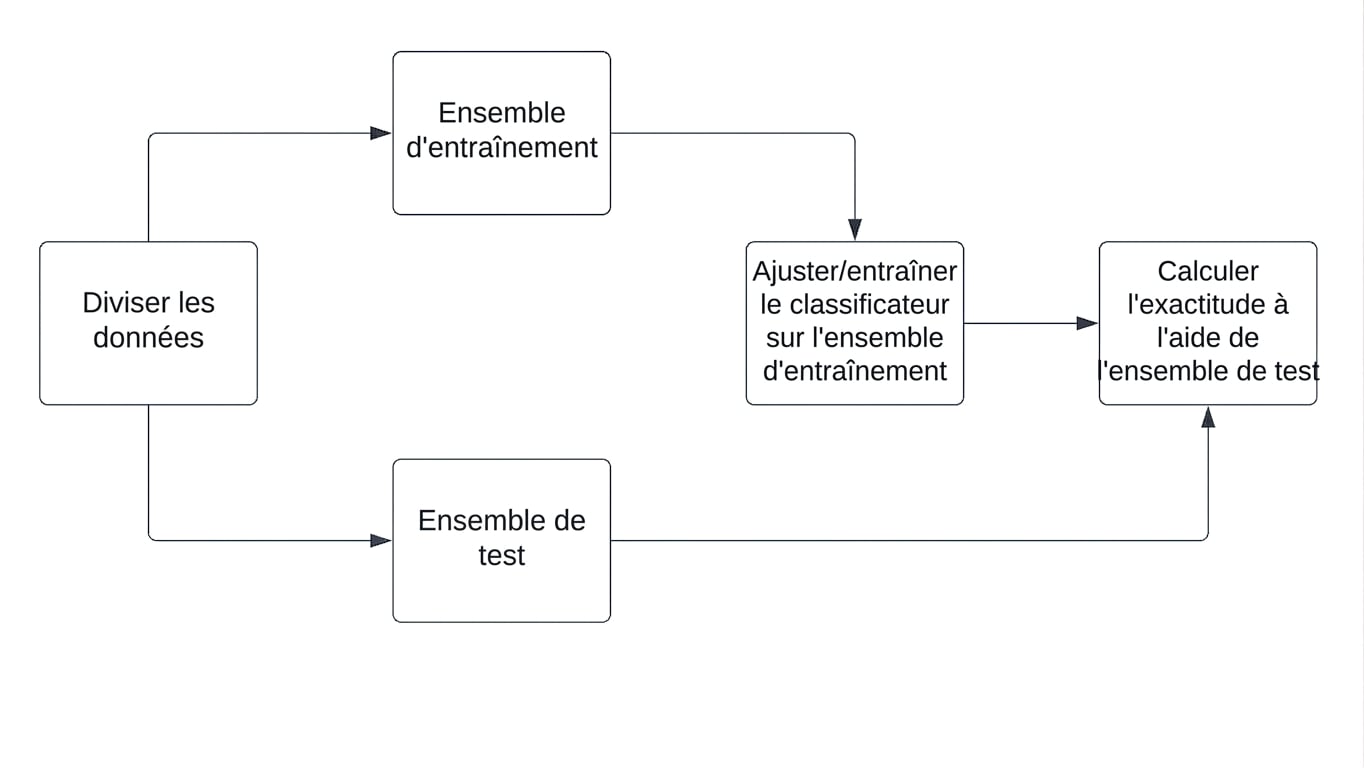
Comment mesurer l'exactitude ?
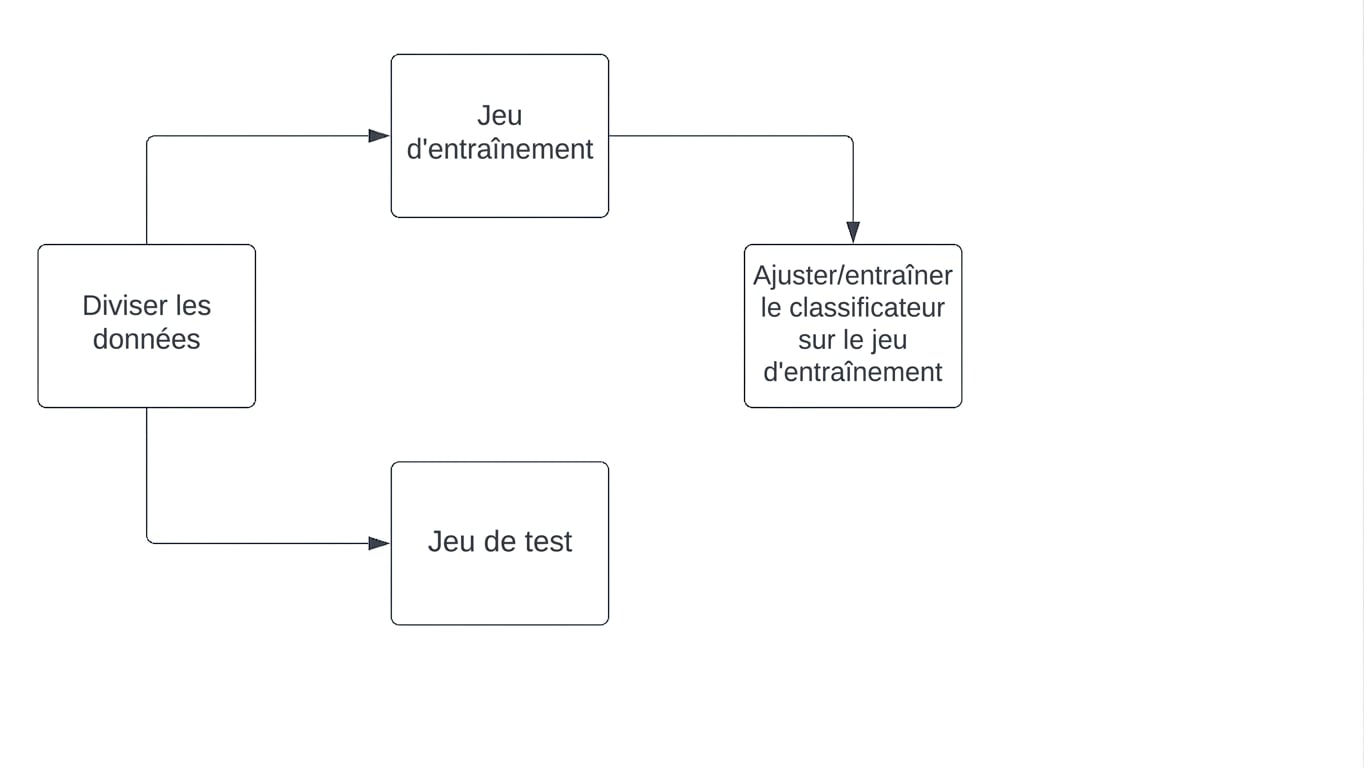
On peut la calculer sur les données ayant servi à ajuster le classifieur
MAIS ce n'est pas indicatif de la capacité de généralisation


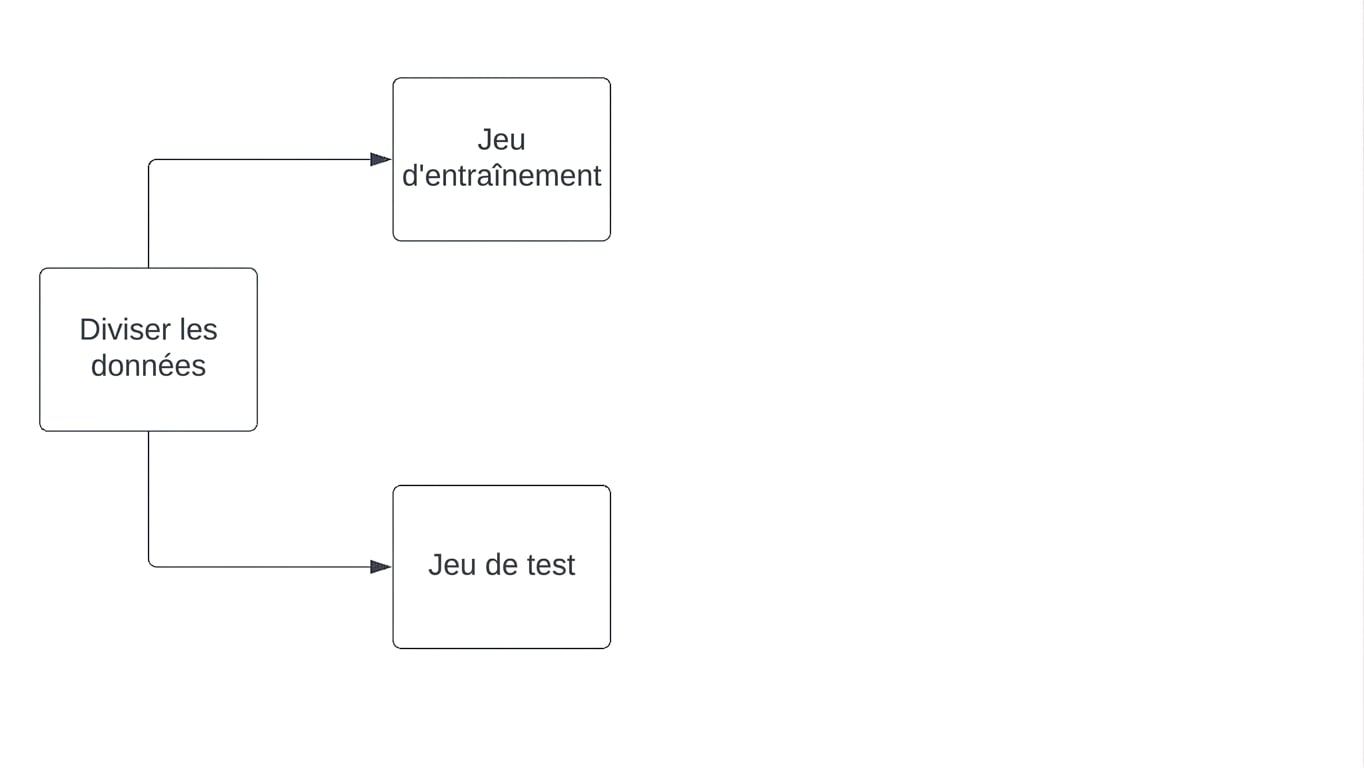
from sklearn.model_selection import train_test_splitX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=21, stratify=y)knn = KNeighborsClassifier(n_neighbors=6)knn.fit(X_train, y_train)print(knn.score(X_test, y_test))
0.8800599700149925
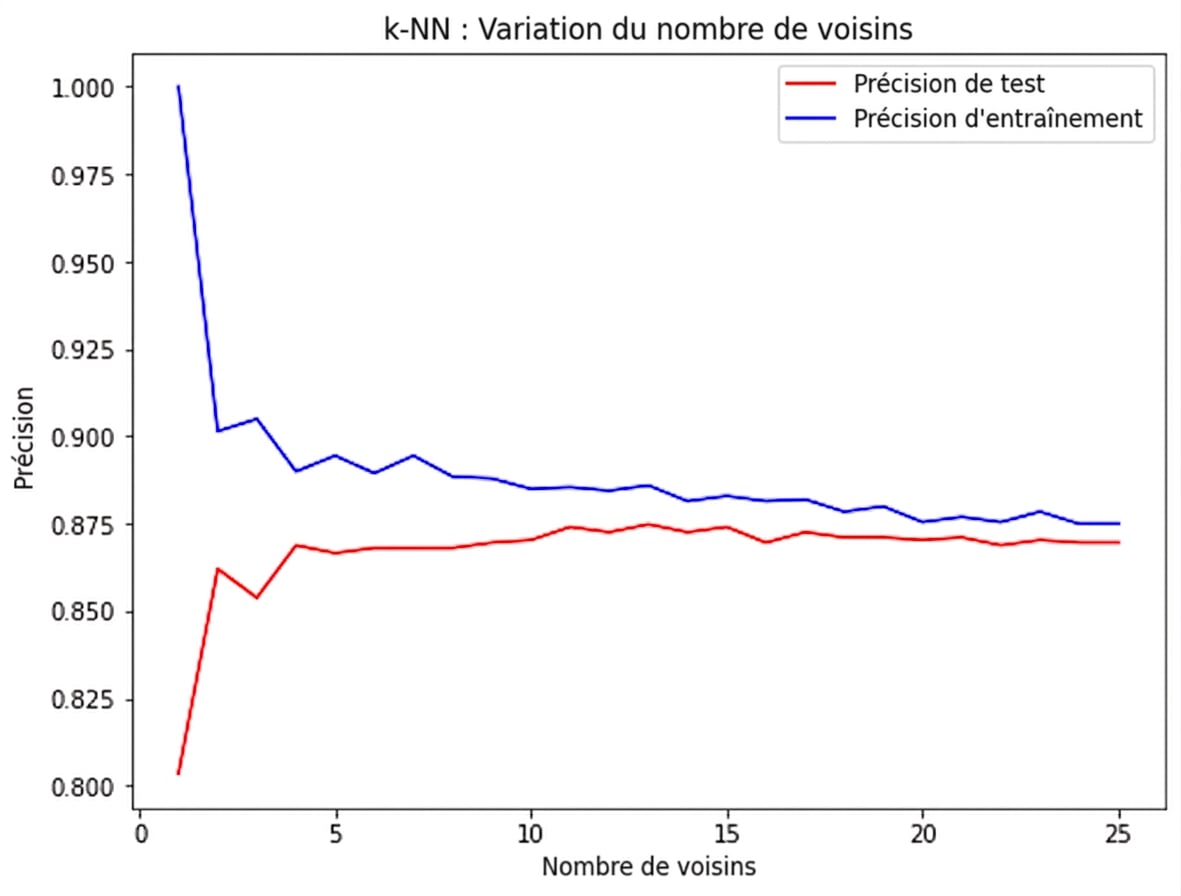
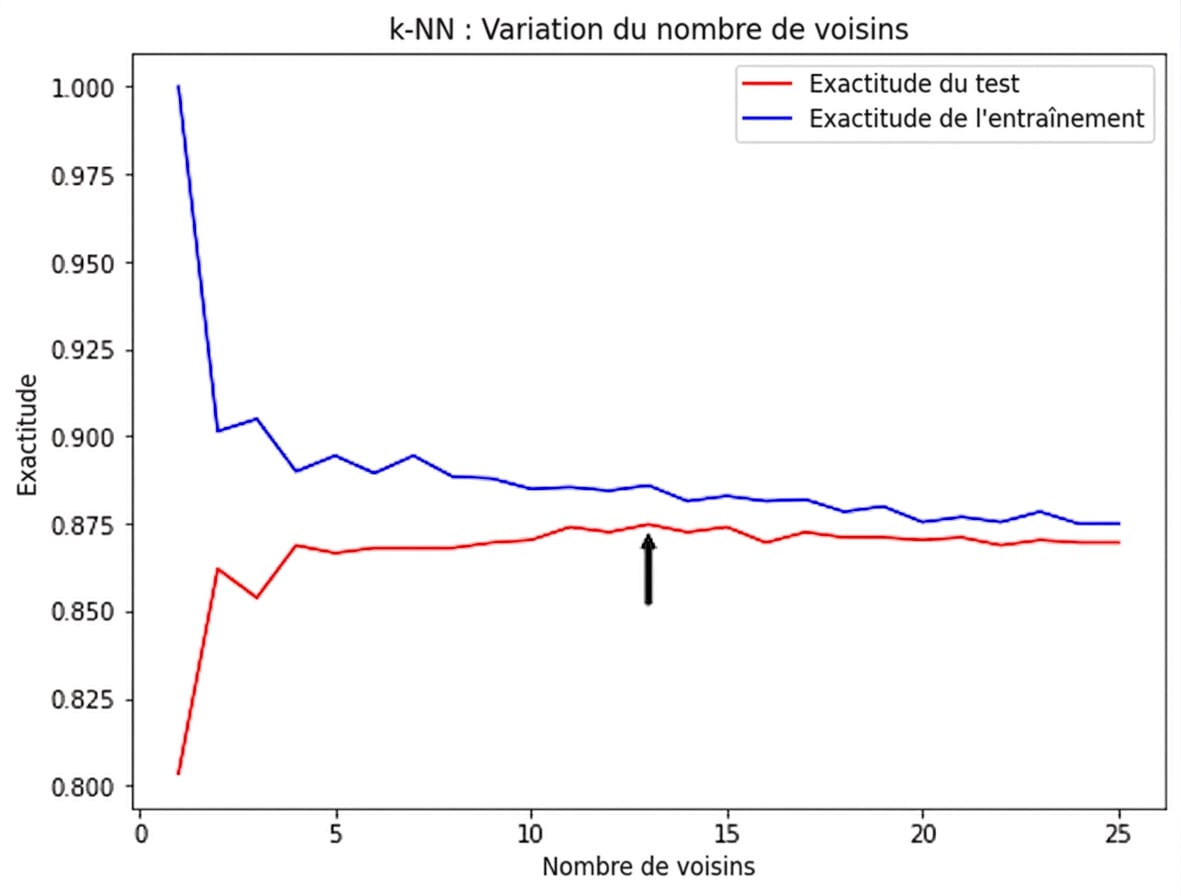
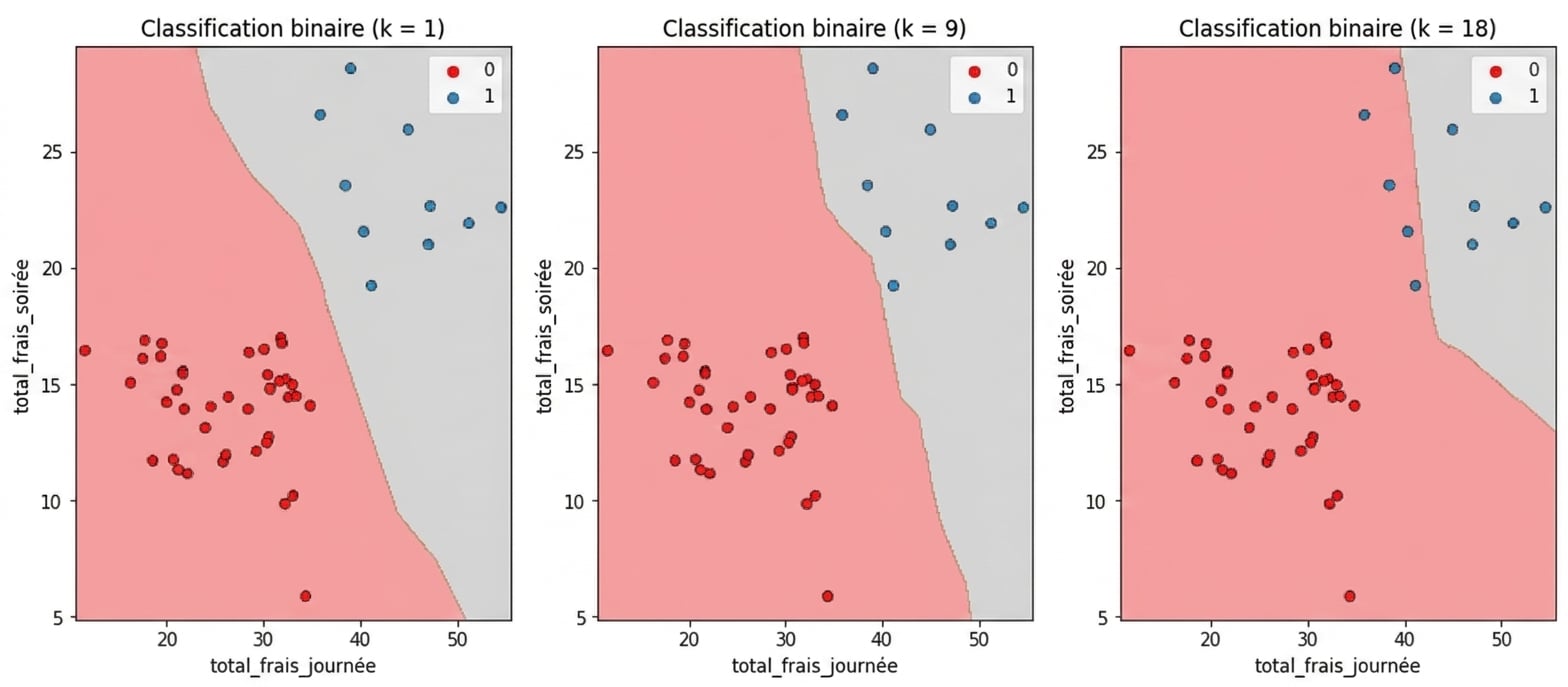
Plus grand k = modèle moins complexe = risque de sous‑apprentissage
Plus petit k = modèle plus complexe = risque de surapprentissage
train_accuracies = {} test_accuracies = {} neighbors = np.arange(1, 26)for neighbor in neighbors:knn = KNeighborsClassifier(n_neighbors=neighbor)knn.fit(X_train, y_train)train_accuracies[neighbor] = knn.score(X_train, y_train) test_accuracies[neighbor] = knn.score(X_test, y_test)
plt.figure(figsize=(8, 6))
plt.title("KNN: Varying Number of Neighbors")
plt.plot(neighbors, train_accuracies.values(), label="Training Accuracy")
plt.plot(neighbors, test_accuracies.values(), label="Testing Accuracy")
plt.legend()
plt.xlabel("Number of Neighbors")
plt.ylabel("Accuracy")
plt.show()


Apprentissage supervisé avec scikit-learn