Prétraiter les données

Apprentissage supervisé avec scikit-learn

George Boorman

Core Curriculum Manager, DataCamp

Exigences de scikit-learn

  • Données numériques
  • Aucune valeur manquante


  • Avec des données réelles :
    • C'est rarement le cas
    • Il faut souvent prétraiter les données d'abord
Apprentissage supervisé avec scikit-learn

Gérer les variables catégorielles

  • scikit-learn n'accepte pas les variables catégorielles par défaut

  • Il faut convertir les variables catégorielles en valeurs numériques

  • Convertir en variables binaires appelées « variables fictives »

    • 0 : l'observation n'était PAS de cette catégorie

    • 1 : l'observation était de cette catégorie

Apprentissage supervisé avec scikit-learn

Variables fictives

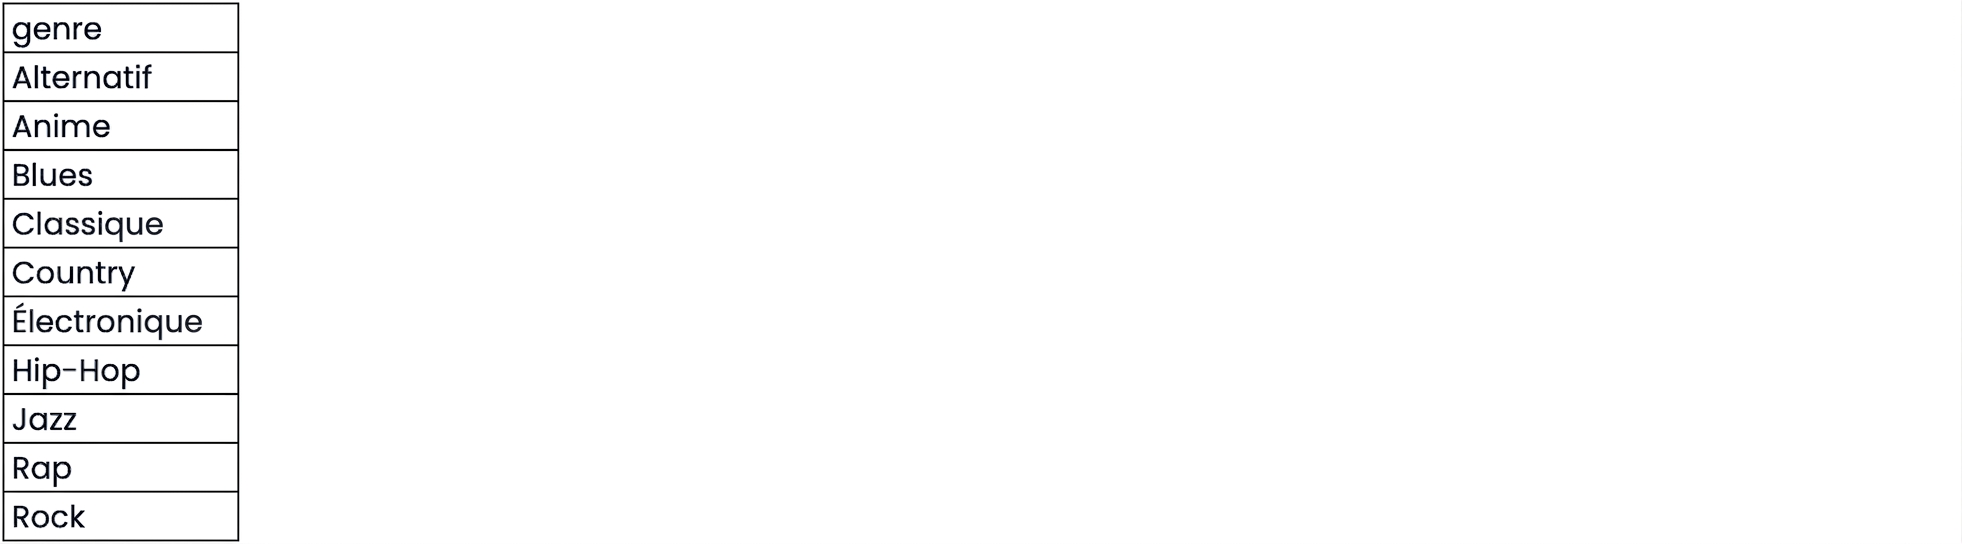
liste de onze genres, dont Electronic, Hip-Hop et Rock

Apprentissage supervisé avec scikit-learn

Variables fictives

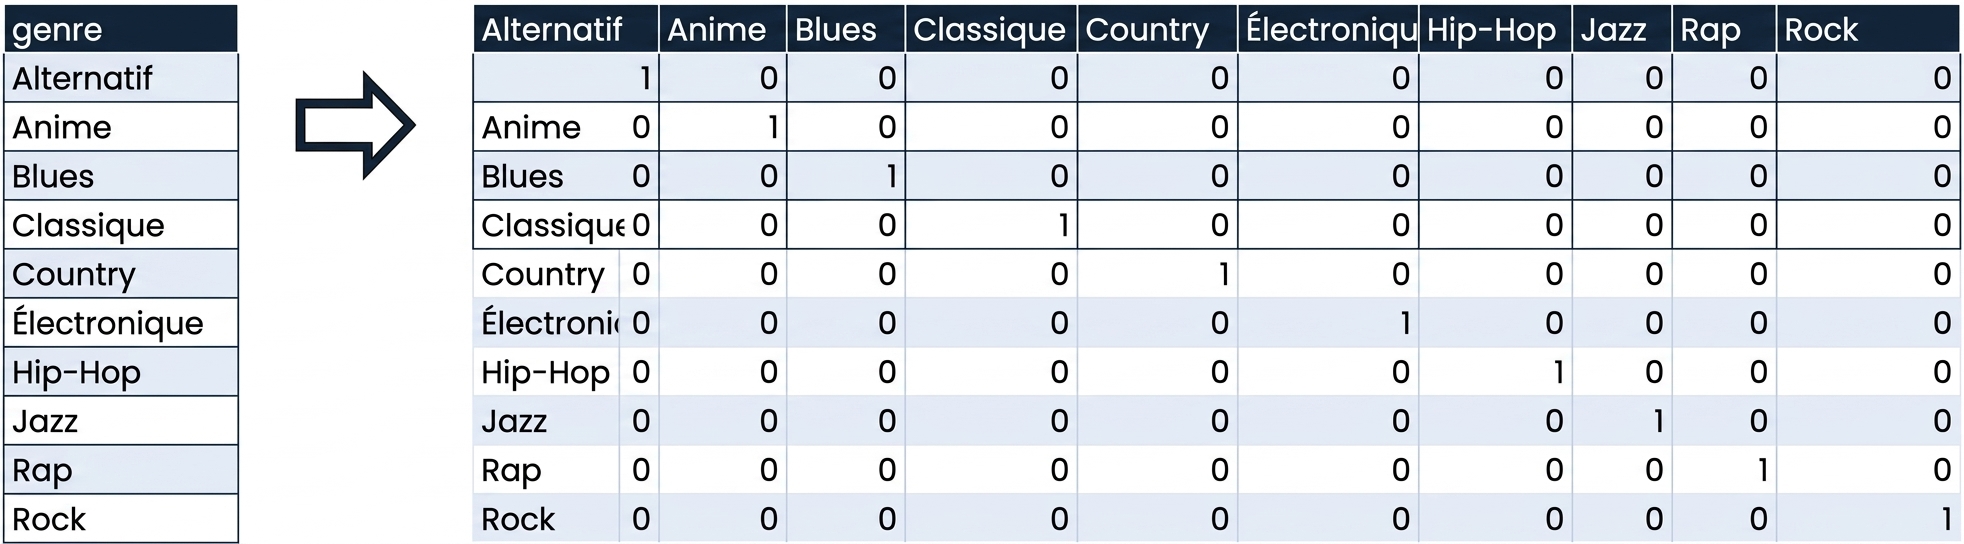
Grille avec des genres en colonnes et des zéros et des uns comme valeurs ; 1 signifie que la chanson est de ce genre, 0 sinon

Apprentissage supervisé avec scikit-learn

Variables fictives

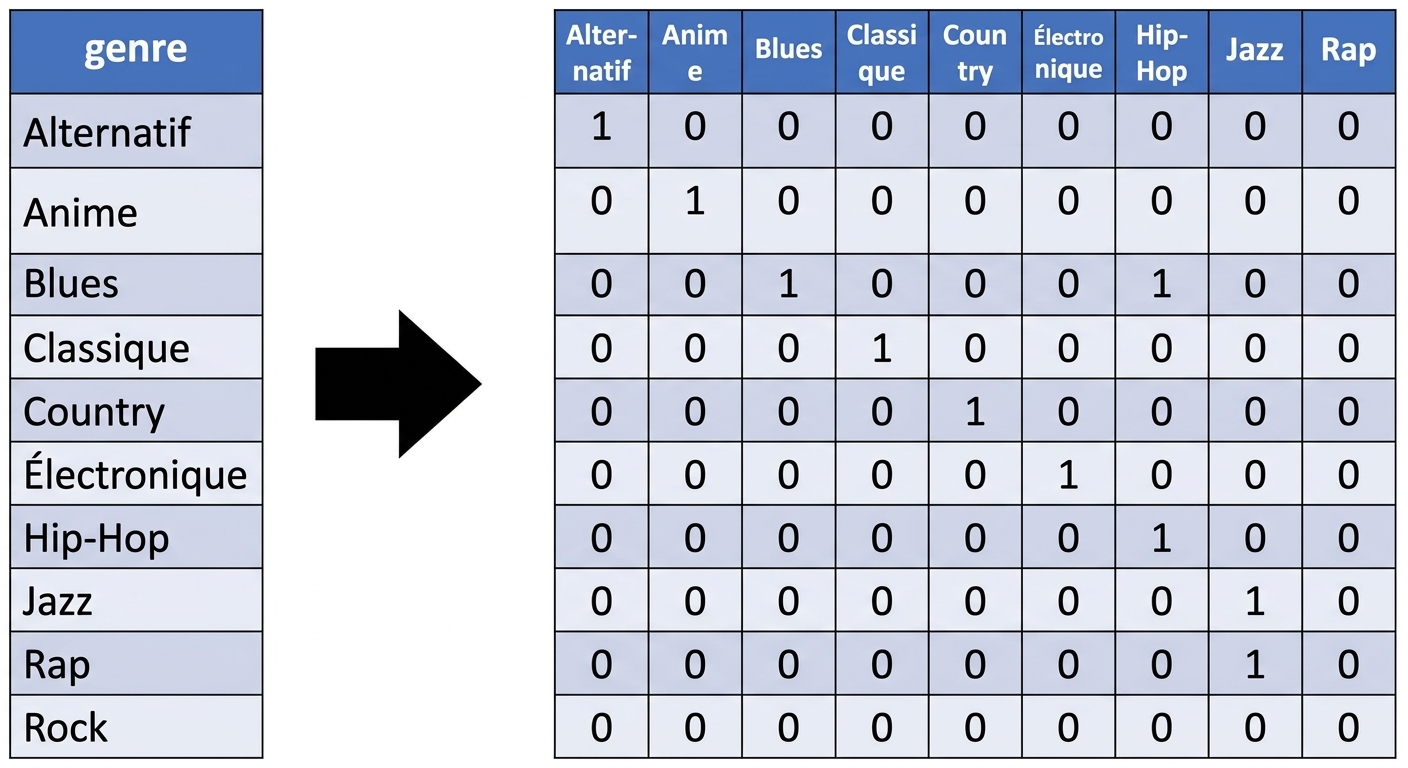
Grille de zéros et de uns sans colonne pour le genre Rock

Apprentissage supervisé avec scikit-learn

Gérer les variables catégorielles en Python

  • scikit-learn : OneHotEncoder()

  • pandas : get_dummies()

Apprentissage supervisé avec scikit-learn

Ensemble de données musical

  • popularity : Variable cible
  • genre : Variable catégorielle
print(music.info())
     popularity    acousticness    danceability    ...    tempo         valence    genre
0    41.0          0.6440          0.823           ...    102.619000    0.649      Jazz
1    62.0          0.0855          0.686           ...    173.915000    0.636      Rap
2    42.0          0.2390          0.669           ...    145.061000    0.494      Electronic
3    64.0          0.0125          0.522           ...    120.406497    0.595      Rock
4    60.0          0.1210          0.780           ...    96.056000     0.312      Rap
Apprentissage supervisé avec scikit-learn

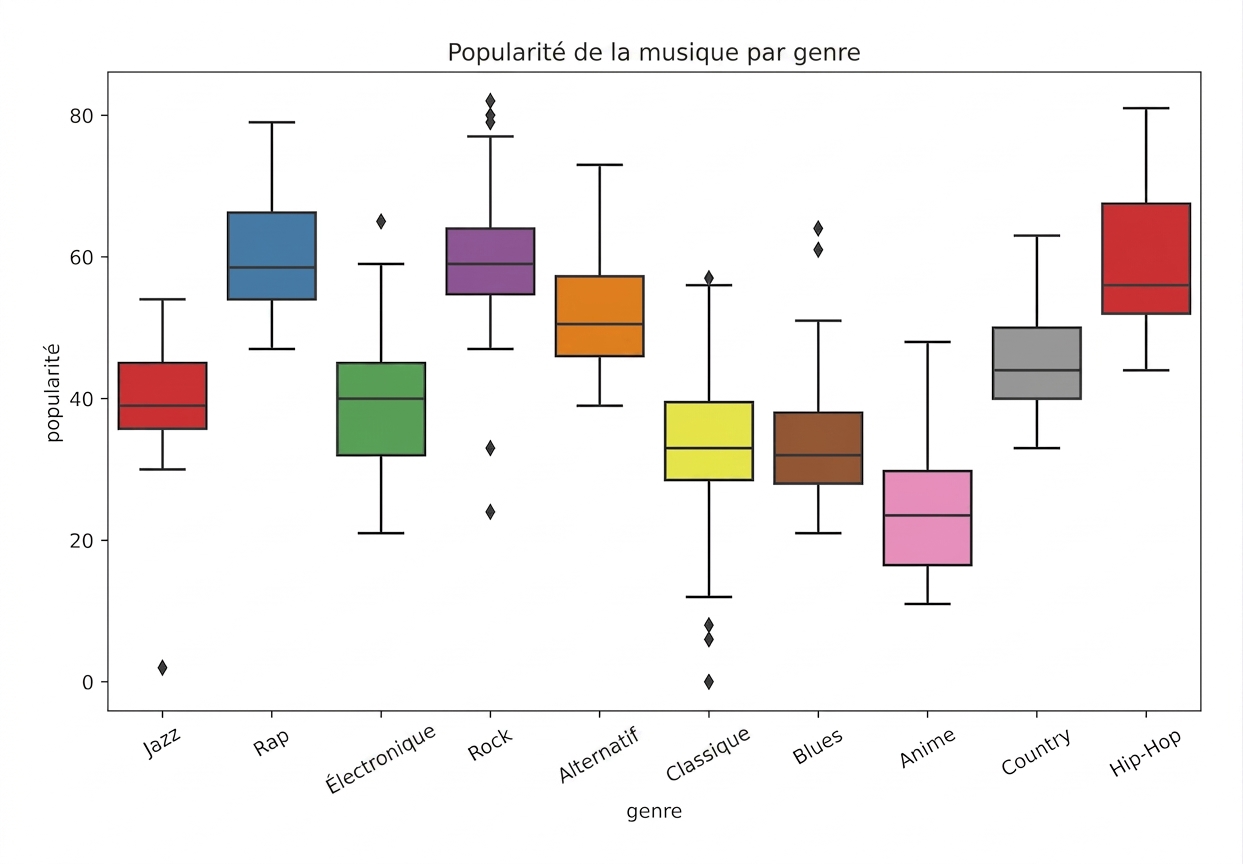
EDE avec variable catégorielle

Diagramme en boîtes montrant la popularité par genre

Apprentissage supervisé avec scikit-learn

Coder des variables fictives

import pandas as pd

music_df = pd.read_csv('music.csv')
music_dummies = pd.get_dummies(music_df["genre"], drop_first=True)
print(music_dummies.head())
     Anime    Blues    Classical    Country    Electronic    Hip-Hop    Jazz    Rap    Rock
0    0        0        0            0          0             0          1       0      0
1    0        0        0            0          0             0          0       1      0
2    0        0        0            0          1             0          0       0      0
3    0        0        0            0          0             0          0       0      1
4    0        0        0            0          0             0          0       1      0
music_dummies = pd.concat([music_df, music_dummies], axis=1)

music_dummies = music_dummies.drop("genre", axis=1)
Apprentissage supervisé avec scikit-learn

Coder des variables fictives

music_dummies = pd.get_dummies(music_df, drop_first=True)

print(music_dummies.columns)
Index(['popularity', 'acousticness', 'danceability', 'duration_ms', 'energy',
       'instrumentalness', 'liveness', 'loudness', 'speechiness', 'tempo',
       'valence', 'genre_Anime', 'genre_Blues', 'genre_Classical',
       'genre_Country', 'genre_Electronic', 'genre_Hip-Hop', 'genre_Jazz',
       'genre_Rap', 'genre_Rock'],
      dtype='object')
Apprentissage supervisé avec scikit-learn

Régression linéaire avec variables fictives

from sklearn.model_selection import cross_val_score, KFold
from sklearn.linear_model import LinearRegression
X = music_dummies.drop("popularity", axis=1).values
y = music_dummies["popularity"].values
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, 
                                                    random_state=42)

kf = KFold(n_splits=5, shuffle=True, random_state=42)
linreg = LinearRegression()
linreg_cv = cross_val_score(linreg, X_train, y_train, cv=kf, scoring="neg_mean_squared_error")
print(np.sqrt(-linreg_cv))
[8.15792932, 8.63117538, 7.52275279, 8.6205778, 7.91329988]
Apprentissage supervisé avec scikit-learn

Passons à la pratique !

Apprentissage supervisé avec scikit-learn

Preparing Video For Download...