Apprentissage supervisé avec scikit-learn
George Boorman
Core Curriculum Manager
Régression ridge/lasso : choisir alpha
KNN : choisir n_neighbors
Hyperparamètres : paramètres à fixer avant d'ajuster le modèle
alpha et n_neighborsEssayer de nombreuses valeurs d'hyperparamètres
Ajuster chaque modèle séparément
Évaluer leur performance
Choisir les meilleures valeurs
C'est l'optimisation des hyperparamètres
Indispensable : utiliser la validation croisée pour éviter le surapprentissage sur l'ensemble de test
On peut toujours scinder les données et faire la validation croisée sur l'ensemble d'entraînement
On réserve l'ensemble de test pour l'évaluation finale


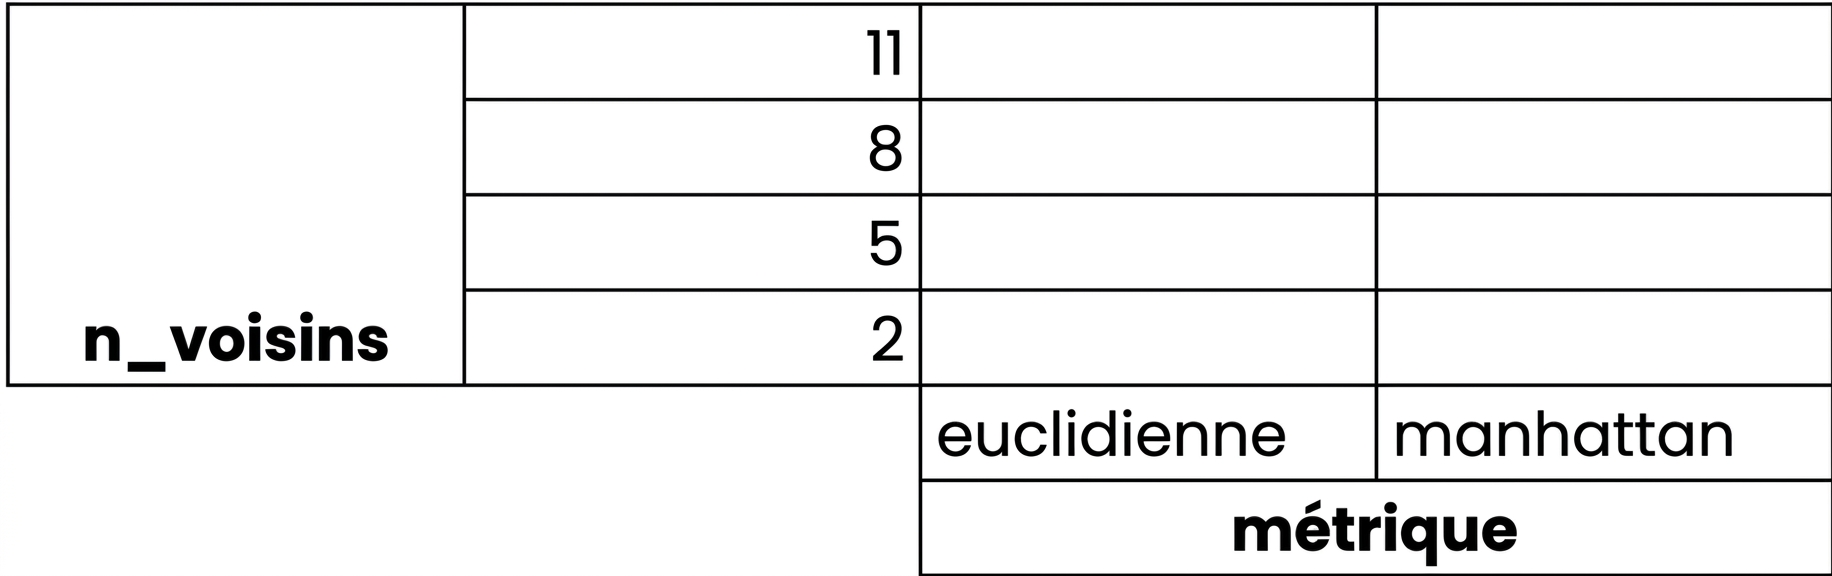
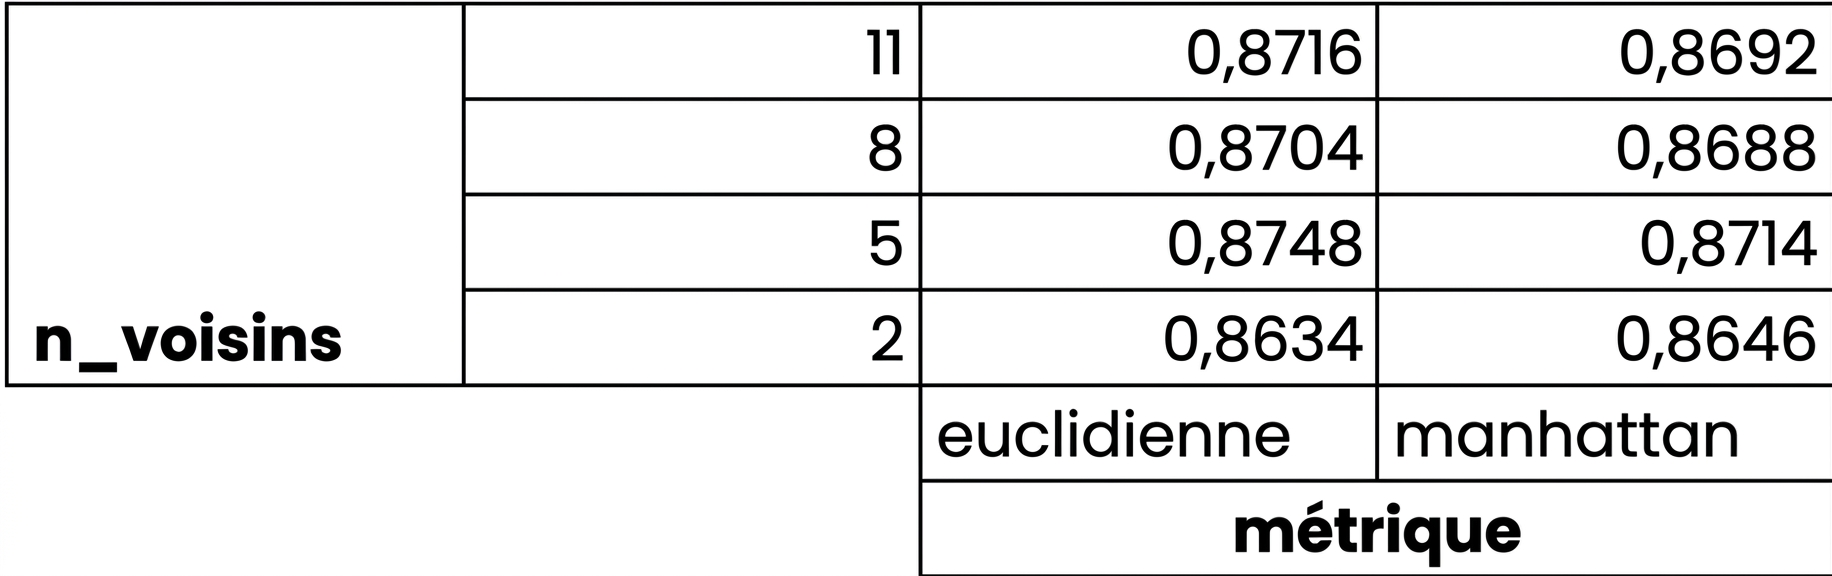
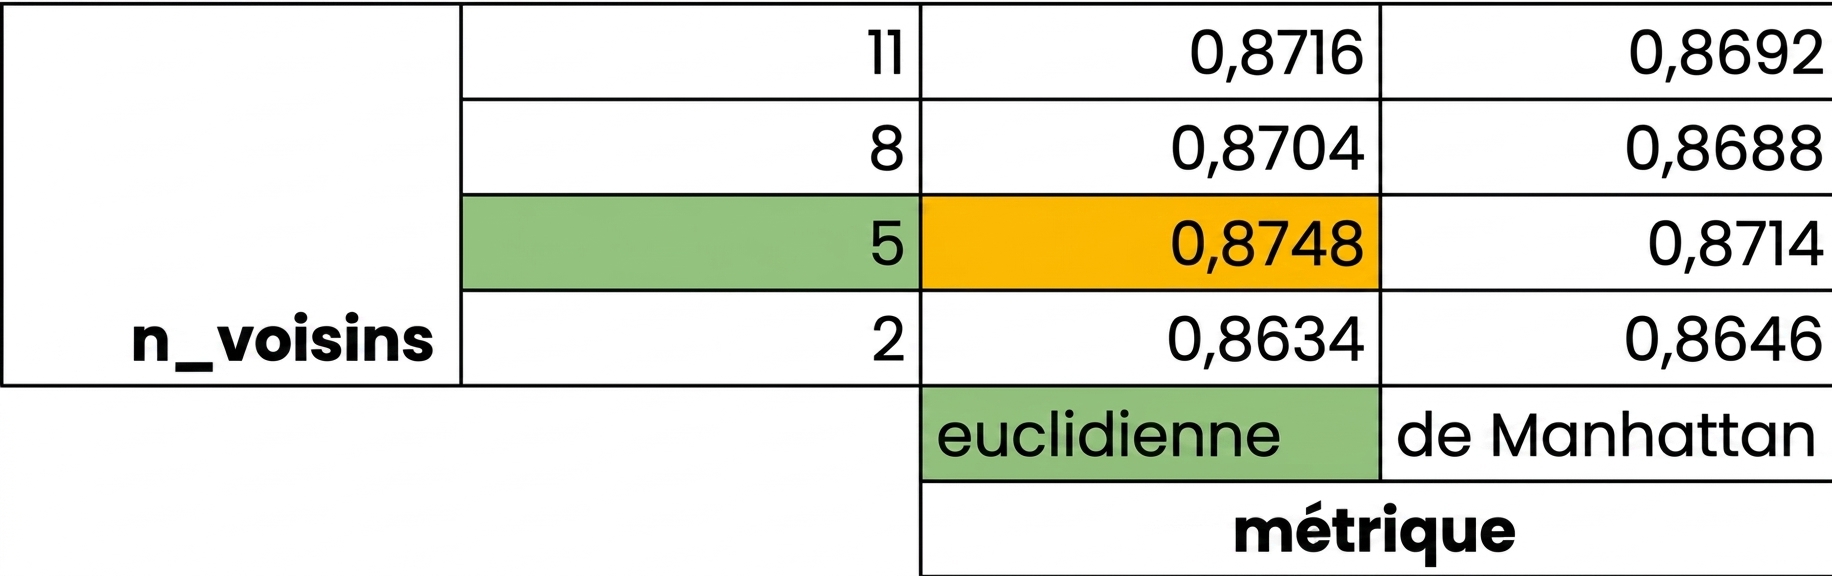
from sklearn.model_selection import GridSearchCVkf = KFold(n_splits=5, shuffle=True, random_state=42)param_grid = {"alpha": np.arange(0.0001, 1, 10), "solver": ["sag", "lsqr"]}ridge = Ridge()ridge_cv = GridSearchCV(ridge, param_grid, cv=kf)ridge_cv.fit(X_train, y_train)print(ridge_cv.best_params_, ridge_cv.best_score_)
{'alpha': 0.0001, 'solver': 'sag'}
0.7529912278705785
from sklearn.model_selection import RandomizedSearchCVkf = KFold(n_splits=5, shuffle=True, random_state=42) param_grid = {'alpha': np.arange(0.0001, 1, 10), "solver": ['sag', 'lsqr']} ridge = Ridge()ridge_cv = RandomizedSearchCV(ridge, param_grid, cv=kf, n_iter=2) ridge_cv.fit(X_train, y_train)print(ridge_cv.best_params_, ridge_cv.best_score_)
{'solver': 'sag', 'alpha': 0.0001}
0.7529912278705785
test_score = ridge_cv.score(X_test, y_test)print(test_score)
0.7564731534089224
Apprentissage supervisé avec scikit-learn