PCA के साथ Dimension reduction

Python में Unsupervised Learning

Benjamin Wilson

Director of Research at lateral.io

Dimension reduction

  • वही डेटा, कम फीचर्स के साथ प्रस्तुत करता है
  • मशीन लर्निंग पाइपलाइनों का अहम हिस्सा
  • PCA से किया जा सकता है
Python में Unsupervised Learning

PCA के साथ Dimension reduction

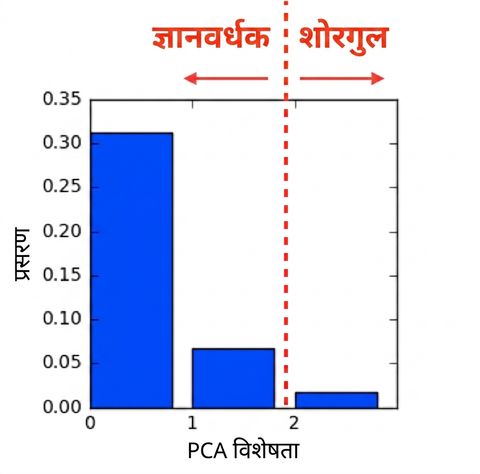
  • PCA फीचर्स variance के घटते क्रम में होते हैं
  • मानता है कि low-variance फीचर्स "noise" हैं
  • ... और high-variance फीचर्स सूचनात्मक हैं

बार प्लॉट: PCA फीचर नंबर बनाम variance, 1 और 2 के बीच वर्टिकल लाइन; बाएँ तीर "informative" और दाएँ तीर "noisy"

Python में Unsupervised Learning

PCA के साथ Dimension reduction

  • कितने फीचर्स रखने हैं, यह निर्दिष्ट करें
  • जैसे PCA(n_components=2)
  • पहले 2 PCA फीचर्स रखता है
  • Intrinsic dimension अच्छा विकल्प है
Python में Unsupervised Learning

Iris डेटासेट का Dimension reduction

  • samples = iris मापों की array (4 फीचर्स)
  • species = iris species नंबरों की list
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
pca.fit(samples)
PCA(n_components=2)
transformed = pca.transform(samples)
print(transformed.shape)
(150, 2)
Python में Unsupervised Learning

Iris डेटासेट 2 dimensions में

  • PCA ने dimension को 2 तक घटा दिया
  • सबसे ज्यादा variance वाले 2 PCA फीचर्स रखे
  • अहम जानकारी बची रही: species अलग-अलग हैं
import matplotlib.pyplot as plt
xs = transformed[:,0]
ys = transformed[:,1]
plt.scatter(xs, ys, c=species)
plt.show()
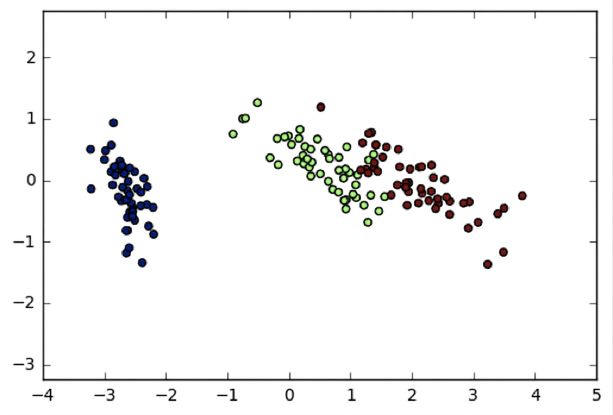
Iris डेटासेट पर किए गए PCA का स्कैटर प्लॉट

Python में Unsupervised Learning

PCA के साथ Dimension reduction

  • low-variance PCA फीचर्स हटाता है
  • मानता है कि high-variance फीचर्स सूचनात्मक हैं
  • यह मान्यता आमतौर पर सही बैठती है (जैसे iris में)
Python में Unsupervised Learning

Word frequency arrays

  • पंक्तियाँ डॉक्यूमेंट्स, कॉलम्स शब्द दर्शाते हैं
  • एंट्रीज़ हर डॉक्यूमेंट में हर शब्द की उपस्थिति मापती हैं
  • ... "tf-idf" से मापते हैं (आगे देखेंगे)
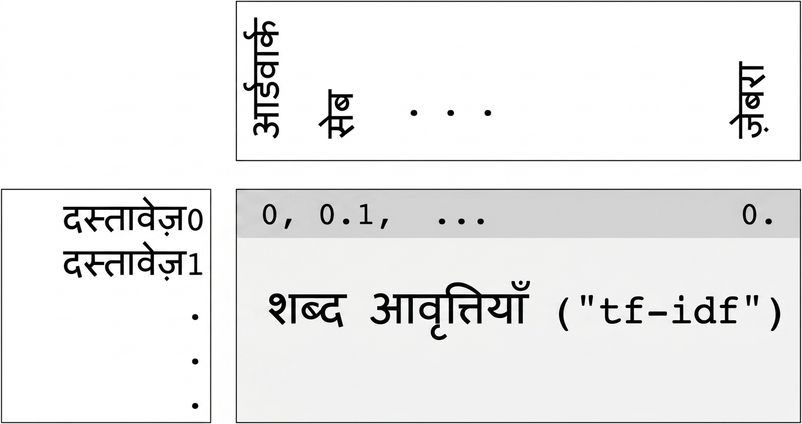
शब्द आवृत्ति array

Python में Unsupervised Learning

Sparse arrays और csr_matrix

  • "Sparse": अधिकतर एंट्रीज़ शून्य होती हैं
  • NumPy array की बजाय scipy.sparse.csr_matrix उपयोग कर सकते हैं
  • csr_matrix सिर्फ non-zero एंट्रीज़ याद रखती है (स्पेस बचता है!)

शब्द आवृत्ति array

Python में Unsupervised Learning

TruncatedSVD और csr_matrix

  • scikit-learn PCA csr_matrix सपोर्ट नहीं करता
  • इसकी जगह scikit-learn TruncatedSVD उपयोग करें
  • वही transformation करता है
from sklearn.decomposition import TruncatedSVD
model = TruncatedSVD(n_components=3)
model.fit(documents)  # documents is csr_matrix
transformed = model.transform(documents)
Python में Unsupervised Learning

अभ्यास करते हैं!

Python में Unsupervised Learning

Preparing Video For Download...