बेहतर क्लस्टरिंग के लिए फीचर ट्रांसफॉर्म करना

Python में Unsupervised Learning

Benjamin Wilson

Director of Research at lateral.io

Piedmont wines डेटासेट

  • 3 अलग-अलग रेड वाइन वेरायटीज़ के 178 सैंपल: Barolo, Grignolino और Barbera

  • फीचर्स रासायनिक संरचना मापते हैं, जैसे alcohol content

  • दृश्य गुण, जैसे "color intensity"

1 Source: https://archive.ics.uci.edu/ml/datasets/Wine
Python में Unsupervised Learning

वाइनों की क्लस्टरिंग

from sklearn.cluster import KMeans
model = KMeans(n_clusters=3)
labels = model.fit_predict(samples)
Python में Unsupervised Learning

क्लस्टर्स बनाम वेरायटीज़

df = pd.DataFrame({'labels': labels, 
                       'varieties': varieties})
ct = pd.crosstab(df['labels'], df['varieties'])

print(ct)
varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Python में Unsupervised Learning

फीचर variances

  • वाइन फीचर्स की variances बहुत अलग हैं!

  • किसी फीचर की variance उसके मानों के फैलाव को मापती है

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

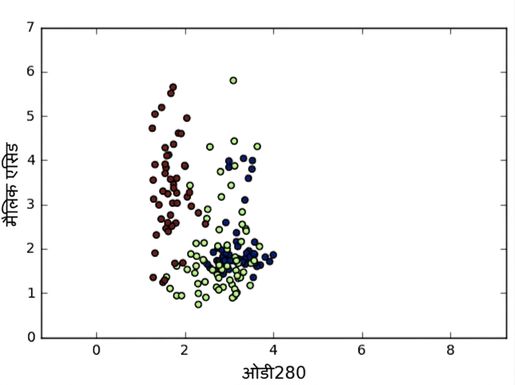
od280 वैरिएबल बनाम malic_acid वैरिएबल का स्कैटर प्लॉट

Python में Unsupervised Learning

फीचर variances

  • वाइन फीचर्स की variances बहुत अलग हैं!

  • किसी फीचर की variance उसके मानों के फैलाव को मापती है

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

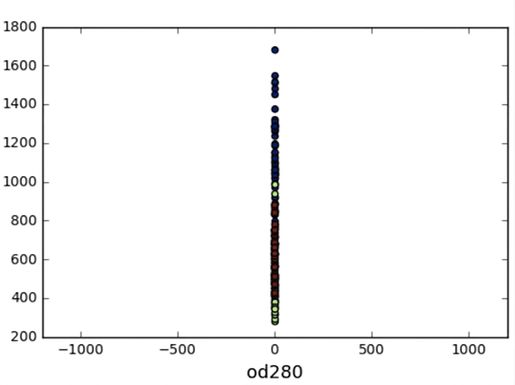
od280 वैरिएबल बनाम observation number का स्कैटर प्लॉट

Python में Unsupervised Learning

StandardScaler

  • kmeans में: फीचर variance = फीचर का प्रभाव

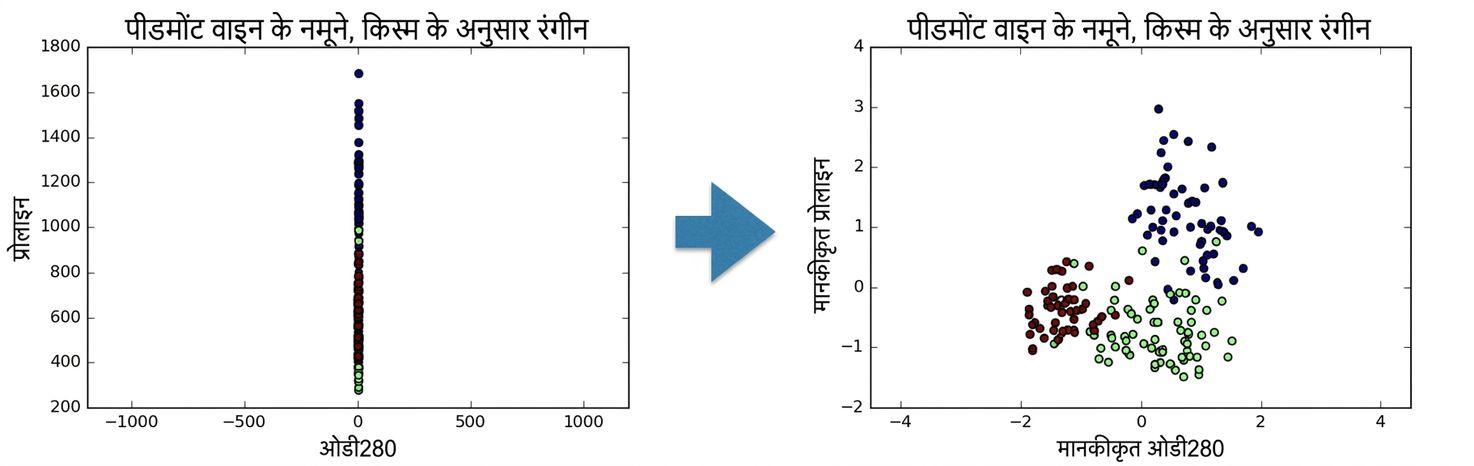
  • StandardScaler हर फीचर को mean 0 और variance 1 में बदलता है

  • ऐसे फीचर्स "standardized" कहलाते हैं

standardized od280 बनाम standardized proline का स्कैटर प्लॉट

Python में Unsupervised Learning

sklearn StandardScaler

from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
scaler.fit(samples) StandardScaler(copy=True, with_mean=True, with_std=True)
samples_scaled = scaler.transform(samples)
Python में Unsupervised Learning

Similar methods

  • StandardScaler और KMeans की मेथड्स मिलती-जुलती हैं

  • StandardScaler के साथ fit() / transform() का प्रयोग करें

  • KMeans के साथ fit() / predict() का प्रयोग करें

Python में Unsupervised Learning

पहले StandardScaler, फिर KMeans

  • दो स्टेप चाहिए: पहले StandardScaler, फिर KMeans

  • कई स्टेप जोड़ने के लिए sklearn pipeline का उपयोग करें

  • डेटा एक स्टेप से अगले में बहता है

Python में Unsupervised Learning

Pipelines कई स्टेप जोड़ती हैं

from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
kmeans = KMeans(n_clusters=3)

from sklearn.pipeline import make_pipeline
pipeline = make_pipeline(scaler, kmeans)
pipeline.fit(samples)
Pipeline(steps=...)
labels = pipeline.predict(samples)
Python में Unsupervised Learning

फीचर standardization से क्लस्टरिंग बेहतर होती है

फीचर standardization के साथ:

varieties  Barbera  Barolo  Grignolino
labels                                
0                0      59           3
1               48       0           3
2                0       0          65

बिना फीचर standardization परिणाम बहुत खराब थे:

varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Python में Unsupervised Learning

sklearn preprocessing स्टेप्स

  • StandardScaler एक "preprocessing" स्टेप है

  • MaxAbsScaler और Normalizer अन्य उदाहरण हैं

Python में Unsupervised Learning

अभ्यास करते हैं!

Python में Unsupervised Learning

Preparing Video For Download...