NMF का उपयोग करके रिकमेंडर सिस्टम बनाना

Python में Unsupervised Learning

Benjamin Wilson

Director of Research at lateral.io

समान लेख ढूँढना

  • एक बड़े ऑनलाइन अख़बार में इंजीनियर
  • कार्य: ग्राहक जो लेख पढ़ रहा है, उसी जैसे लेख सुझाएँ
  • समान लेखों के टॉपिक भी मिलते-जुलते हों
Python में Unsupervised Learning

रणनीति

  • शब्द-आवृत्ति एरे पर NMF लगाएँ
  • NMF फीचर वैल्यूज़ टॉपिक बताती हैं
  • ... इसलिए समान डॉक्यूमेंट्स की NMF फीचर वैल्यूज़ भी समान होंगी
  • NMF फीचर वैल्यूज़ की तुलना करें?
Python में Unsupervised Learning

शब्द-आवृत्ति एरे पर NMF लगाएँ

  • articles एक शब्द-आवृत्ति एरे है
from sklearn.decomposition import NMF
nmf = NMF(n_components=6)
nmf_features = nmf.fit_transform(articles)
Python में Unsupervised Learning

रणनीति

  • शब्द-आवृत्ति एरे पर NMF लगाएँ
  • NMF फीचर वैल्यूज़ टॉपिक बताती हैं
  • ... इसलिए समान डॉक्यूमेंट्स की NMF फीचर वैल्यूज़ भी समान होंगी
  • NMF फीचर वैल्यूज़ की तुलना करें?
Python में Unsupervised Learning

लेखों के वर्ज़न

  • एक ही डॉक्यूमेंट के अलग वर्ज़न में टॉपिक अनुपात समान रहते हैं
  • ... पर exact फीचर वैल्यूज़ अलग हो सकती हैं!
  •  
  •  

मज़बूत वर्ज़न: Dog bites man! Attack by terrible canine leaves man paralyzed...

Python में Unsupervised Learning

लेखों के वर्ज़न

  • एक ही डॉक्यूमेंट के अलग वर्ज़न में टॉपिक अनुपात समान रहते हैं
  • ... पर exact फीचर वैल्यूज़ अलग हो सकती हैं!
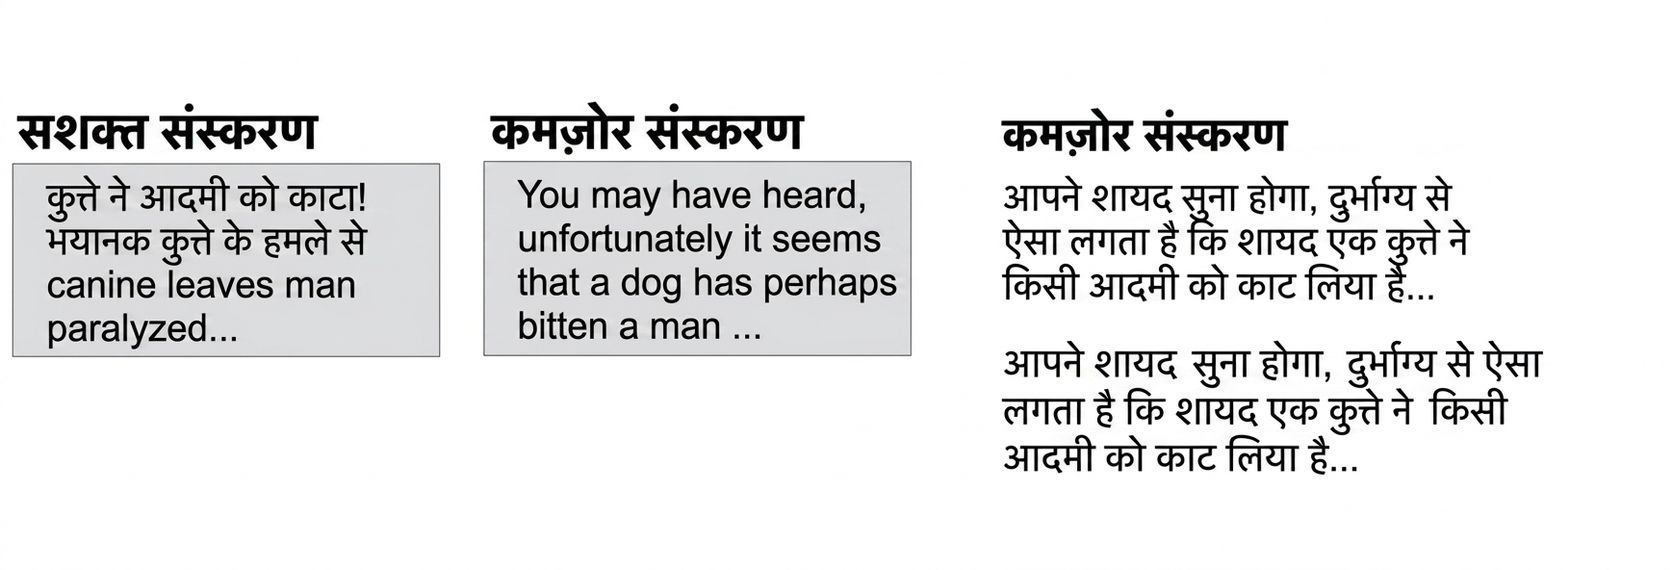
  • जैसे, एक वर्ज़न में बहुत से बेकार शब्द हों
  •  

कमज़ोर वर्ज़न: You may have heard, unfortunately it seems that a dog has perhaps bitten a man...

Python में Unsupervised Learning

लेखों के वर्ज़न

  • एक ही डॉक्यूमेंट के अलग वर्ज़न में टॉपिक अनुपात समान रहते हैं
  • ... पर exact फीचर वैल्यूज़ अलग हो सकती हैं!
  • जैसे, एक वर्ज़न में बहुत से बेकार शब्द हों
  • लेकिन सारे वर्ज़न ओरिजिन से गुजरती एक ही लाइन पर होते हैं
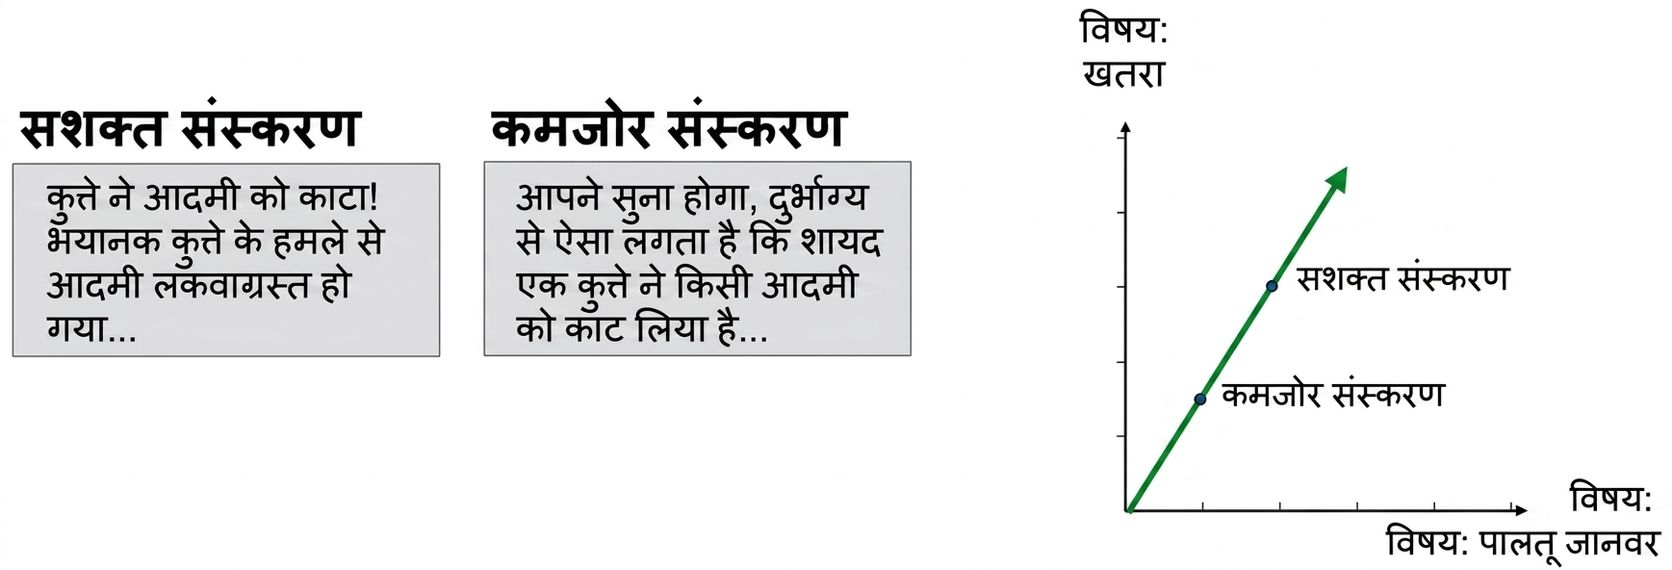
टॉपिक pets बनाम टॉपिक danger का स्कैटर प्लॉट, जिसमें मज़बूत और कमज़ोर वर्ज़न ओरिजिन से एक ही लाइन पर हैं

Python में Unsupervised Learning

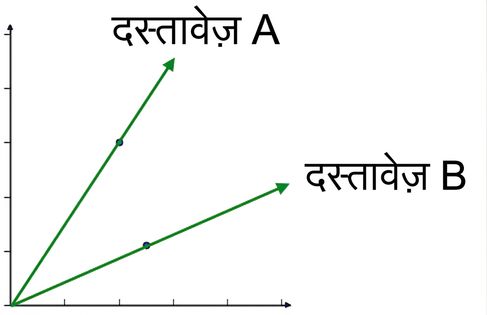
Cosine similarity

  • लाइनों के बीच के कोण का उपयोग करता है
  • वैल्यू जितनी अधिक, समानता उतनी अधिक
  • अधिकतम 1, जब कोण 0 डिग्री हो

डॉक्यूमेंट A और डॉक्यूमेंट B का स्कैटर प्लॉट, ओरिजिन से अलग-अलग कोणों पर जाती दो लाइनें

Python में Unsupervised Learning

Cosine similarities की गणना

from sklearn.preprocessing import normalize

norm_features = normalize(nmf_features)
# if has index 23 current_article = norm_features[23,:] similarities = norm_features.dot(current_article)
print(similarities)
[ 0.7150569   0.26349967 ..., 0.20323616  0.05047817]
Python में Unsupervised Learning

DataFrames और लेबल्स

  • DataFrame का उपयोग कर similarities को आर्टिकल टाइटल्स से लेबल करें
  • टाइटल्स एक लिस्ट में दिए हैं: titles
import pandas as pd

norm_features = normalize(nmf_features)
df = pd.DataFrame(norm_features, index=titles)
current_article = df.loc['Dog bites man']
similarities = df.dot(current_article)
Python में Unsupervised Learning

DataFrames और लेबल्स

print(similarities.nlargest())
Dog bites man                            1.000000
Hound mauls cat                          0.979946
Pets go wild!                            0.979708
Dachshunds are dangerous                 0.949641
Our streets are no longer safe           0.900474
dtype: float64
Python में Unsupervised Learning

अभ्यास करते हैं!

Python में Unsupervised Learning

Preparing Video For Download...