Python में Unsupervised Learning
Benjamin Wilson
Director of Research at lateral.io
species  setosa  versicolor  virginica
labels
0             0           2         36
1            50           0          0
2             0          48         14
pandas
species
print(species)
['setosa', 'setosa', 'versicolor', 'virginica', ... ]
import pandas as pd
df = pd.DataFrame({'labels': labels, 'species': species})
print(df)
     labels     species
0         1      setosa
1         1      setosa
2         2  versicolor
3         2   virginica
4         1      setosa
...
ct = pd.crosstab(df['labels'], df['species'])
print(ct)
यदि species की जानकारी न हो, तो क्लस्टरिंग का मूल्यांकन कैसे करेंगे?
केवल samples और उनके cluster labels का उपयोग करें
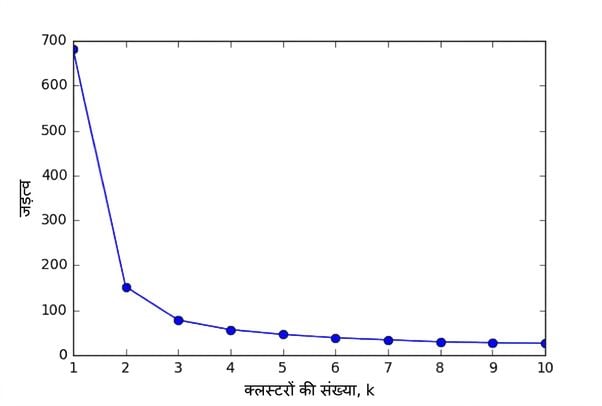
अच्छी क्लस्टरिंग में क्लस्टर कॉम्पैक्ट होते हैं
हर क्लस्टर के samples पास-पास होते हैं
fit()
inertia_
from sklearn.cluster import KMeans

model = KMeans(n_clusters=3)
model.fit(samples)
print(model.inertia_)
78.9408414261