LSTM और GRU सेल्स

इंटरमीडिएट Deep Learning with PyTorch

Michal Oleszak

Machine Learning Engineer

शॉर्ट-टर्म मेमोरी समस्या
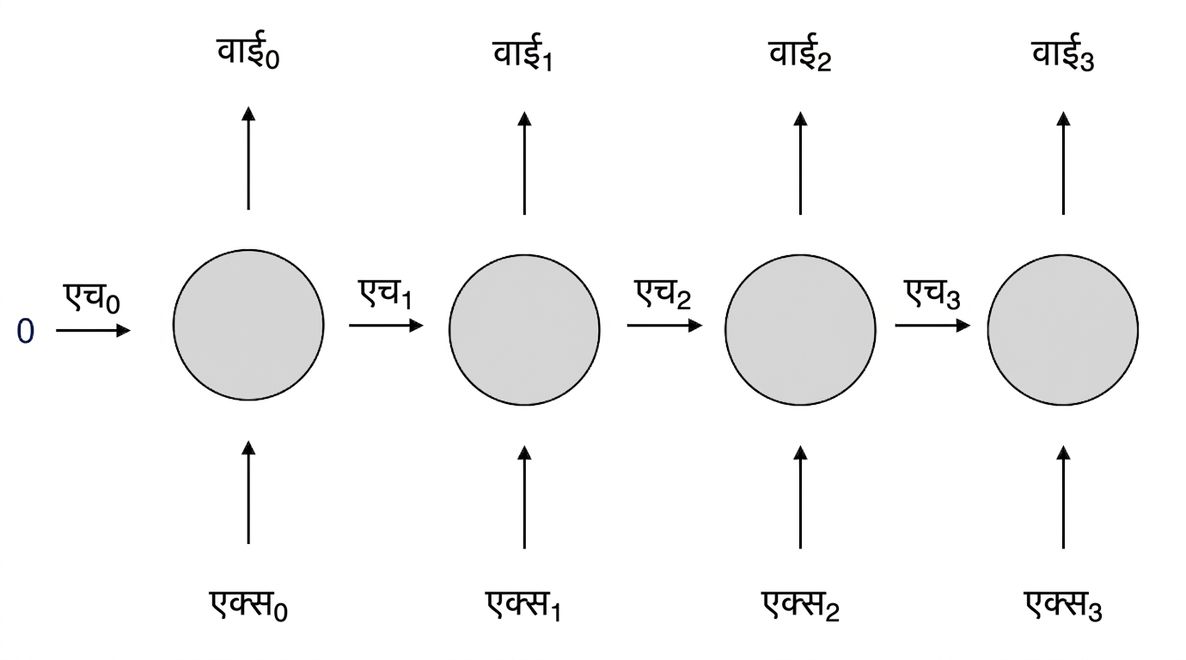
  • RNN सेल्स हिडन स्टेट से मेमोरी रखते हैं
  • यह मेमोरी बहुत शॉर्ट-टर्म होती है
  • दो ज़्यादा शक्तिशाली सेल्स इसे सुलझाते हैं:
    • LSTM (Long Short-Term Memory) सेल
    • GRU (Gated Recurrent Unit) सेल

रिकरेंट न्यूरॉन की स्कीमा. टाइम स्टेप 2 पर यह h2 और x2 इनपुट लेता है और y2 और h3 आउटपुट देता है.

इंटरमीडिएट Deep Learning with PyTorch

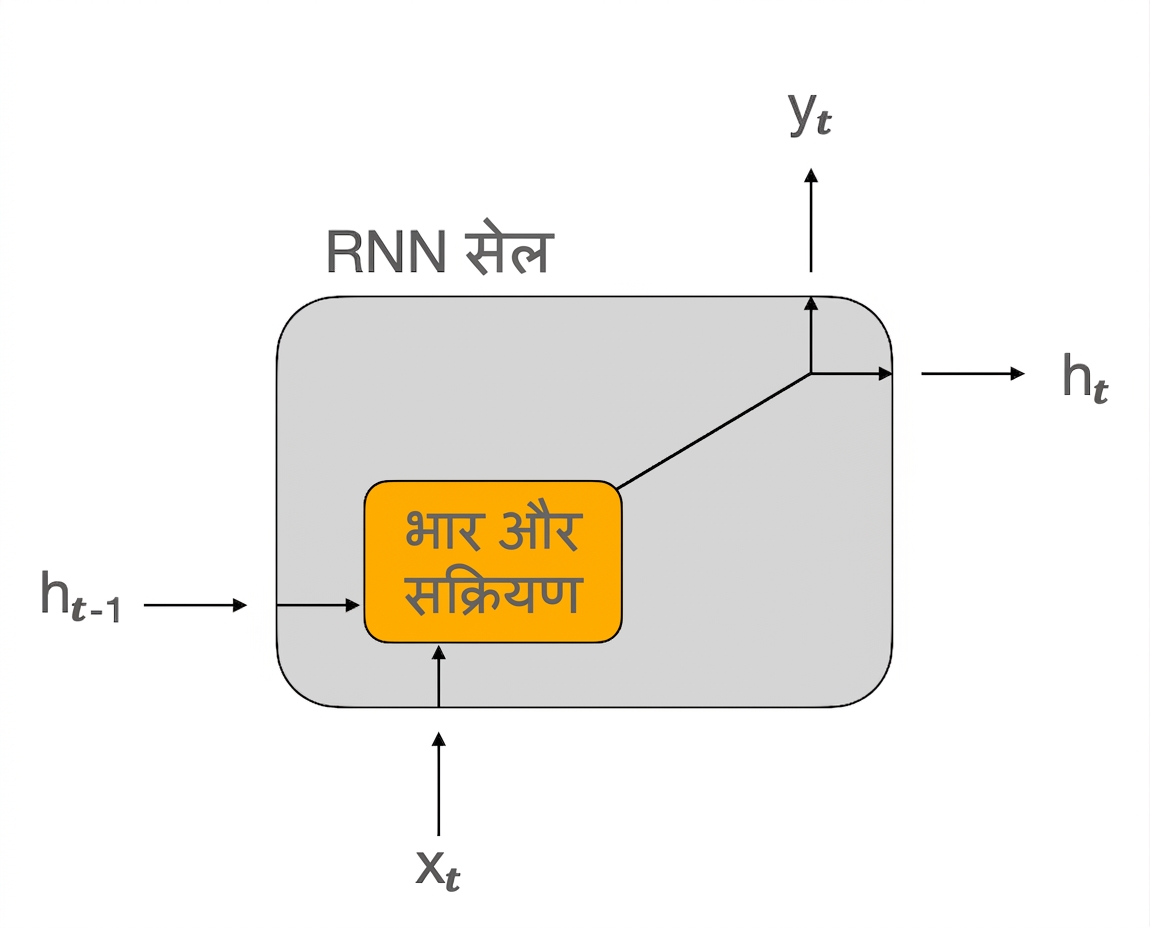
RNN सेल

RNN सेल की स्कीमा.

  • दो इनपुट:
    • करंट इनपुट डेटा x
    • प्रीवियस हिडन स्टेट h
  • दो आउटपुट:
    • करंट आउटपुट y
    • नेक्स्ट हिडन स्टेट h
इंटरमीडिएट Deep Learning with PyTorch

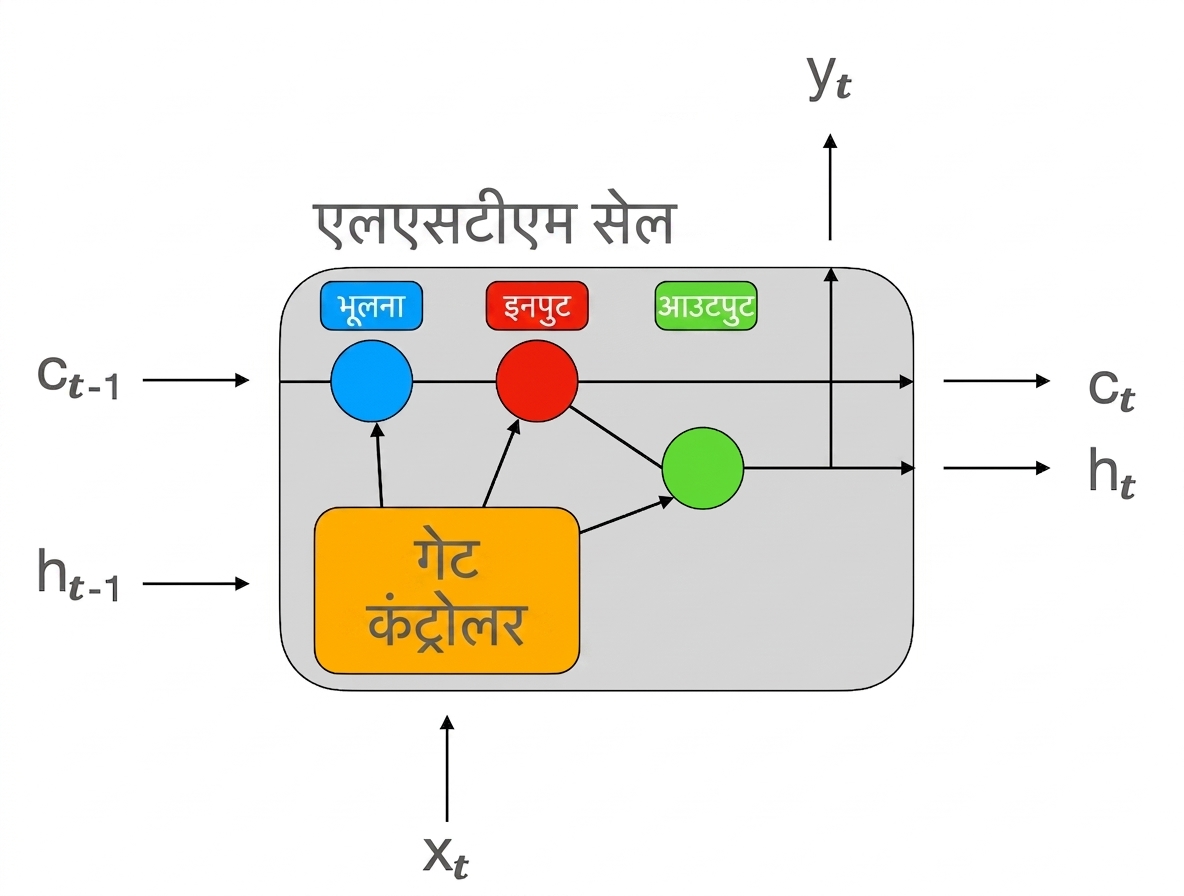
LSTM सेल

LSTM सेल की स्कीमा.

  • आउटपुट h और y एक जैसे हैं
  • तीन इनपुट/आउटपुट (दो हिडन स्टेट):

    • h: शॉर्ट-टर्म स्टेट
    • c: लॉन्ग-टर्म स्टेट
  • तीन "गेट":

    • Forget gate: लॉन्ग-टर्म मेमोरी से क्या हटाएँ
    • Input gate: लॉन्ग-टर्म मेमोरी में क्या सहेजें
    • Output gate: करंट टाइम स्टेप पर क्या लौटाएँ
इंटरमीडिएट Deep Learning with PyTorch

PyTorch में LSTM

class Net(nn.Module):
    def __init__(self, input_size):
        super().__init__()

self.lstm = nn.LSTM( input_size=1, hidden_size=32, num_layers=2, batch_first=True, ) self.fc = nn.Linear(32, 1)
def forward(self, x): h0 = torch.zeros(2, x.size(0), 32) c0 = torch.zeros(2, x.size(0), 32)
out, _ = self.lstm(x, (h0, c0))
out = self.fc(out[:, -1, :]) return out
  • __init__():
    • nn.RNN को nn.LSTM से बदलें
  • forward():
    • एक और हिडन स्टेट c जोड़ें
    • c और h को ज़ीरो से इनिशियलाइज़ करें
    • दोनों हिडन स्टेट्स को lstm लेयर में पास करें
इंटरमीडिएट Deep Learning with PyTorch

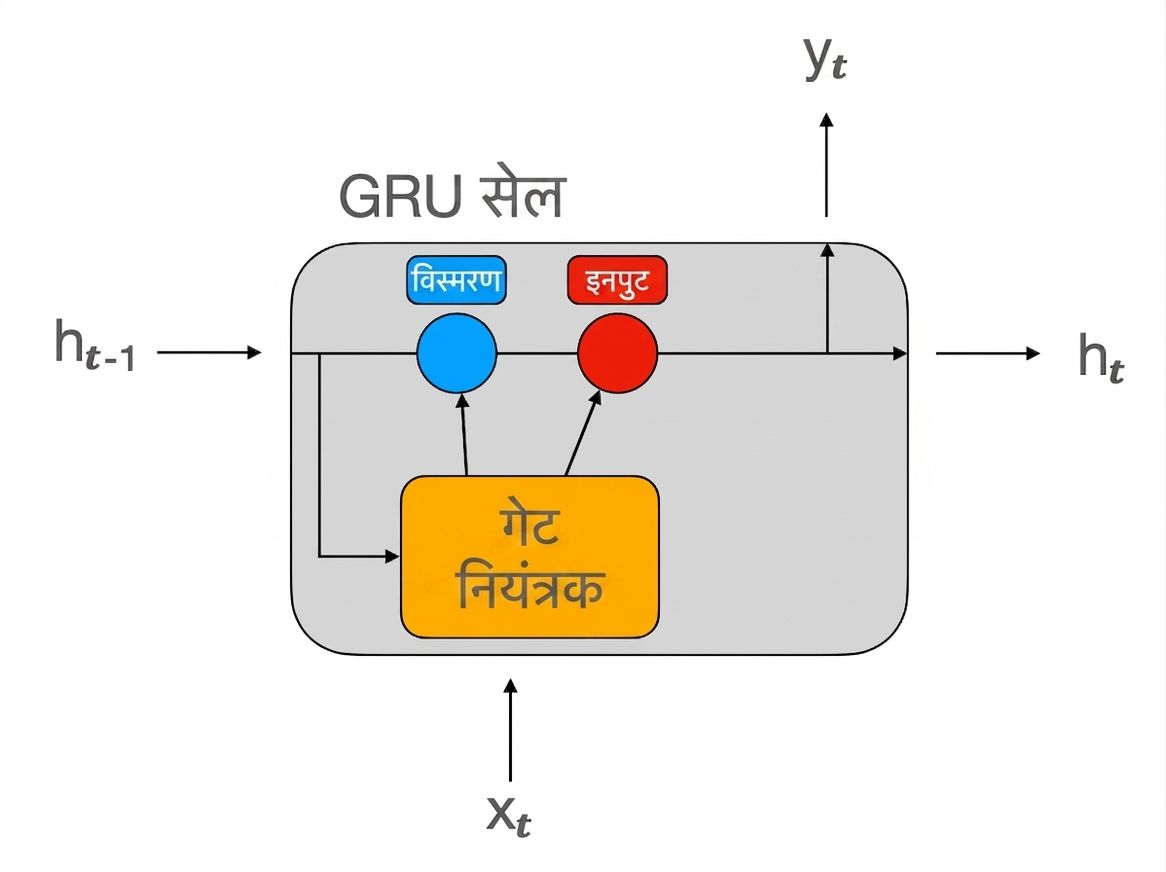
GRU सेल

GRU सेल की स्कीमा.

  • LSTM का सरल रूप
  • सिर्फ एक हिडन स्टेट
  • आउटपुट गेट नहीं होता
इंटरमीडिएट Deep Learning with PyTorch

PyTorch में GRU

class Net(nn.Module):
    def __init__(self, input_size):
        super().__init__()

self.gru = nn.GRU( input_size=1, hidden_size=32, num_layers=2, batch_first=True, ) self.fc = nn.Linear(32, 1)
def forward(self, x): h0 = torch.zeros(2, x.size(0), 32) out, _ = self.gru(x, h0) out = self.fc(out[:, -1, :]) return out
  • __init__():
    • nn.RNN को nn.GRU से बदलें
  • forward():
    • gru लेयर का उपयोग करें
इंटरमीडिएट Deep Learning with PyTorch

RNN, LSTM, या GRU — किसे चुनें?

  • अब RNN का उपयोग कम होता है
  • GRU, LSTM से सरल = कम computation
  • सापेक्ष परफॉर्मेंस उपयोग-केस पर निर्भर करती है
  • दोनों आज़माएँ और तुलना करें

LSTM और GRU सेल्स की स्कीमा.

इंटरमीडिएट Deep Learning with PyTorch

अभ्यास करते हैं!

इंटरमीडिएट Deep Learning with PyTorch

Preparing Video For Download...