Vanishing और Exploding gradients

इंटरमीडिएट Deep Learning with PyTorch

Michal Oleszak

Machine Learning Engineer

Vanishing gradients
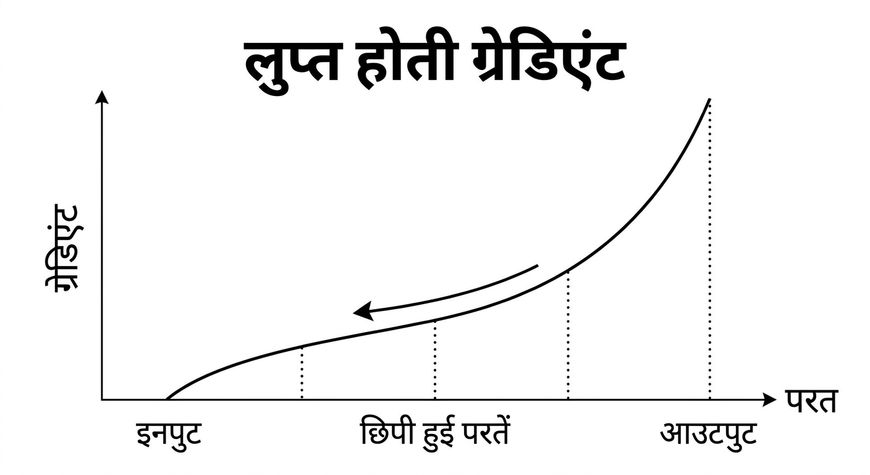
  • Backward pass में gradients छोटे होते जाते हैं
  • शुरुआती लेयर्स को छोटे parameter अपडेट मिलते हैं
  • मॉडल सीखता नहीं

ग्रेडिएंट साइज बनाम लेयर इंडेक्स के ग्राफ: शुरुआती लेयर्स में gradients छोटे हैं

इंटरमीडिएट Deep Learning with PyTorch

Exploding gradients

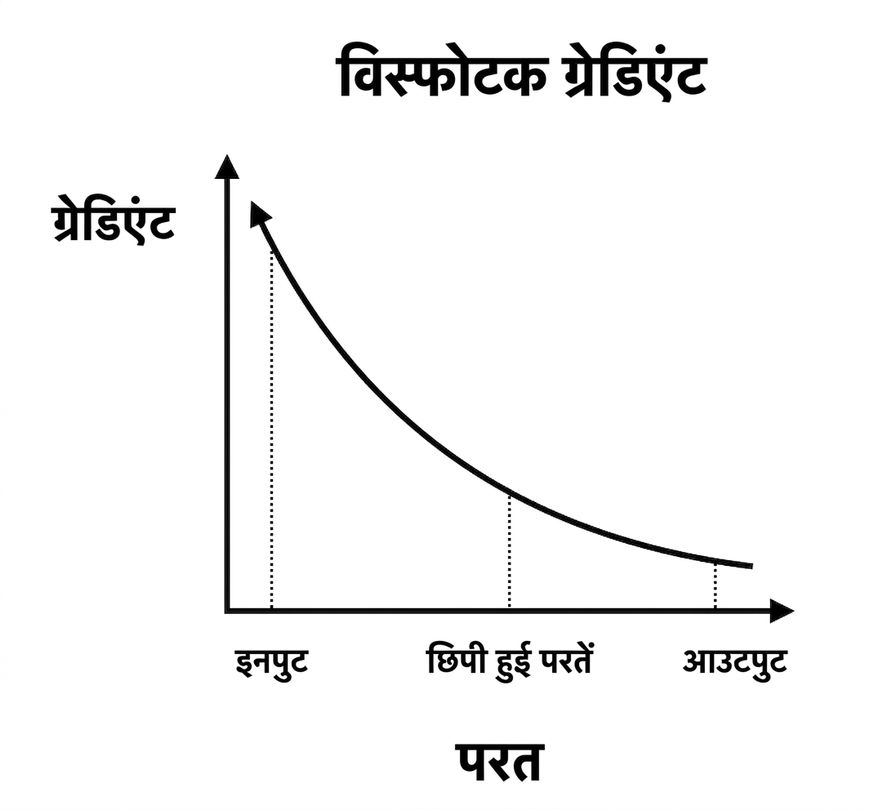
  • Gradients बड़े होते जाते हैं
  • Parameter अपडेट बहुत बड़े हो जाते हैं
  • ट्रेनिंग diverge करती है

ग्रेडिएंट साइज बनाम लेयर इंडेक्स के ग्राफ: शुरुआती लेयर्स में gradients बड़े हैं

इंटरमीडिएट Deep Learning with PyTorch

Unstable gradients का समाधान

  1. सही weights initialization
  2. अच्छी activations
  3. Batch normalization


तीन स्टेप

इंटरमीडिएट Deep Learning with PyTorch

Weights initialization

layer = nn.Linear(8, 1)
print(layer.weight)
Parameter containing:
tensor([[-0.0195,  0.0992,  0.0391,  0.0212,
         -0.3386, -0.1892, -0.3170,  0.2148]])
इंटरमीडिएट Deep Learning with PyTorch

Weights initialization

अच्छी initialization सुनिश्चित करती है:

  • लेयर इनपुट का variance = लेयर आउटपुट का variance
  • लेयर से पहले और बाद gradients का variance समान रहे


इसे कैसे पाएं, यह activation पर निर्भर है:

  • ReLU और समान के लिए He/Kaiming initialization उपयोग करें
इंटरमीडिएट Deep Learning with PyTorch

Weights initialization

import torch.nn.init as init

init.kaiming_uniform_(layer.weight)
print(layer.weight)
Parameter containing:
tensor([[-0.3063, -0.2410,  0.0588,  0.2664,
          0.0502, -0.0136,  0.2274,  0.0901]])
इंटरमीडिएट Deep Learning with PyTorch

He / Kaiming initialization

init.kaiming_uniform_(self.fc1.weight)
init.kaiming_uniform_(self.fc2.weight)
init.kaiming_uniform_(
  self.fc3.weight,
  nonlinearity="sigmoid",
)
इंटरमीडिएट Deep Learning with PyTorch

He / Kaiming initialization

import torch.nn as nn
import torch.nn.init as init

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.fc2 = nn.Linear(16, 8)
        self.fc3 = nn.Linear(8, 1)


init.kaiming_uniform_(self.fc1.weight) init.kaiming_uniform_(self.fc2.weight) init.kaiming_uniform_( self.fc3.weight, nonlinearity="sigmoid", )


    def forward(self, x):
        x = nn.functional.relu(self.fc1(x))
        x = nn.functional.relu(self.fc2(x))
        x = nn.functional.sigmoid(self.fc3(x))
        return x


इंटरमीडिएट Deep Learning with PyTorch

Activation functions

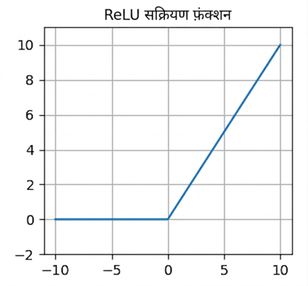
ReLU फंक्शन का प्लॉट. शून्य से नीचे मानों पर रेखा शून्य पर समतल; शून्य से ऊपर सकारात्मक ढलान.

  • अक्सर डिफॉल्ट activation के रूप में उपयोग
  • nn.functional.relu()
  • नकारात्मक इनपुट पर आउटपुट शून्य - dying neurons
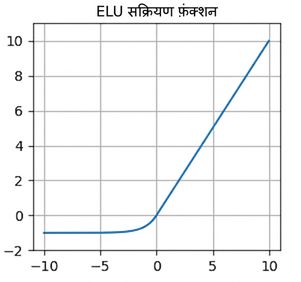
ELU फंक्शन का प्लॉट. ReLU जैसा, पर नकारात्मक से सकारात्मक क्षेत्र में स्मूद ट्रांजिशन.

  • nn.functional.elu()
  • नकारात्मक मानों पर non-zero gradients - dying neurons से बचाव
  • औसत आउटपुट लगभग शून्य - vanishing gradients से मदद
इंटरमीडिएट Deep Learning with PyTorch

Batch normalization

एक लेयर के बाद:

  1. लेयर के आउटपुट normalize करें:

    • mean घटाएँ
    • standard deviation से भाग दें
  2. सीखे हुए parameters से normalized आउटपुट scale और shift करें

मॉडल हर लेयर के लिए optimal input distribution सीखता है:

  • loss तेज़ी से घटता है
  • unstable gradients के खिलाफ मदद मिलती है
इंटरमीडिएट Deep Learning with PyTorch

Batch normalization

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.bn1 = nn.BatchNorm1d(16)

        ...


def forward(self, x): x = self.fc1(x) x = self.bn1(x) x = nn.functional.elu(x) ...
इंटरमीडिएट Deep Learning with PyTorch

अभ्यास करते हैं!

इंटरमीडिएट Deep Learning with PyTorch

Preparing Video For Download...