Dimensionsreduktion med PCA

Oövervakad inlärning i Python

Benjamin Wilson

Director of Research at lateral.io

Dimensionsreduktion

  • Representerar samma data med färre särdrag
  • Viktig del av maskininlärningspipelines
  • Kan utföras med PCA
Oövervakad inlärning i Python

Dimensionsreduktion med PCA

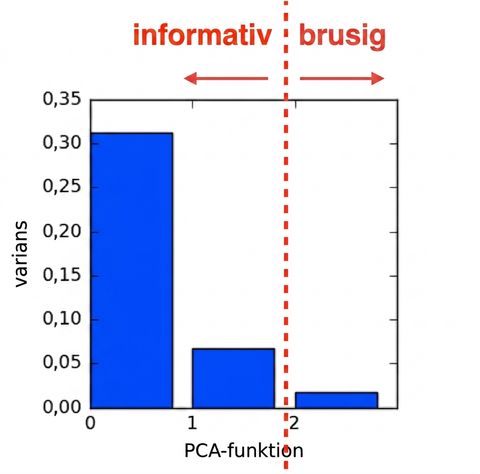
  • PCA-särdrag ordnas efter minskande varians
  • Antar att särdrag med låg varians är "brus"
  • ... och att särdrag med hög varians är informativa

Stapeldiagram över PCA-särdragsnummer mot varians med en vertikal linje mellan 1 och 2, med vänsterpil märkt informativa och högerpil märkt brusiga

Oövervakad inlärning i Python

Dimensionsreduktion med PCA

  • Ange hur många särdrag som ska behållas
  • T.ex. PCA(n_components=2)
  • Behåller de 2 första PCA-särdragen
  • Det inneboende dimensionstalet är ett bra val
Oövervakad inlärning i Python

Dimensionsreduktion av irisdatamängden

  • samples = array med irismätningar (4 särdrag)
  • species = lista med artnummer för iris
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
pca.fit(samples)
PCA(n_components=2)
transformed = pca.transform(samples)
print(transformed.shape)
(150, 2)
Oövervakad inlärning i Python

Irisdatamängden i 2 dimensioner

  • PCA har reducerat dimensionen till 2
  • Behåller de 2 PCA-särdrag med högst varians
  • Viktig information bevaras: arterna förblir åtskilda
import matplotlib.pyplot as plt
xs = transformed[:,0]
ys = transformed[:,1]
plt.scatter(xs, ys, c=species)
plt.show()
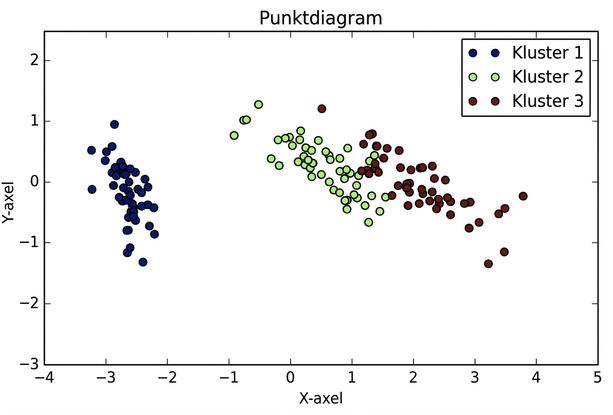
Spridningsdiagram av PCA utförd på irisdatamängden

Oövervakad inlärning i Python

Dimensionsreduktion med PCA

  • Tar bort PCA-särdrag med låg varians
  • Antar att särdrag med hög varians är informativa
  • Antagandet håller i praktiken (t.ex. för iris)
Oövervakad inlärning i Python

Ordfrekvensarrayer

  • Rader representerar dokument, kolumner representerar ord
  • Poster mäter förekomsten av varje ord i varje dokument
  • ... mäts med "tf-idf" (mer om det senare)
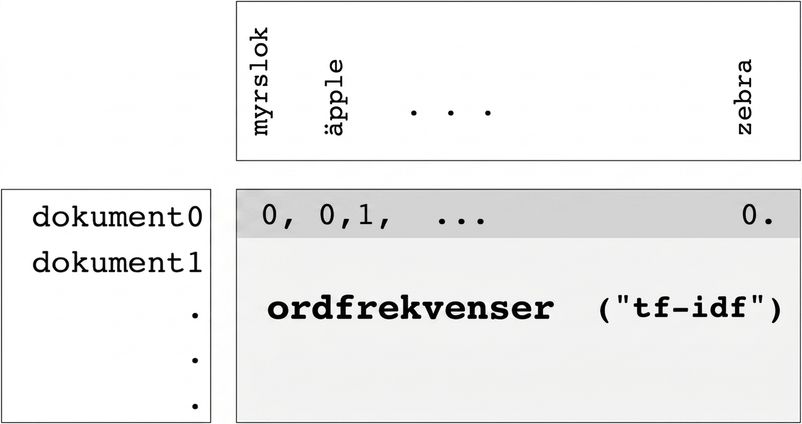
Ordfrekvensarray

Oövervakad inlärning i Python

Glesa arrayer och csr_matrix

  • "Gles": de flesta poster är noll
  • Använd scipy.sparse.csr_matrix i stället för NumPy-array
  • csr_matrix lagrar bara nollskilda poster (sparar utrymme!)

Ordfrekvensarray

Oövervakad inlärning i Python

TruncatedSVD och csr_matrix

  • PCA i scikit-learn stöder inte csr_matrix
  • Använd TruncatedSVD i scikit-learn i stället
  • Utför samma transformation
from sklearn.decomposition import TruncatedSVD
model = TruncatedSVD(n_components=3)
model.fit(documents)  # documents is csr_matrix
transformed = model.transform(documents)
Oövervakad inlärning i Python

Nu kör vi en övning!

Oövervakad inlärning i Python

Preparing Video For Download...