Oövervakad inlärning i Python
Benjamin Wilson
Director of Research at lateral.io
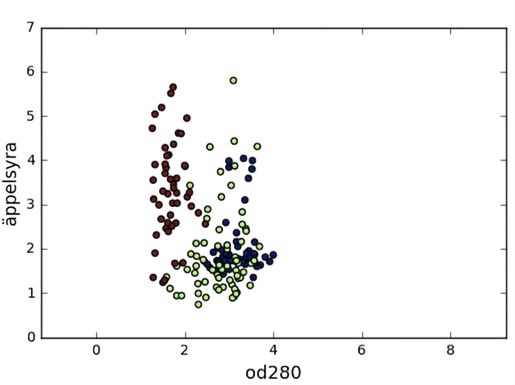
178 sampel från 3 olika sorters rödvin: Barolo, Grignolino och Barbera
Särdragen mäter kemisk sammansättning, t.ex. alkoholhalt
Visuella egenskaper som "färgintensitet"
from sklearn.cluster import KMeans
model = KMeans(n_clusters=3)
labels = model.fit_predict(samples)
df = pd.DataFrame({'labels': labels, 'varieties': varieties}) ct = pd.crosstab(df['labels'], df['varieties'])print(ct)
varieties Barbera Barolo Grignolino
labels
0 29 13 20
1 0 46 1
2 19 0 50
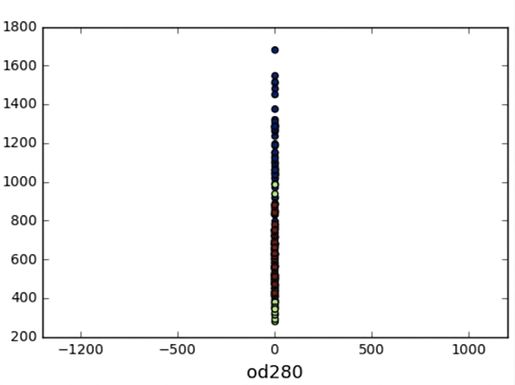
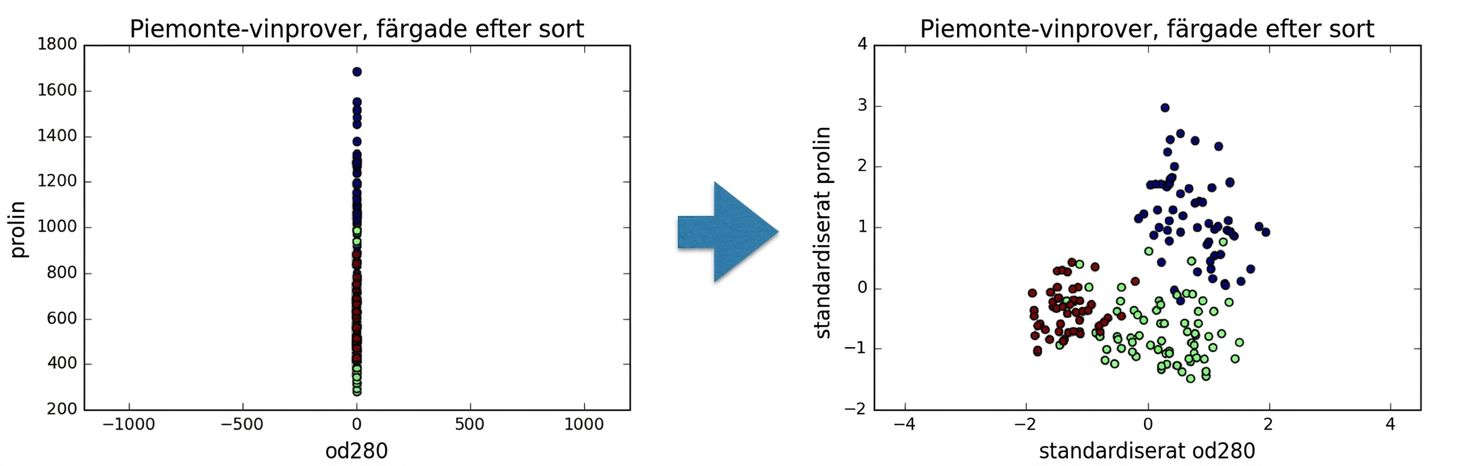
Vinets särdrag har mycket olika varians!
Variansen för ett särdrag mäter spridningen av dess värden
feature variance
alcohol 0.65
malic_acid 1.24
...
od280 0.50
proline 99166.71

Vinets särdrag har mycket olika varians!
Variansen för ett särdrag mäter spridningen av dess värden
feature variance
alcohol 0.65
malic_acid 1.24
...
od280 0.50
proline 99166.71

I k-means: särdragsvarians = särdragets inflytande
StandardScaler transformerar varje särdrag till medelvärde 0 och varians 1
Särdragen kallas då "standardiserade"

from sklearn.preprocessing import StandardScalerscaler = StandardScaler()scaler.fit(samples) StandardScaler(copy=True, with_mean=True, with_std=True)samples_scaled = scaler.transform(samples)
StandardScaler och KMeans har liknande metoder
Använd fit() / transform() med StandardScaler
Använd fit() / predict() med KMeans
Två steg krävs: StandardScaler, sedan KMeans
Använd en sklearn-pipeline för att kombinera flera steg
Data flödar från ett steg till nästa
from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans scaler = StandardScaler() kmeans = KMeans(n_clusters=3)from sklearn.pipeline import make_pipelinepipeline = make_pipeline(scaler, kmeans)pipeline.fit(samples)
Pipeline(steps=...)
labels = pipeline.predict(samples)
Med särdragsstandardisering:
varieties Barbera Barolo Grignolino
labels
0 0 59 3
1 48 0 3
2 0 0 65
Utan särdragsstandardisering – sämre resultat:
varieties Barbera Barolo Grignolino
labels
0 29 13 20
1 0 46 1
2 19 0 50
StandardScaler är ett steg för "förbehandling"
MaxAbsScaler och Normalizer är andra exempel
Oövervakad inlärning i Python