Utvärdera en klustring

Oövervakad inlärning i Python

Benjamin Wilson

Director of Research at lateral.io

Utvärdera en klustring

  • Kan kontrollera mot t.ex. iris-arter
  • ... men vad om det inte finns arter att jämföra med?
  • Mät kvaliteten på en klustring
  • Hjälper till att välja antal kluster
Oövervakad inlärning i Python

Iris: kluster vs arter

  • k-means hittade 3 kluster bland iris-samplen
  • Motsvarar klustren arterna?
species  setosa  versicolor  virginica
labels
0             0           2         36
1            50           0          0
2             0          48         14
Oövervakad inlärning i Python

Korstabulering med pandas

  • Kluster vs arter är en "korstabulering"
  • Använd biblioteket pandas
  • Arterna för varje sampel ges som en lista species
print(species)
['setosa', 'setosa', 'versicolor', 'virginica', ... ]
Oövervakad inlärning i Python

Matcha etiketter och arter

import pandas as pd
df = pd.DataFrame({'labels': labels, 'species': species})
print(df)
     labels     species
0         1      setosa
1         1      setosa
2         2  versicolor
3         2   virginica
4         1      setosa
...
Oövervakad inlärning i Python

Korstabulering av etiketter och arter

ct = pd.crosstab(df['labels'], df['species'])
print(ct)
species  setosa  versicolor  virginica
labels
0             0           2         36
1            50           0          0
2             0          48         14

Hur utvärderar man en klustring om det inte finns artinformation?

Oövervakad inlärning i Python

Mäta klustringskvalitet

  • Använder bara sampel och deras klustetikett

  • En bra klustring har täta kluster

  • Samplen inom varje kluster ligger nära varandra

Oövervakad inlärning i Python

Tröghetsmomentet mäter klustringskvalitet

  • Mäter hur spridda klustren är (lägre är bättre)
  • Avstånd från varje sampel till klustrets centroid
  • Efter fit() tillgängligt som attributet inertia_
  • k-means försöker minimera tröghetsmomentet när kluster väljs
from sklearn.cluster import KMeans

model = KMeans(n_clusters=3)
model.fit(samples)
print(model.inertia_)
78.9408414261
Oövervakad inlärning i Python

Antal kluster

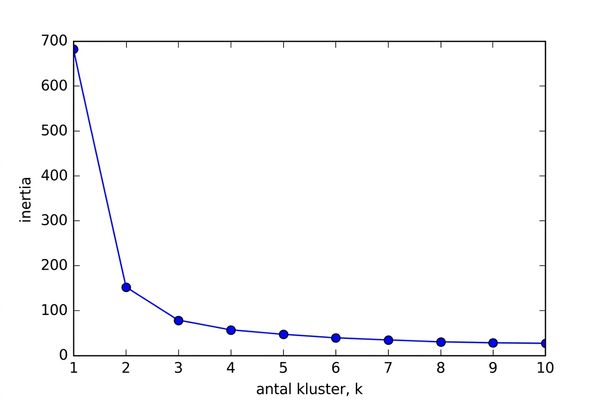
  • Klustringar av iris-datamängden med olika antal kluster
  • Fler kluster ger lägre tröghet
  • Vad är det bästa antalet kluster?

Linjediagram över antal kluster vs. tröghet

Oövervakad inlärning i Python

Hur många kluster ska man välja?

  • En bra klustring har täta kluster (dvs. låg tröghet)
  • ... men inte för många kluster!
  • Välj en "armbåge" i tröghetskurvan
  • Där tröghetsminskningen börjar plana ut
  • T.ex. är 3 ett bra val för iris-datamängden

Linjediagram över antal kluster vs. tröghet

Oövervakad inlärning i Python

Nu kör vi en övning!

Oövervakad inlärning i Python

Preparing Video For Download...