Datarensning i Python
Adel Nehme
VP of AI Curriculum, DataCamp

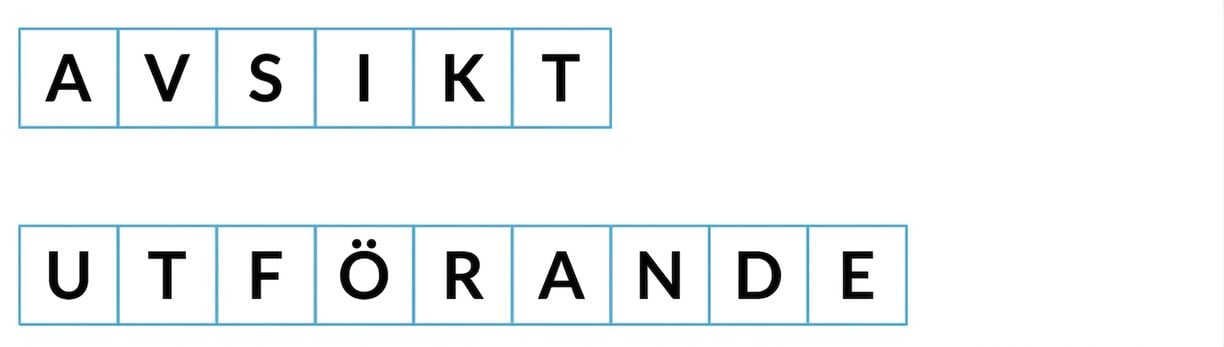
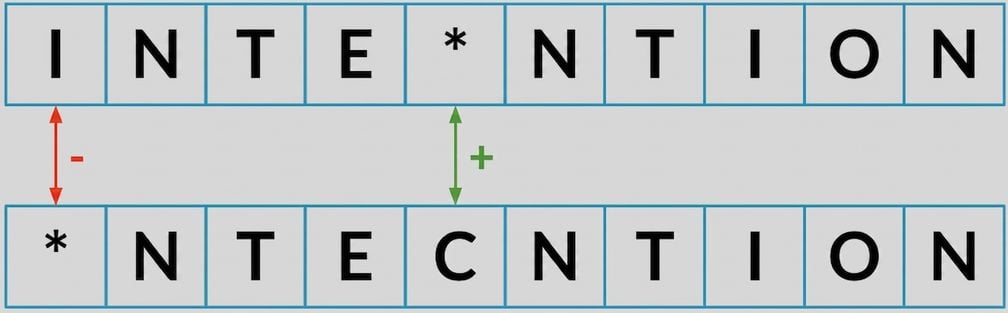
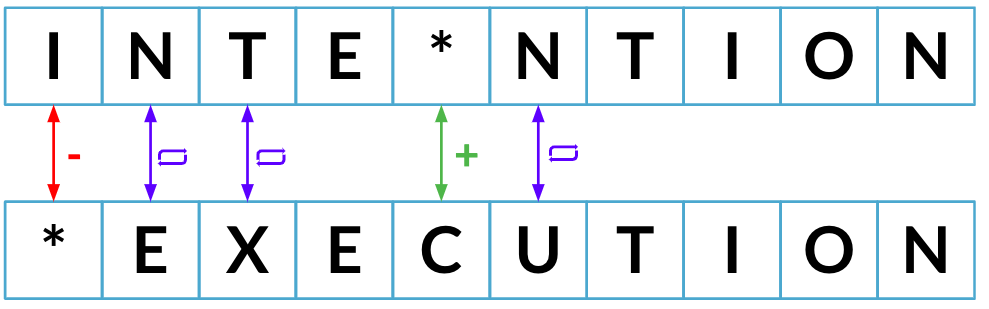
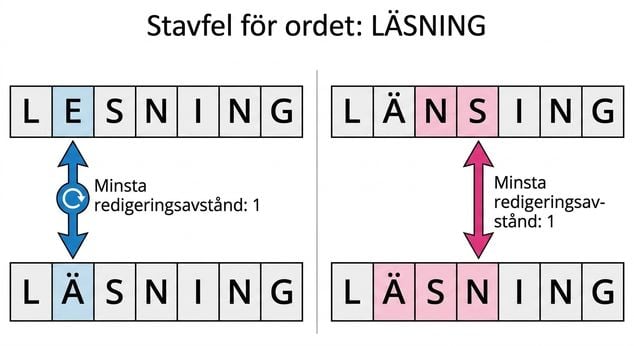
Minsta möjliga antal steg för att gå från en sträng till en annan

Minsta möjliga antal steg för att gå från en sträng till en annan


Minsta redigeringsavstånd hittills: 2
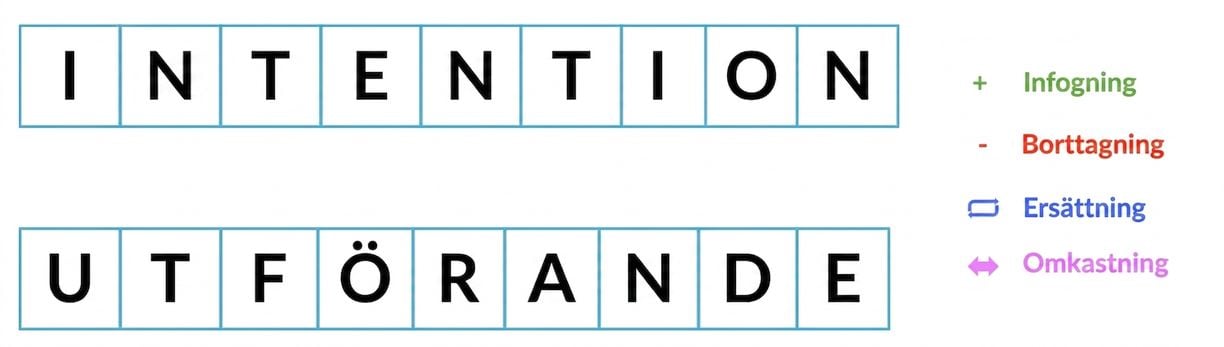
Minsta redigeringsavstånd: 5

| Algoritm | Operationer |
|---|---|
| Damerau-Levenshtein | infogning, substitution, borttagning, transposition |
| Levenshtein | infogning, substitution, borttagning |
| Hamming | endast substitution |
| Jaro distance | endast transposition |
| ... | ... |
Möjliga paket: nltk, thefuzz, textdistance ..
| Algoritm | Operationer |
|---|---|
| Damerau-Levenshtein | infogning, substitution, borttagning, transposition |
| Levenshtein | infogning, substitution, borttagning |
| Hamming | endast substitution |
| Jaro distance | endast transposition |
| ... | ... |
Möjliga paket: thefuzz
# Lets us compare between two strings from thefuzz import fuzz# Compare reeding vs reading fuzz.WRatio('Reeding', 'Reading')
86
# Partial string comparison
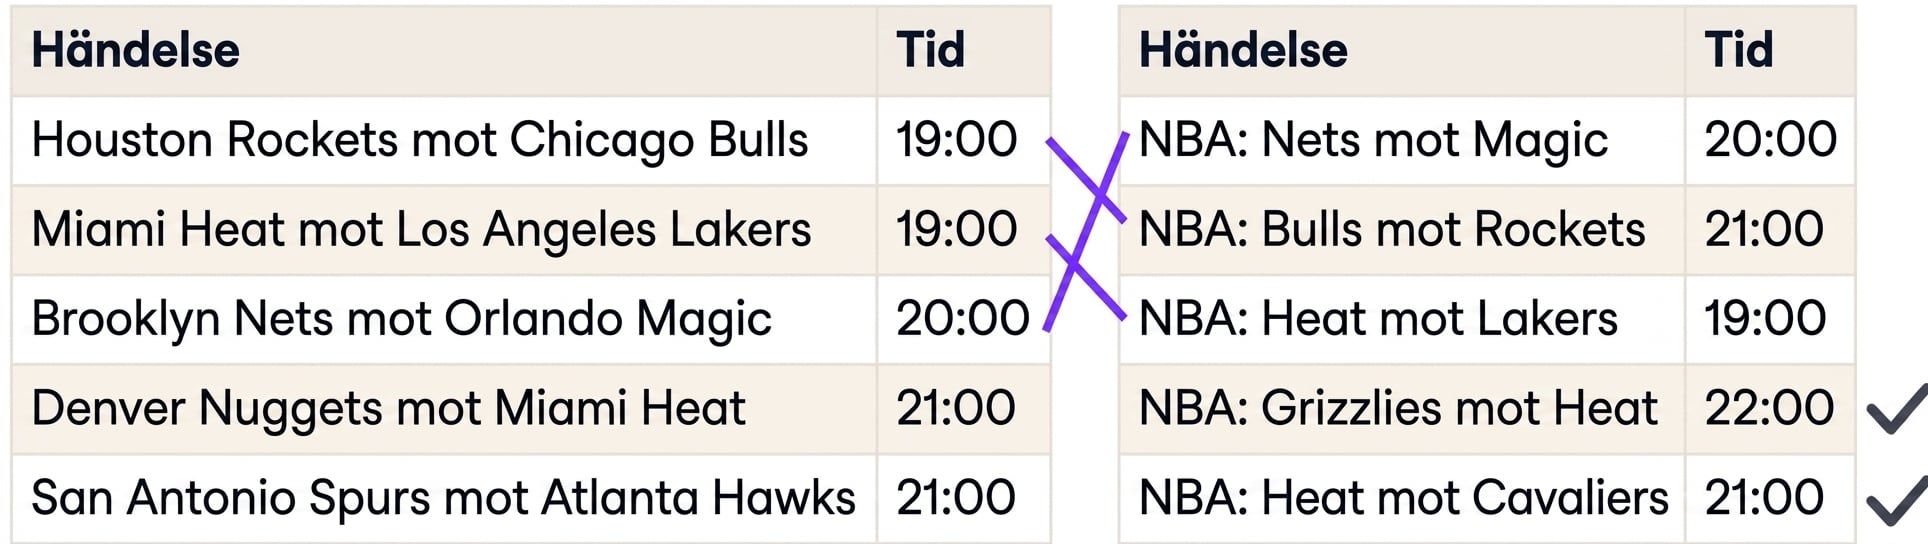
fuzz.WRatio('Houston Rockets', 'Rockets')
90
# Partial string comparison with different order
fuzz.WRatio('Houston Rockets vs Los Angeles Lakers', 'Lakers vs Rockets')
86
# Import process
from thefuzz import process
# Define string and array of possible matches
string = "Houston Rockets vs Los Angeles Lakers"
choices = pd.Series(['Rockets vs Lakers', 'Lakers vs Rockets',
'Houson vs Los Angeles', 'Heat vs Bulls'])
process.extract(string, choices, limit = 2)
[('Rockets vs Lakers', 86, 0), ('Lakers vs Rockets', 86, 1)]
Kapitel 2
Använd .replace() för att slå ihop "eur" till "Europe"
Vad händer om det finns för många varianter?
"EU", "eur", "Europ", "Europa", "Erope", "Evropa"...
Stränglikhet!
print(survey['state'].unique())
id state
0 California
1 Cali
2 Calefornia
3 Calefornie
4 Californie
5 Calfornia
6 Calefernia
7 New York
8 New York City
...
categories
state
0 California
1 New York
# For each correct category for state in categories['state']:# Find potential matches in states with typoes matches = process.extract(state, survey['state'], limit = survey.shape[0])# For each potential match match for potential_match in matches: # If high similarity score if potential_match[1] >= 80:# Replace typo with correct category survey.loc[survey['state'] == potential_match[0], 'state'] = state

Datarensning i Python