Unikhetsbegränsningar

Datarensning i Python

Adel Nehme

VP of AI Curriculum, DataCamp

Vad är dublettvärden?

Alla kolumner har samma värden

first_name last_name address height weight
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
Datarensning i Python

Vad är dublettvärden?

De flesta kolumner har samma värden

first_name last_name address height weight
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 194 cm 87 kg
Datarensning i Python

Varför uppstår de?

duplicate_1

Datarensning i Python

Varför uppstår de?

duplicate_2

Datarensning i Python

Varför uppstår de?

duplicate_3

Datarensning i Python

Hur hittar man dublettvärden?

# Print the header
height_weight.head()
  first_name last_name                       address  height  weight
0       Lane     Reese              534-1559 Nam St.     181      64
1       Ivor    Pierce             102-3364 Non Road     168      66
2      Roary    Gibson   P.O. Box 344, 7785 Nisi Ave     191      99
3    Shannon    Little  691-2550 Consectetuer Street     185      65
4      Abdul       Fry                4565 Risus St.     169      65
Datarensning i Python

Hur hittar man dublettvärden?

# Get duplicates across all columns
duplicates = height_weight.duplicated()
print(duplicates)
1       False
...     ....
22      True
23      False
...     ...
Datarensning i Python

Hur hittar man dublettvärden?

# Get duplicate rows
duplicates = height_weight.duplicated()
height_weight[duplicates]
    first_name last_name                               address  height  weight
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
Datarensning i Python

Hur hittar man dublettrader?

Metoden .duplicated()

subset: Lista med kolumnnamn att kontrollera för dubletter.

keep: Om första ('first'), sista ('last') eller alla (False) dublettvärden ska behållas.

# Column names to check for duplication
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
Datarensning i Python

Hur hittar man dublettrader?

# Output duplicate values
height_weight[duplicates]
    first_name last_name                               address  height  weight
1         Ivor    Pierce                     102-3364 Non Road     168      66
22        Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
Datarensning i Python

Hur hittar man dublettrader?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
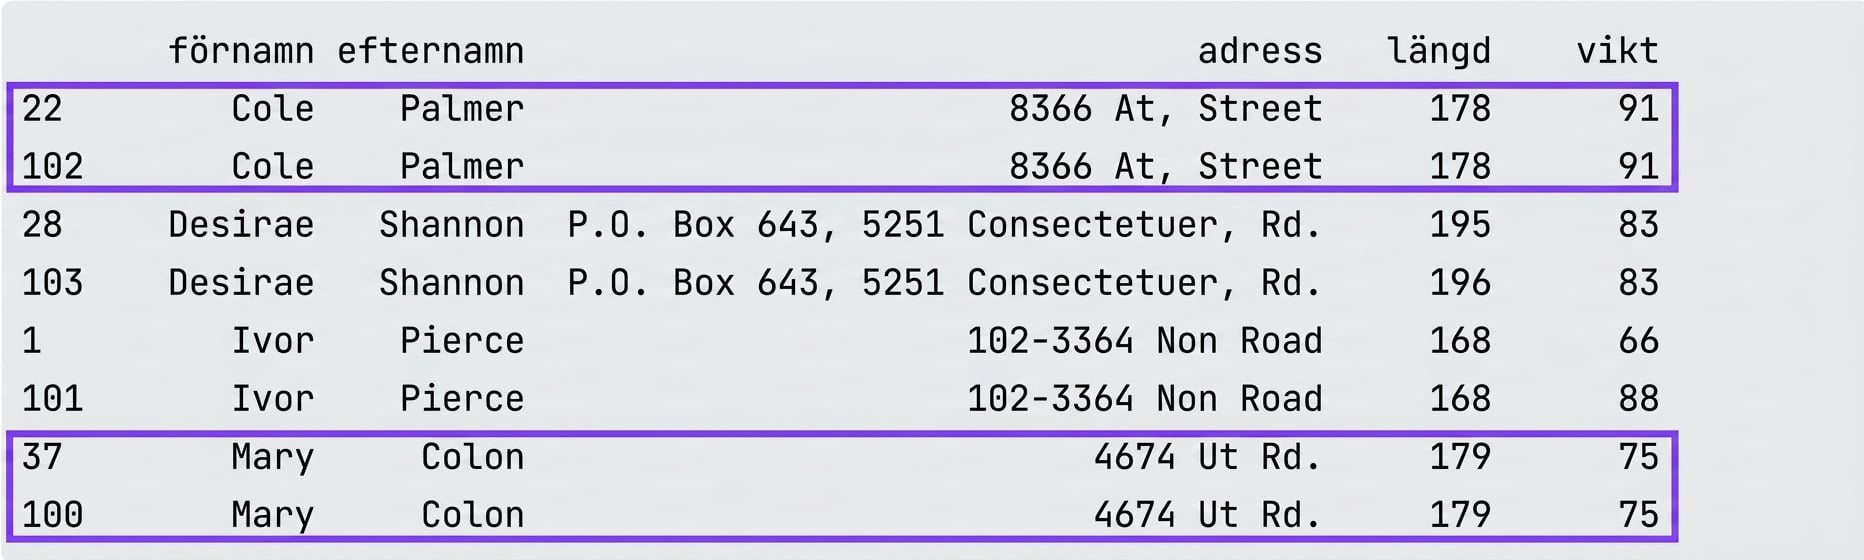
    first_name last_name                               address  height  weight
22        Cole    Palmer                       8366 At, Street     178      91
102       Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
Datarensning i Python

Hur hittar man dublettrader?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
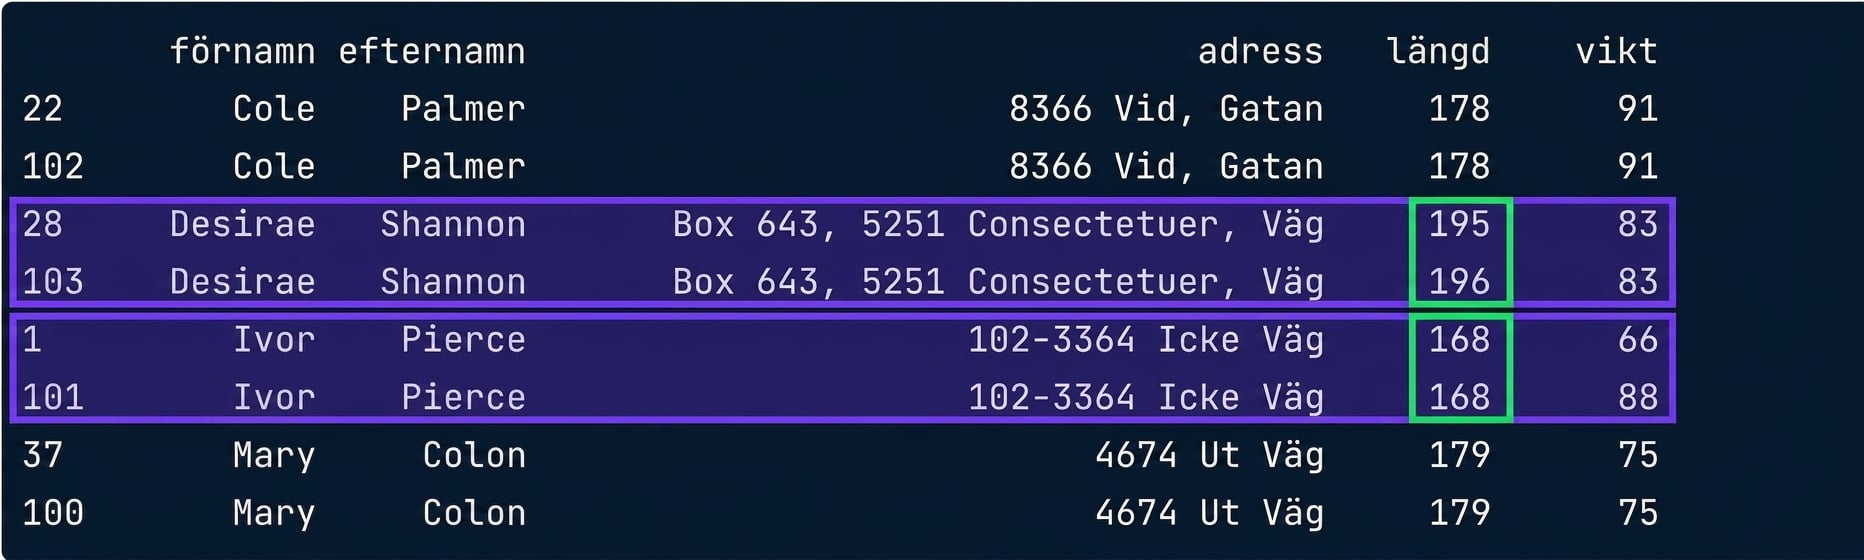
1_3_full_duplicates.png

Datarensning i Python

Hur hittar man dublettrader?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

1_3_partial_duplicates.png

Datarensning i Python

Hur hanterar man dublettvärden?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

1_3_full_duplicates.png

Datarensning i Python

Hur hanterar man dublettvärden?

Metoden .drop_duplicates()

subset: Lista med kolumnnamn att kontrollera för dubletter.

keep: Om första ('first'), sista ('last') eller alla (False) dublettvärden ska behållas.

inplace: Ta bort dublettrader direkt i DataFrame utan att skapa ett nytt objekt (True).

# Drop duplicates
height_weight.drop_duplicates(inplace = True)
Datarensning i Python

Hur hanterar man dublettvärden?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')
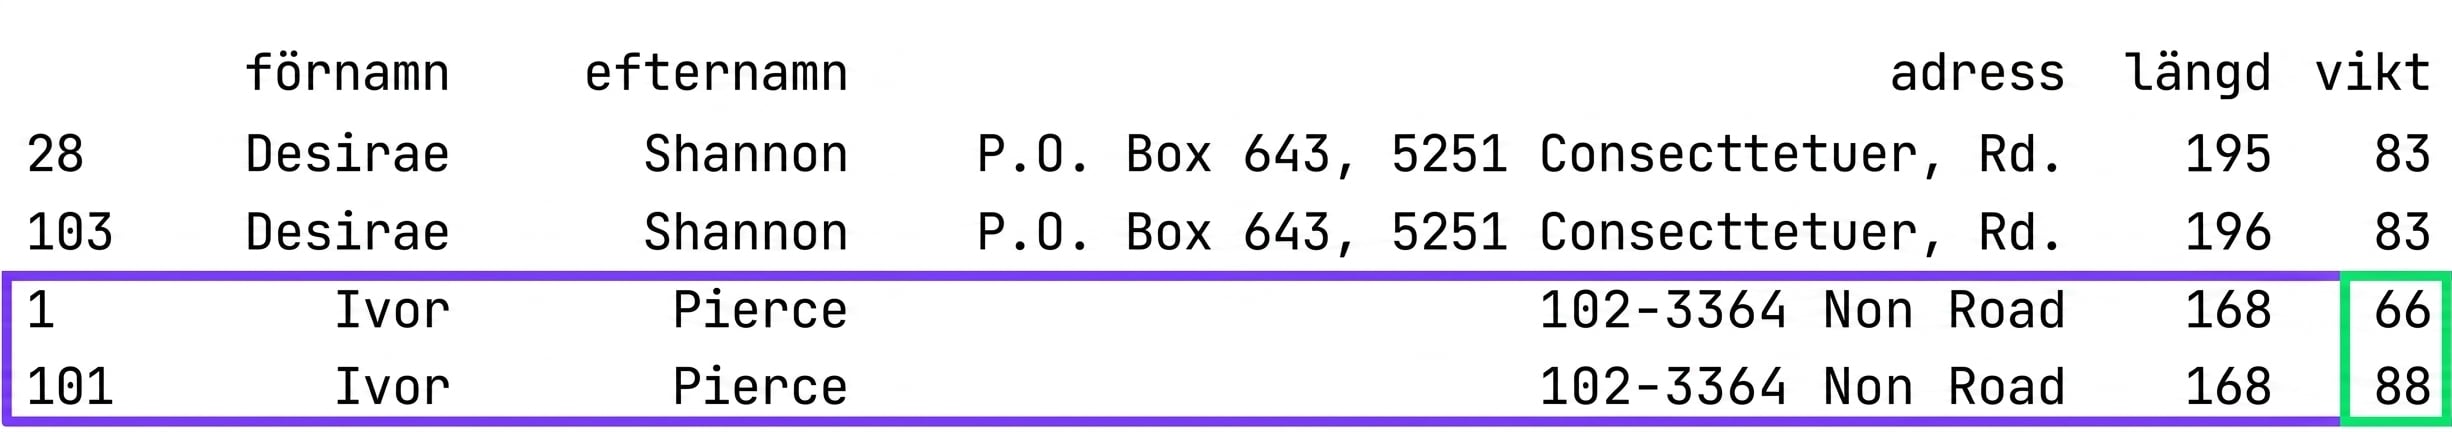
    first_name last_name                               address  height  weight
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
Datarensning i Python

Hur hanterar man dublettvärden?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')

1_3_duplicate_aggregation.png

Datarensning i Python

Hur hanterar man dublettvärden?

Metoderna .groupby() och .agg()

# Group by column names and produce statistical summaries
column_names = ['first_name','last_name','address']
summaries = {'height': 'max', 'weight': 'mean'}
height_weight = height_weight.groupby(by = column_names).agg(summaries).reset_index()

# Make sure aggregation is done duplicates = height_weight.duplicated(subset = column_names, keep = False) height_weight[duplicates].sort_values(by = 'first_name')
first_name    last_name    address    height    weight

Datarensning i Python

Nu kör vi en övning!

Datarensning i Python

Preparing Video For Download...