Diagnostisera bias- och variansproblem
Maskininlärning med trädbaserade modeller i Python

Elie Kawerk
Data Scientist
Skatta generaliseringsfelet
Hur skattar vi ett modells generaliseringsfel?
Det går inte att göra direkt eftersom:
$f$ är okänd,
du har oftast bara en datamängd,
brus är oförutsägbart.
Skatta generaliseringsfelet
Lösning:
- dela upp data i tränings- och testmängder,
- anpassa $\hat{f}$ till träningmängden,
- utvärdera felet för $\hat{f}$ på den osedda testmängden.
- generaliseringsfel för $\hat{f} \approx$ testmängdsfel för $\hat{f}$.
Bättre modellbedömning med korsvalidering
Testmängden ska inte röras förrän vi är nöjda med $\hat{f}$:s prestanda.
Att utvärdera $\hat{f}$ på träningmängden ger en skev skattning – $\hat{f}$ har redan sett alla träningspunkter.
Lösning $\rightarrow$ korsvalidering (CV):
K-fold CV,
Hold-out CV.
K-fold CV
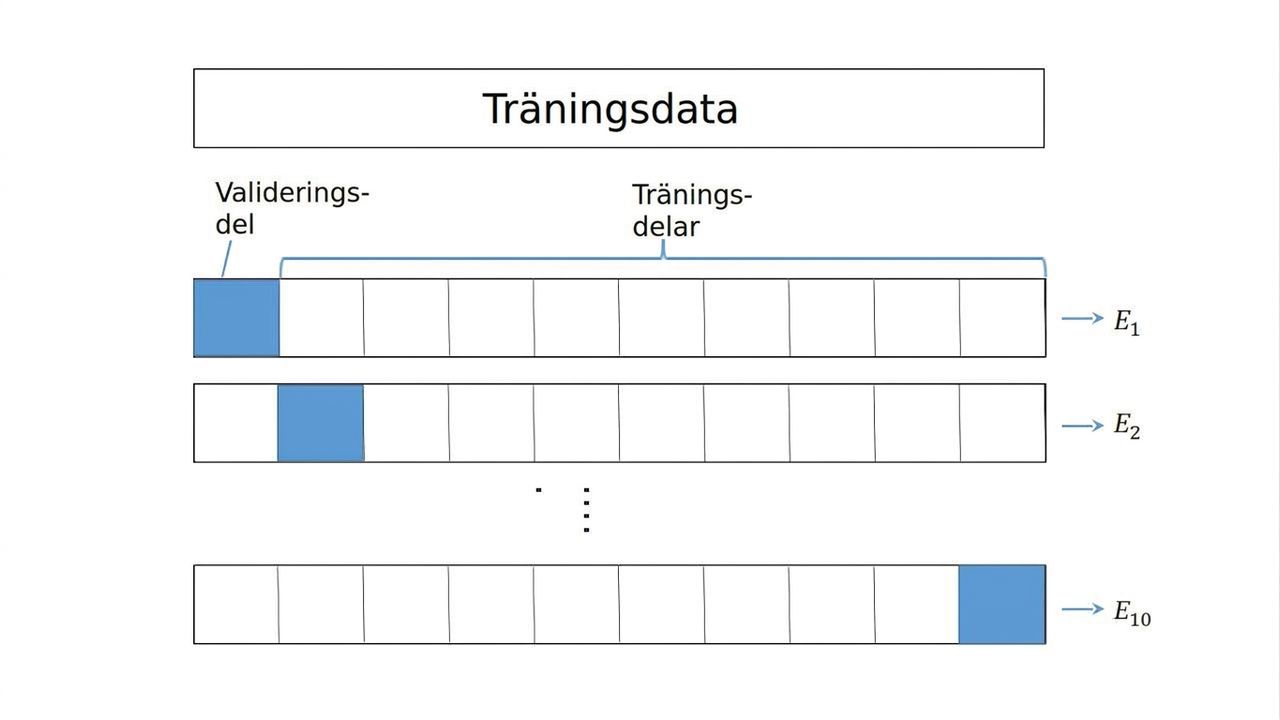
K-fold CV
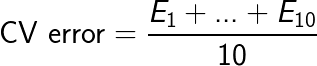
Diagnostisera variansproblem
Om $\hat{f}$ har hög varians:
CV-fel för $\hat{f}$ > träningmängdsfel för $\hat{f}$.
- $\hat{f}$ sägs överanpassa träningmängden. Åtgärder mot överanpassning:
- minska modellkomplexiteten,
- t.ex.: minska max djup, öka min antal sampel per löv, ...
- samla in mer data, ..
Diagnostisera biasproblem
Om $\hat{f}$ har hög bias:
CV-fel för $\hat{f} \approx$ träningmängdsfel för $\hat{f} >>$ önskat fel.
$\hat{f}$ sägs underanpassa träningmängden. Åtgärder mot underanpassning:
- öka modellkomplexiteten,
- t.ex.: öka max djup, minska min antal sampel per löv, ...
- samla in fler relevanta särdrag
K-fold CV i sklearn på Auto-datamängden
from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import train_test_split from sklearn.metrics import mean_squared_error as MSE from sklearn.model_selection import cross_val_score# Set seed for reproducibility SEED = 123 # Split data into 70% train and 30% test X_train, X_test, y_train, y_test = train_test_split(X,y, test_size=0.3, random_state=SEED)# Instantiate decision tree regressor and assign it to 'dt' dt = DecisionTreeRegressor(max_depth=4, min_samples_leaf=0.14, random_state=SEED)
K-fold CV i sklearn på Auto-datamängden
# Evaluate the list of MSE ontained by 10-fold CV # Set n_jobs to -1 in order to exploit all CPU cores in computation MSE_CV = - cross_val_score(dt, X_train, y_train, cv= 10, scoring='neg_mean_squared_error', n_jobs = -1)# Fit 'dt' to the training set dt.fit(X_train, y_train) # Predict the labels of training set y_predict_train = dt.predict(X_train) # Predict the labels of test set y_predict_test = dt.predict(X_test)
# CV MSE
print('CV MSE: {:.2f}'.format(MSE_CV.mean()))
CV MSE: 20.51
# Training set MSE
print('Train MSE: {:.2f}'.format(MSE(y_train, y_predict_train)))
Train MSE: 15.30
# Test set MSE
print('Test MSE: {:.2f}'.format(MSE(y_test, y_predict_test)))
Test MSE: 20.92
Nu kör vi en övning!
Maskininlärning med trädbaserade modeller i Python

