Maskininlärning med trädbaserade modeller i Python
Elie Kawerk
Data Scientist
Kap 1: Classification And Regression Tree (CART)
Kap 2: Bias-varians-avvägningen
Kap 3: Bagging och Random Forests
Kap 4: Boosting
Kap 5: Modelljustering
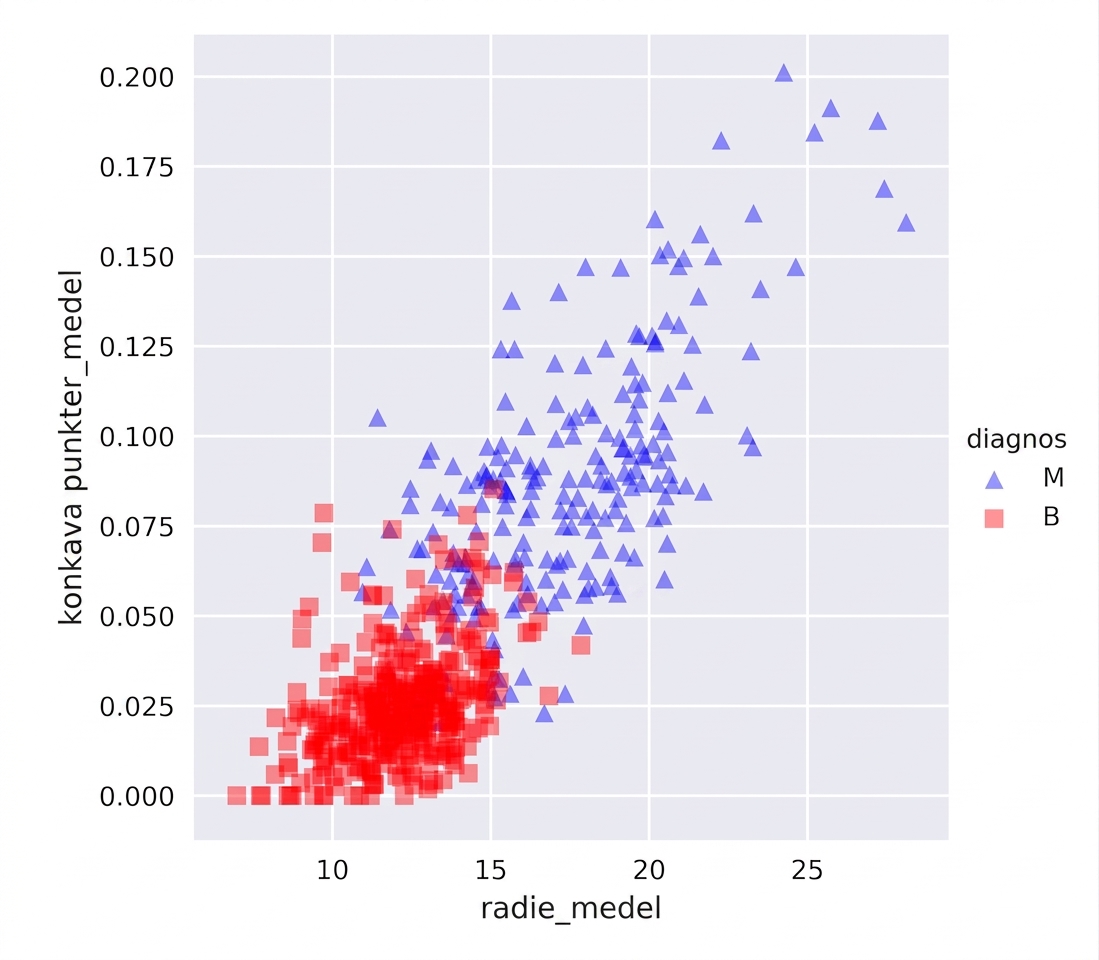
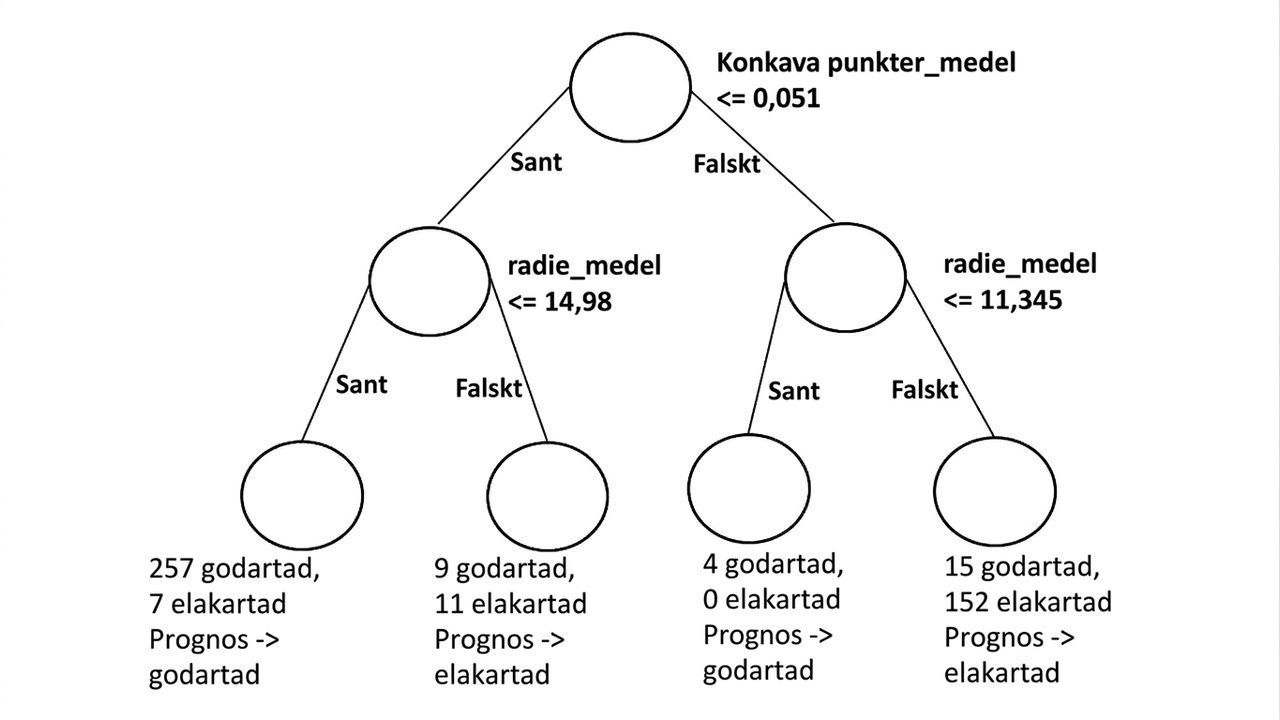
Sekvens av ja/nej-frågor om enskilda särdrag.
Mål: härleda klassetiketter.
Kan fånga icke-linjära samband mellan särdrag och etiketter.
Kräver ingen särdragsskalning (t.ex. standardisering, ..)


# Import DecisionTreeClassifier from sklearn.tree import DecisionTreeClassifier # Import train_test_split from sklearn.model_selection import train_test_split # Import accuracy_score from sklearn.metrics import accuracy_score# Split the dataset into 80% train, 20% test X_train, X_test, y_train, y_test= train_test_split(X, y, test_size=0.2, stratify=y, random_state=1)# Instantiate dt dt = DecisionTreeClassifier(max_depth=2, random_state=1)
# Fit dt to the training set dt.fit(X_train,y_train) # Predict the test set labels y_pred = dt.predict(X_test)# Evaluate the test-set accuracy accuracy_score(y_test, y_pred)
0.90350877192982459
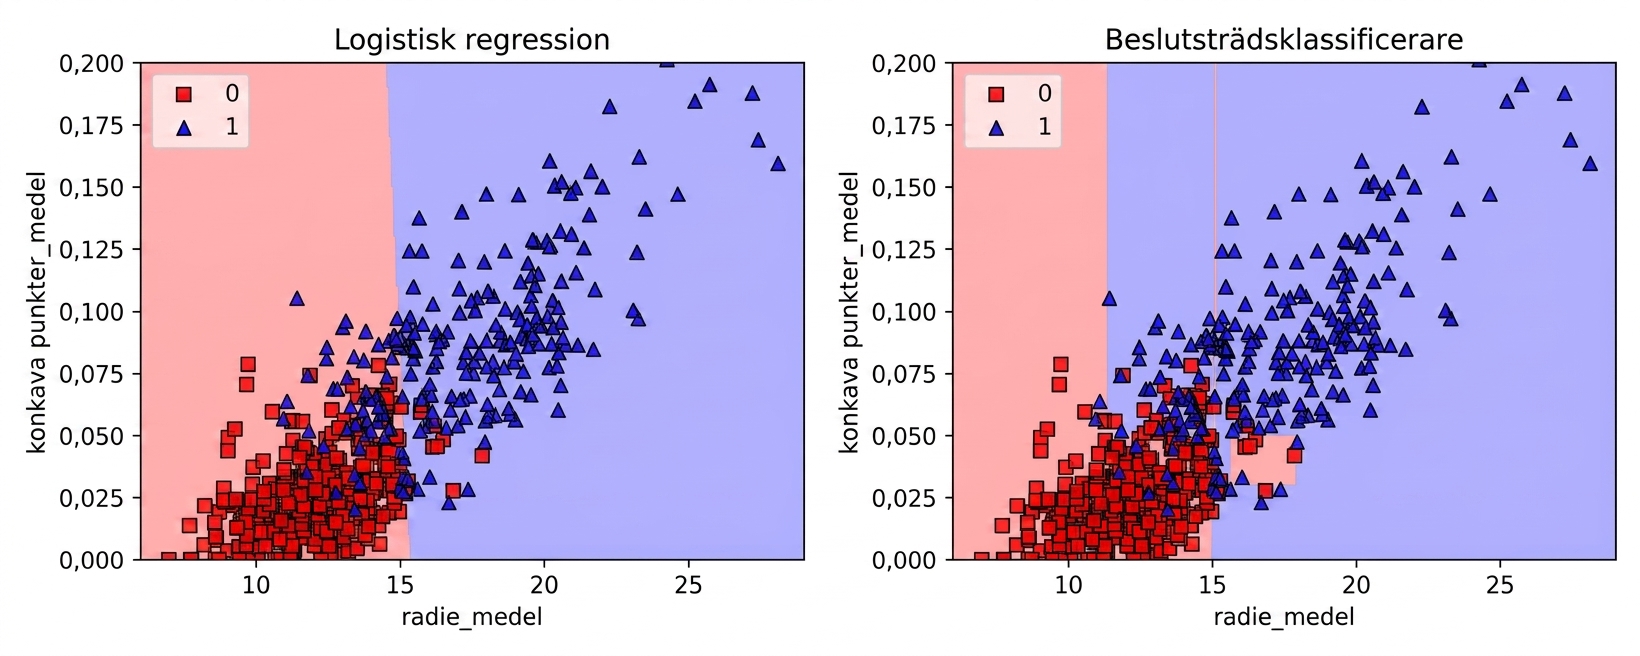
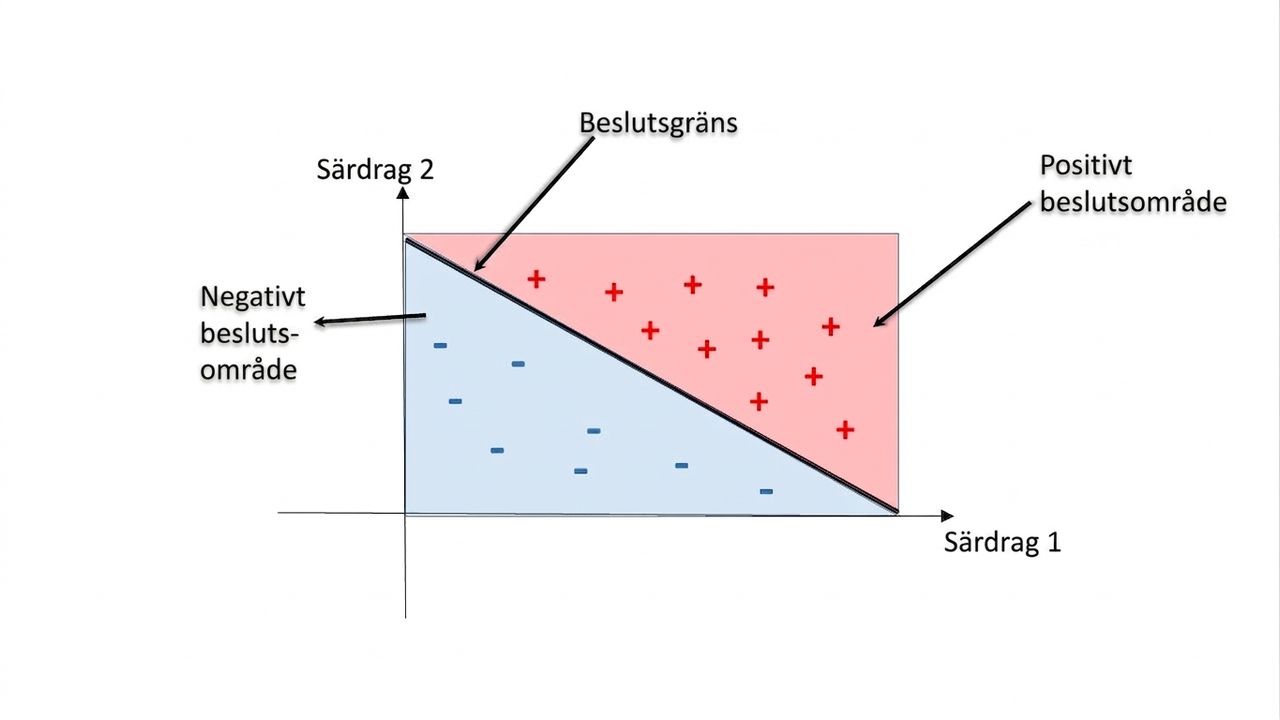
Beslutsregion: område i särdragsrymden där alla instanser tilldelas en klassetikett.
Beslutsgräns: yta som separerar olika beslutsregioner.

Maskininlärning med trädbaserade modeller i Python