Fortsätta infer-pipelinen

Hypotestestning i R

Richie Cotton

Data Evangelist at DataCamp

Repetition: hypoteser och datamängd

$H_{0}$: Andelen hobbyprogrammerare under 30 är densamma som andelen hobbyprogrammerare som är minst 30.

$H_{A}$: Andelen hobbyprogrammerare under 30 skiljer sig från andelen hobbyprogrammerare som är minst 30.

alpha <- 0.1

stack_overflow_imbalanced %>% 
  count(hobbyist, age_cat, .drop = FALSE)
  hobbyist     age_cat    n
1       No At least 30    0
2       No    Under 30  191
3      Yes At least 30   15
4      Yes    Under 30 1025
Hypotestestning i R

Repetition: arbetsflödet

null_distn <- dataset %>% 
  specify() %>% 
  hypothesize() %>% 
  generate() %>% 
  calculate()
observed_stat <- dataset %>% 
  specify() %>% 
  calculate()
get_p_value(null_distn, observed_stat)
stack_overflow_imbalanced %>%
  specify(hobbyist ~ age_cat, success = "Yes") %>% 
  hypothesize(null = "independence")
Response: hobbyist (factor)
Explanatory: age_cat (factor)
Null Hypothesis: independence
# A tibble: 1,231 x 2
  hobbyist age_cat    
  <fct>    <fct>      
1 Yes      At least 30
2 Yes      At least 30
3 Yes      At least 30
4 Yes      Under 30   
5 Yes      At least 30
6 Yes      At least 30
7 No       Under 30   
# ... with 1,224 more rows
Hypotestestning i R

Motivering av generate()

$H_{0}$: Andelen hobbyprogrammerare under 30 är densamma som andelen hobbyprogrammerare som är minst 30.

Om $H_{0}$ stämmer gäller att

  • I varje rad hade hobbyist-värdet kunnat uppträda med vilken ålderskategori som helst med lika stor sannolikhet.
  • För att simulera detta kan vi permutera (blanda) hobbyist-värdena och hålla ålderskategorierna fasta.
Hypotestestning i R
stack_overflow_imbalanced


# A tibble: 1,231 x 2
  hobbyist age_cat    
  <fct>    <fct>      
1 Yes      At least 30
2 Yes      At least 30
3 Yes      At least 30
4 Yes      Under 30   
5 Yes      At least 30
6 Yes      At least 30
7 No       Under 30   
# ... with 1,224 more rows
bind_cols(
  stack_overflow_imbalanced %>% 
    select(hobbyist) %>% 
    slice_sample(prop = 1),
  stack_overflow_imbalanced %>% 
    select(age_cat)
)
# A tibble: 1,231 x 2
  hobbyist age_cat    
  <fct>    <fct>      
1 Yes      At least 30
2 Yes      At least 30
3 No       At least 30
4 No       Under 30   
5 Yes      At least 30
6 Yes      At least 30
7 Yes      Under 30   
# ... with 1,224 more rows
Hypotestestning i R

Generera många replikat

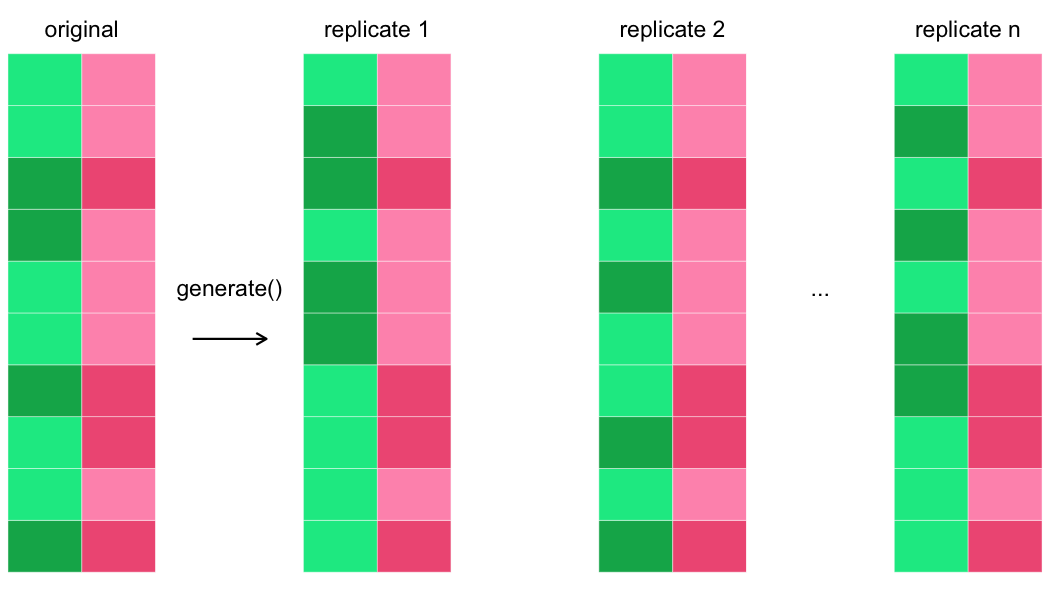
Det tvåkolumniga rutnätet som är resultatet av specify-steget visas till vänster. Till höger om detta syns ordet generate med en pil som pekar åt höger. Till höger om pilen finns tre ytterligare tvåkolumniga rutnät som representerar replikat. Högerkolumnen i varje replikat är identisk med högerkolumnen i originaldatamängden, vilket illustrerar att förklaringsvariabeln är oförändrad. Vänsterkolumnen skiljer sig åt i varje replikat, vilket illustrerar att svarsvariabeln har permuteras.

Hypotestestning i R

generate()

generate() genererar simulerade data som speglar nollhypotesen.

  • För nollhypoteser om "independence": sätt type till "permute".
  • För nollhypoteser om "point": sätt type till "bootstrap" eller "simulate".
stack_overflow_imbalanced %>%
  specify(hobbyist ~ age_cat, success = "Yes") %>% 
  hypothesize(null = "independence") %>% 
  generate(reps = 5000, type = "permute")
Response: hobbyist (factor)
Explanatory: age_cat (factor)
Null Hypothesis: independence
# A tibble: 6,155,000 x 3
# Groups:   replicate [5,000]
  hobbyist age_cat     replicate
  <fct>    <fct>           <int>
1 Yes      At least 30         1
2 Yes      At least 30         1
3 Yes      At least 30         1
4 Yes      Under 30            1
5 Yes      At least 30         1
6 Yes      At least 30         1
7 Yes      Under 30            1
# ... with 6,154,993 more rows
Hypotestestning i R

Beräkna teststatistikan

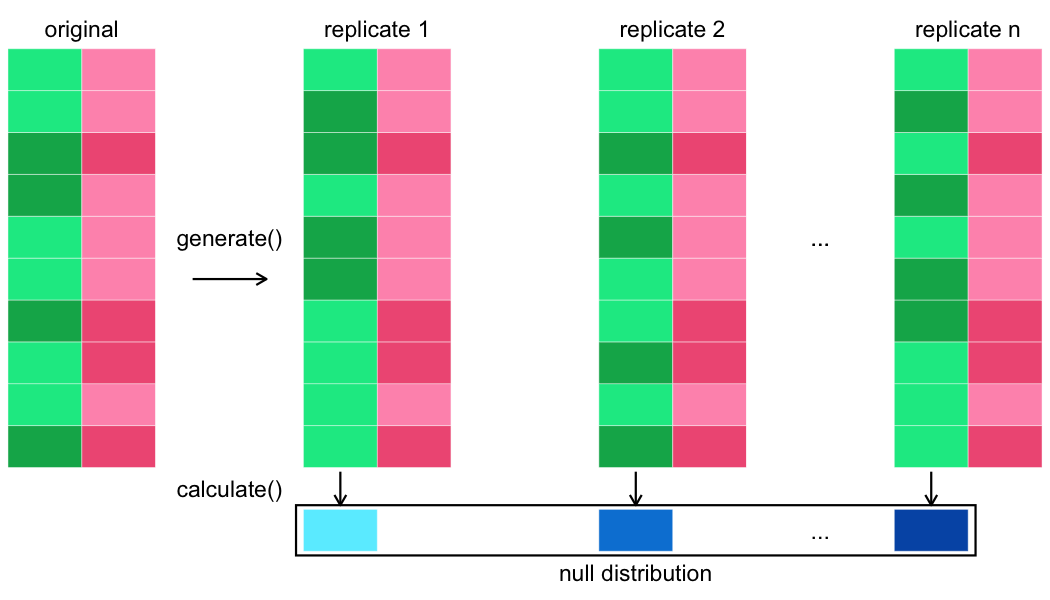
De rutnät som representerar originaldatamängden och replikaten från generate-steget visas. Under dessa syns ordet calculate, och under varje replikat finns en nedåtpil. Under varje pil finns en enskild skuggad cell som representerar en teststatistika. En ruta är ritad runt alla teststatistikor för replikaten och märkt med nollfördelning.

Hypotestestning i R

calculate()

calculate() beräknar en fördelning av teststatistikor som kallas nollfördelningen.

null_distn <- stack_overflow_imbalanced %>%
  specify(
    hobbyist ~ age_cat, 
    success = "Yes"
  ) %>%
  hypothesize(null = "independence") %>%
  generate(reps = 5000, type = "permute") %>%
  calculate(
    stat = "diff in props", 
    order = c("At least 30", "Under 30")
  )
# A tibble: 5,000 x 2
  replicate    stat
      <int>   <dbl>
1         1  0.0896
2         2  0.0896
3         3 -0.180 
4         4  0.157 
5         5  0.0896
6         6 -0.113 
7         7  0.0221
# ... with 4,993 more rows
1 Hjälpsidan för ?calculate listar alla möjliga teststatistikor.
Hypotestestning i R

Visualisera nollfördelningen

visualize(null_distn)
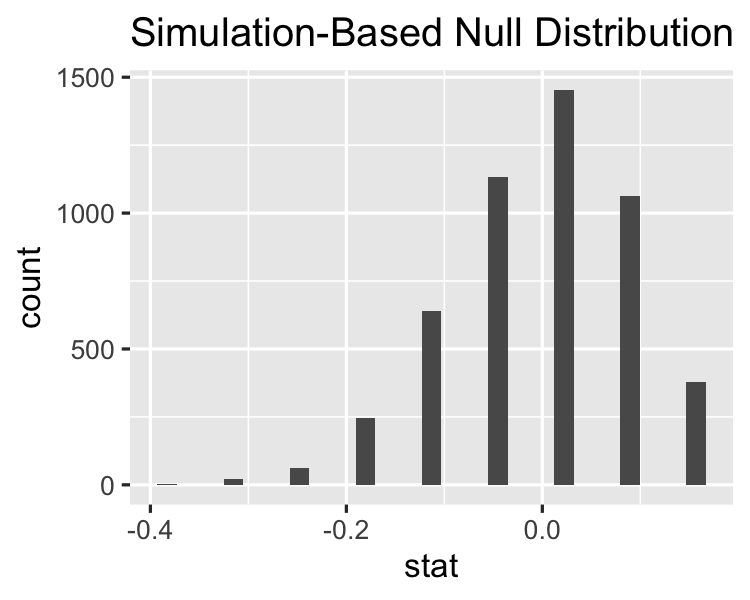
Ett histogram över nollfördelningen. Det är vänsterskevt och har nio distinkta värden.

null_distn %>% count(stat)
# A tibble: 9 x 2
     stat     n
    <dbl> <int>
1 -0.383      2
2 -0.315     22
3 -0.248     63
4 -0.180    246
5 -0.113    641
6 -0.0454  1132
7  0.0221  1453
8  0.0896  1063
9  0.157    378
Hypotestestning i R

Beräkna teststatistikan på originaldatamängden
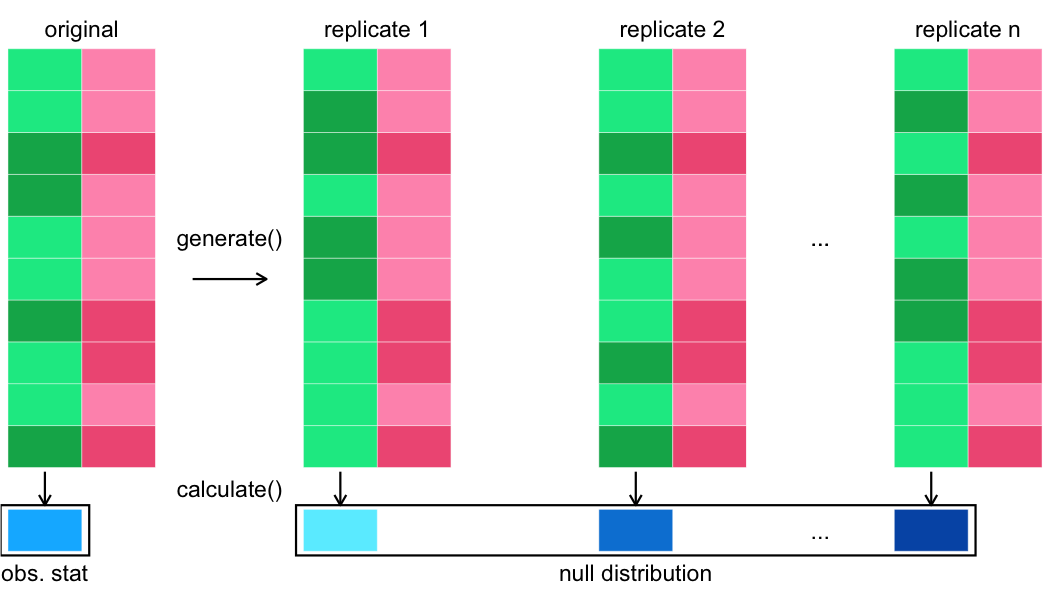
De rutnät som representerar originaldatamängden och replikaten, tillsammans med nollfördelningens celler från calculate-steget, visas. Den här gången finns även en nedåtpil under originaldatamängden, och under den en skuggad cell med en ruta märkt observerad statistika.

Hypotestestning i R

Observerad statistika: specify() %>% calculate()

obs_stat <- stack_overflow_imbalanced %>%
  specify(hobbyist ~ age_cat, success = "Yes") %>%
  # hypothesize(null = "independence") %>%
  # generate(reps = 5000, type = "permute") %>%
  calculate(
    stat = "diff in props",
    order = c("At least 30", "Under 30")
  )
# A tibble: 1 x 1
   stat
  <dbl>
1 0.157
Hypotestestning i R

Visualisera nollfördelningen mot den observerade statistikan
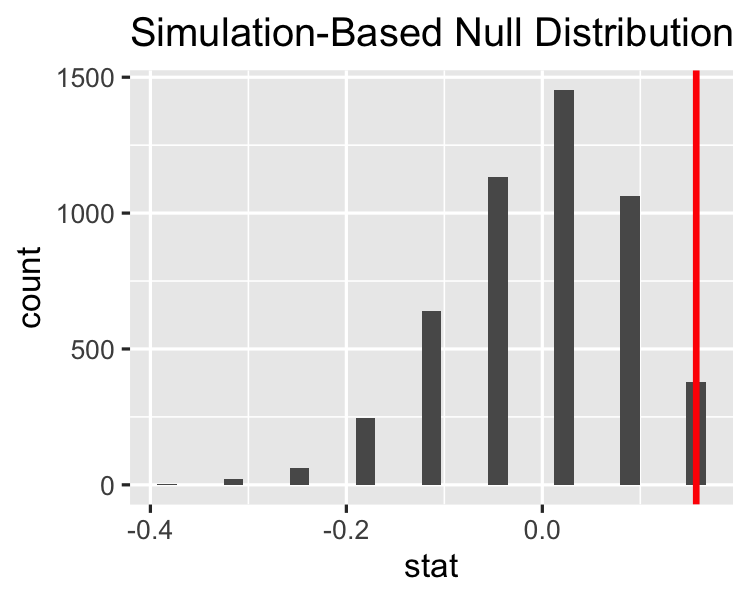
visualize(null_distn) +
  geom_vline(
    aes(xintercept = stat),
    data = observed_stat, 
    color = "red"
  )

Histogrammet över nollfördelningen med en röd vertikal linje vid den observerade statistikan. Den vertikala linjen befinner sig vid histogrammets högraste stapel.

Hypotestestning i R

Hämta p-värdet

get_p_value(
  null_distn, obs_stat, 
  direction = "two sided"   # Not alternative = "two.sided"
)
# A tibble: 1 x 1
  p_value
    <dbl>
1   0.151
# A tibble: 1 x 6
  statistic chisq_df p_value alternative lower_ci upper_ci
      <dbl>    <dbl>   <dbl> <chr>          <dbl>    <dbl>
1      2.79        1  0.0949 two.sided    0.00718   0.0217
Hypotestestning i R

Nu kör vi en övning!

Hypotestestning i R

Preparing Video For Download...