Enstegs proportionstest

Hypotestestning i R

Richie Cotton

Data Evangelist at DataCamp

Repetition av kapitel 1

  • Är ett påstående om en okänd populationsproportion rimligt?
  • Standardfelet för stickprovsstatistikan beräknades med bootstrapfördelningen.
  • Den användes för att beräkna en standardiserad teststatistika, ...
  • som användes för att beräkna ett p-värde, ...
  • som användes för att avgöra vilken hypotes som var mest rimlig.
  • Här beräknar vi teststatistikan utan bootstrapfördelningen.
Hypotestestning i R

Standardiserad teststatistika för proportioner

$p$: populationsproportion (okänd populationsparameter)

$\hat{p}$: stickprovsproportion (stickprovsstatistika)

$p_{0}$: hypotetisk populationsproportion

$$ z = \frac{\hat{p} - \text{mean}(\hat{p})}{\text{standard error}(\hat{p})} = \frac{\hat{p} - p}{\text{standard error}(\hat{p})} $$

Om $H_{0}$ är sann gäller $p = p_{0}$, vilket ger

$$ z = \dfrac{\hat{p} - p_{0}}{\text{standard error}(\hat{p})} $$

Hypotestestning i R

Enklare beräkning av standardfel

$SE(\bar{x}_{\text{child}} - \bar{x}_{\text{adult}}) \approx \sqrt{\dfrac{s_{\text{child}}^2}{n_{\text{child}}} + \dfrac{s_{\text{adult}}^2}{n_{\text{adult}}}}$

$SE_{\hat{p}} = \sqrt{\dfrac{p_{0}*(1-p_{0})}{n}}$

Om $H_{0}$ är sann gäller:

$z = \dfrac{\hat{p} - p_{0}}{\sqrt{\dfrac{p_{0}*(1-p_{0})}{n}}}$

Detta använder bara stickprovsinformation ($\hat{p}$ och $n$) och den hypotetiska parametern ($p_{0}$).

Hypotestestning i R

Varför z i stället för t?

$t = \dfrac{(\bar{x}_{\text{child}} - \bar{x}_{\text{adult}})}{\sqrt{\dfrac{s_{\text{child}}^2}{n_{\text{child}}} + \dfrac{s_{\text{adult}}^2}{n_{\text{adult}}}}}$

  • $s$ beräknas från $\bar{x}$, så $\bar{x}$ används för att skatta både populationsmedelvärdet och populationsstandardavvikelsen.
  • Detta ökar osäkerheten i skattningen av populationsparametern.
  • t-fördelningen har fetare svansar än normalfördelningen.
  • Det ger en extra säkerhetsmarginal.
  • $\hat{p}$ förekommer bara i täljaren, så z-poäng är tillräckliga.
Hypotestestning i R

Stack Overflow ålderskategorier

$H_{0}$: Andelen SO-användare under trettio år är lika med 0,5.

$H_{A}$: Andelen SO-användare under trettio år är inte lika med 0,5.

alpha <- 0.01
stack_overflow %>% 
  count(age_cat)
# A tibble: 2 x 2
  age_cat         n
  <chr>       <int>
1 At least 30  1050
2 Under 30     1216
Hypotestestning i R

Variabler för z

p_hat <- stack_overflow %>%
  summarize(prop_under_30 = mean(age_cat == "Under 30")) %>%
  pull(prop_under_30)
0.5366
p_0 <- 0.50
n <- nrow(stack_overflow)
2266
Hypotestestning i R

Beräkna z-poängen

$z = \dfrac{\hat{p} - p_{0}}{\sqrt{\dfrac{p_{0}*(1-p_{0})}{n}}}$

numerator <- p_hat - p_0
denominator <- sqrt(p_0 * (1 - p_0) / n)
z_score <- numerator / denominator
3.487
Hypotestestning i R

Beräkna p-värdet

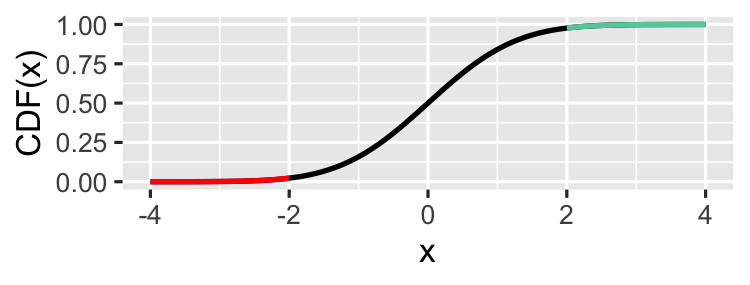
CDF för normalfördelningen. Den del av linjen som är mindre än -2 är röd och den del som är större än 2 är grön. Vänstersidig ("mindre än")

p_value <- pnorm(z_score) 

Högersidig ("större än")

p_value <- pnorm(z_score, lower.tail = FALSE)

Tvåsidig ("inte lika med")

p_value <- pnorm(z_score) + 
  pnorm(z_score, lower.tail = FALSE)
p_value <- 2 * pnorm(z_score)
0.000244
p_value <= alpha
TRUE
Hypotestestning i R

Nu kör vi en övning!

Hypotestestning i R

Preparing Video For Download...