Optimerare, träning och utvärdering

Fördjupad djupinlärning med PyTorch

Michal Oleszak

Machine Learning Engineer

Träningsloop

import torch.nn as nn
import torch.optim as optim

criterion = nn.BCELoss()
optimizer = optim.SGD(net.parameters(), lr=0.01)


for epoch in range(1000): for features, labels in dataloader_train:
optimizer.zero_grad()
outputs = net(features)
loss = criterion( outputs, labels.view(-1, 1) )
loss.backward()
optimizer.step()
  • Definiera förlustfunktion och optimerare
    • BCELoss för binär klassificering
    • SGD-optimerare
  • Iterera över epoker och träningsbatcher
  • Nollställ gradienter
  • Framåtpassning: hämta modellens utdata
  • Beräkna förlust
  • Beräkna gradienter
  • Optimeringssteget: uppdatera parametrar
Fördjupad djupinlärning med PyTorch

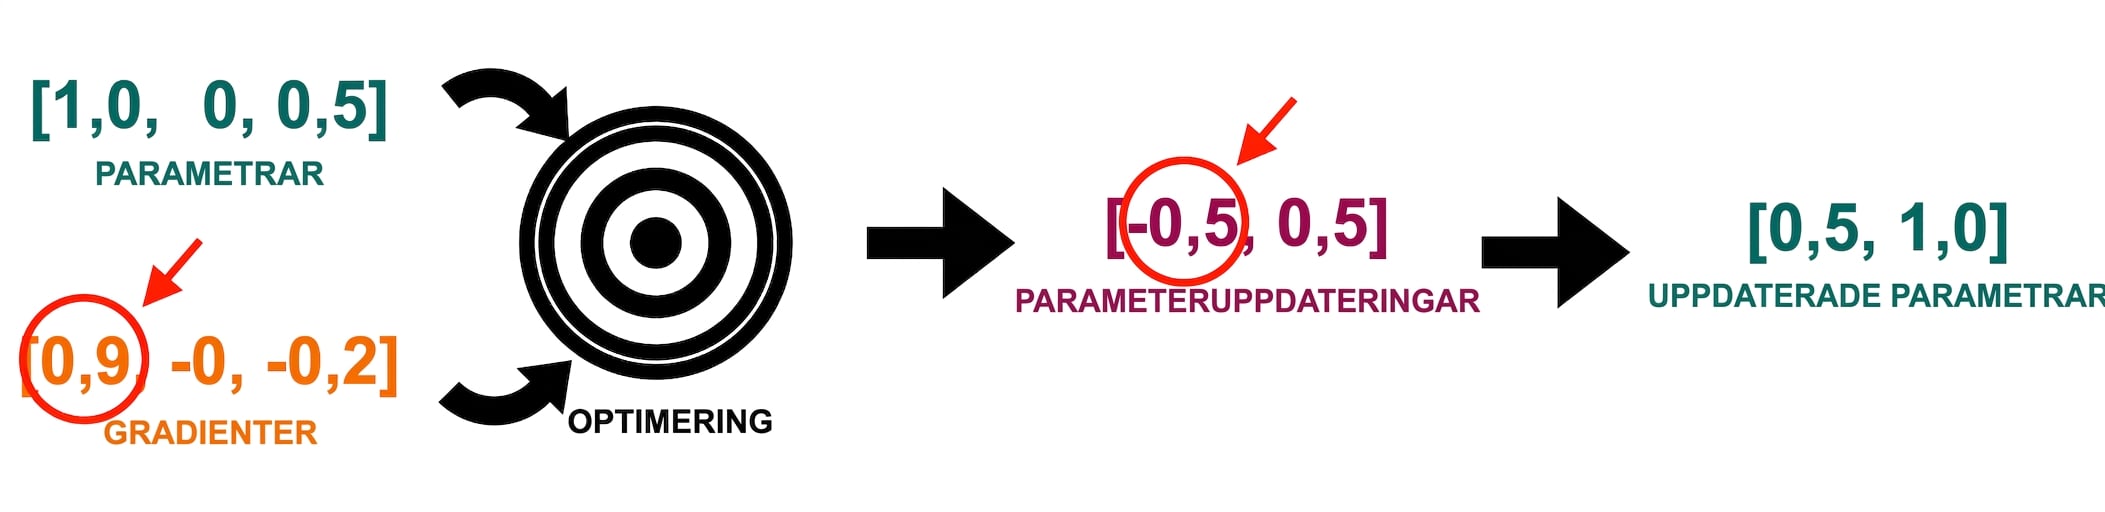
Så fungerar en optimerare


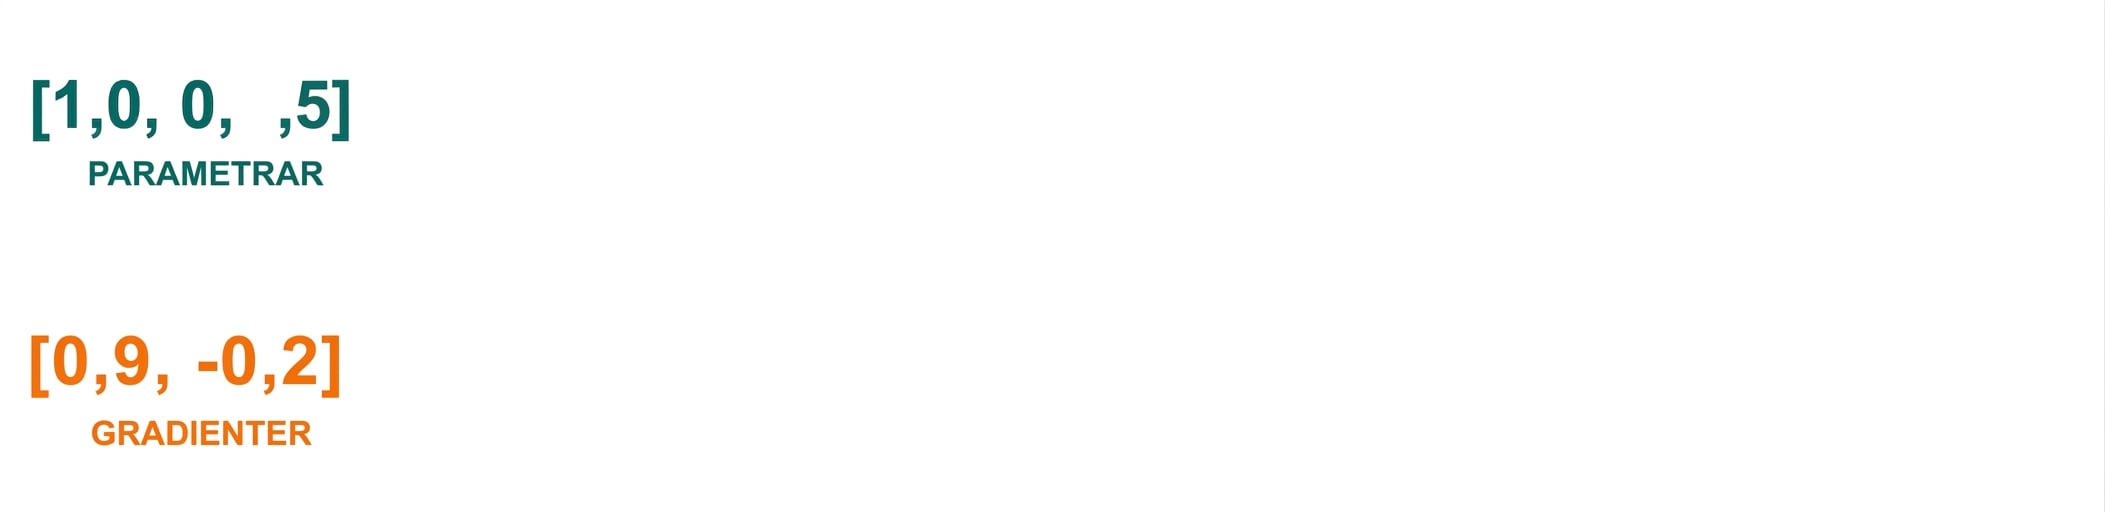
Två vektorer med längden två: en med parametervärden (1 och 0,5), en annan med gradienter (0,9 och -0,2).

Fördjupad djupinlärning med PyTorch

Så fungerar en optimerare


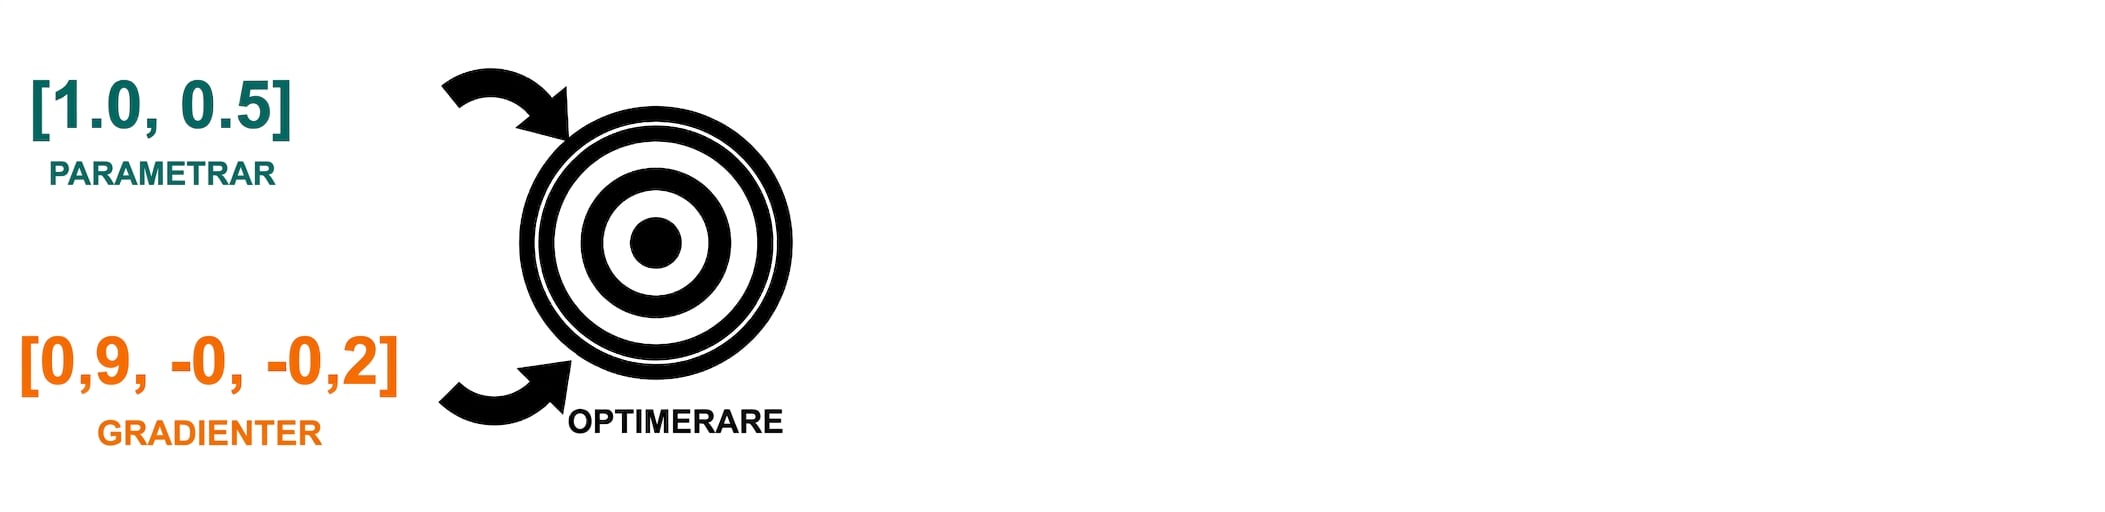
Pilar visar hur de två vektorerna med parametrar och gradienter skickas in i optimeraren, illustrerad som en måltavla.

Fördjupad djupinlärning med PyTorch

Så fungerar en optimerare


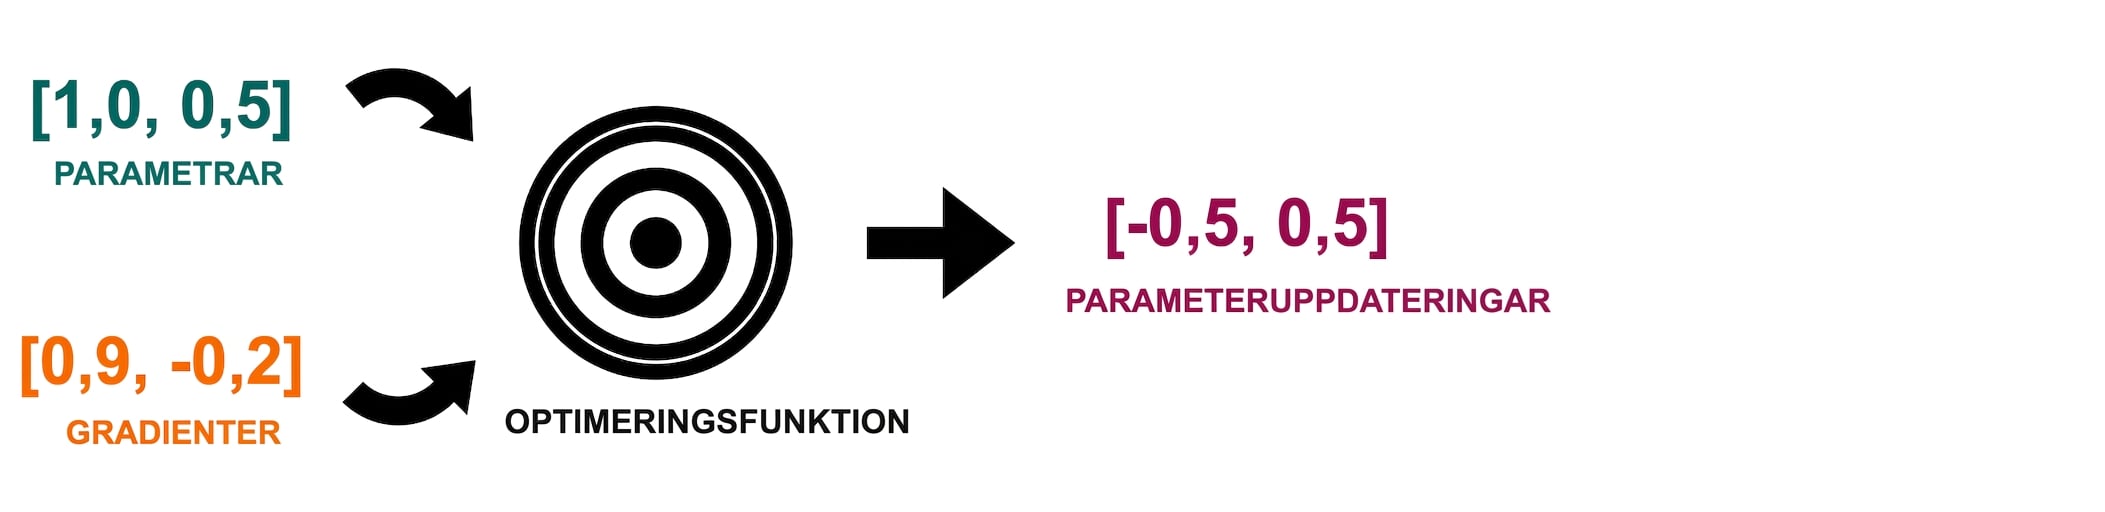
En pil från optimeraren pekar mot en vektor med två parameteruppdateringar: -0,5 och 0,5.

Fördjupad djupinlärning med PyTorch

Så fungerar en optimerare


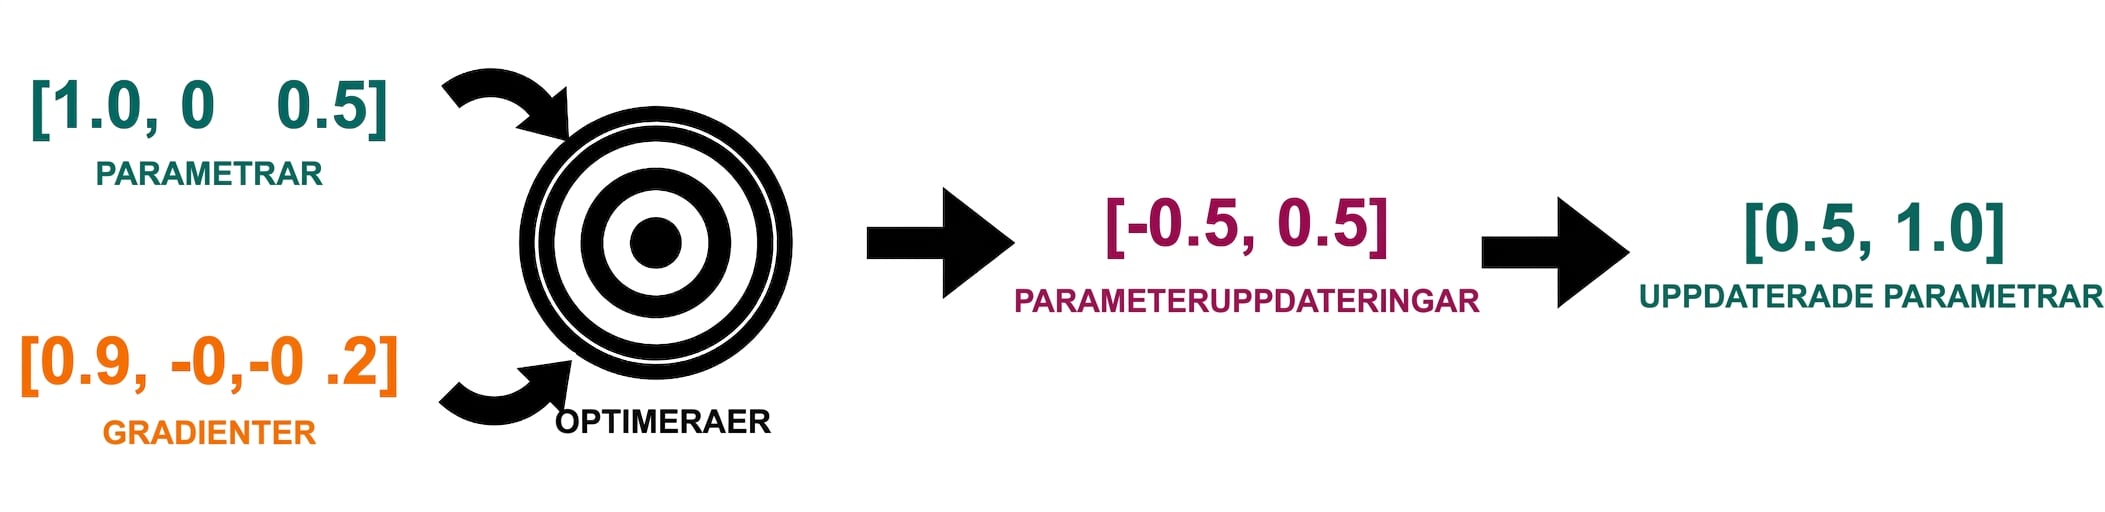
En pil från parameteruppdateringarna pekar mot de uppdaterade parametervärdena: 0,5 och 1,0

Fördjupad djupinlärning med PyTorch

Så fungerar en optimerare


En pil från parameteruppdateringarna pekar mot de uppdaterade parametervärdena: 0,5 och 1,0

Fördjupad djupinlärning med PyTorch

Stochastic Gradient Descent (SGD)

optimizer = optim.SGD(net.parameters(), lr=0.01)
  • Uppdateringen styrs av inlärningshastigheten
  • Enkel och effektiv för grundläggande modeller
  • Används sällan i praktiken
Fördjupad djupinlärning med PyTorch

Adaptive Gradient (Adagrad)

optimizer = optim.Adagrad(net.parameters(), lr=0.01)
  • Anpassar inlärningshastigheten per parameter
  • Passar för glesa data
  • Kan sänka inlärningshastigheten för snabbt
Fördjupad djupinlärning med PyTorch

Root Mean Square Propagation (RMSprop)

optimizer = optim.RMSprop(net.parameters(), lr=0.01)
  • Uppdaterar varje parameter baserat på storleken av dess tidigare gradienter
Fördjupad djupinlärning med PyTorch

Adaptive Moment Estimation (Adam)

optimizer = optim.Adam(net.parameters(), lr=0.01)
  • Troligtvis den mest mångsidiga och vanligt använda
  • RMSprop + gradientmomentum
  • Används ofta som standardval
Fördjupad djupinlärning med PyTorch

Modellutvärdering

from torchmetrics import Accuracy

acc = Accuracy(task="binary")


net.eval() with torch.no_grad(): for features, labels in dataloader_test:
outputs = net(features)
preds = (outputs >= 0.5).float()
acc(preds, labels.view(-1, 1))
accuracy = acc.compute() print(f"Accuracy: {accuracy}")
Accuracy: 0.6759443283081055
  • Konfigurera noggrannhetsmåttet
  • Sätt modellen i evalueringsläge och iterera över testbatcher utan gradienter
  • Skicka data till modellen för att få predikterade sannolikheter
  • Beräkna predikterade etiketter
  • Uppdatera noggrannhetsmåttet
Fördjupad djupinlärning med PyTorch

Nu kör vi en övning!

Fördjupad djupinlärning med PyTorch

Preparing Video For Download...