Försvinnande och exploderande gradienter

Fördjupad djupinlärning med PyTorch

Michal Oleszak

Machine Learning Engineer

Försvinnande gradienter
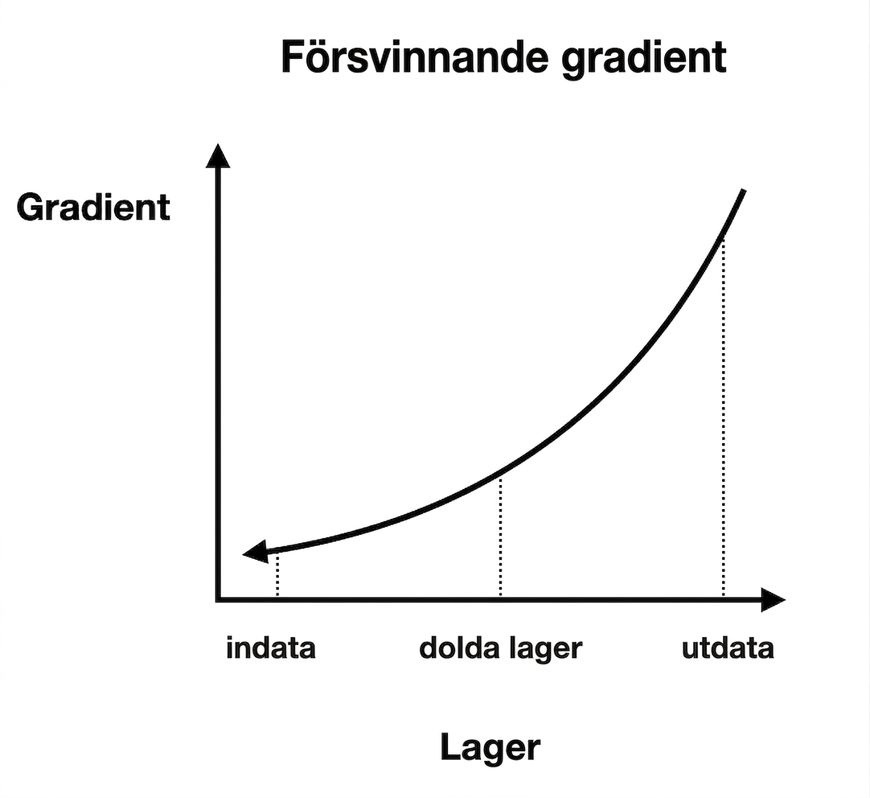
  • Gradienterna blir allt mindre under bakåtpassningen
  • Tidigare lager får små parameteruppdateringar
  • Modellen lär sig inte

Grafer som visar gradientstorleken i förhållande till lagerindex: för tidigare lager är gradienterna mindre

Fördjupad djupinlärning med PyTorch

Exploderande gradienter

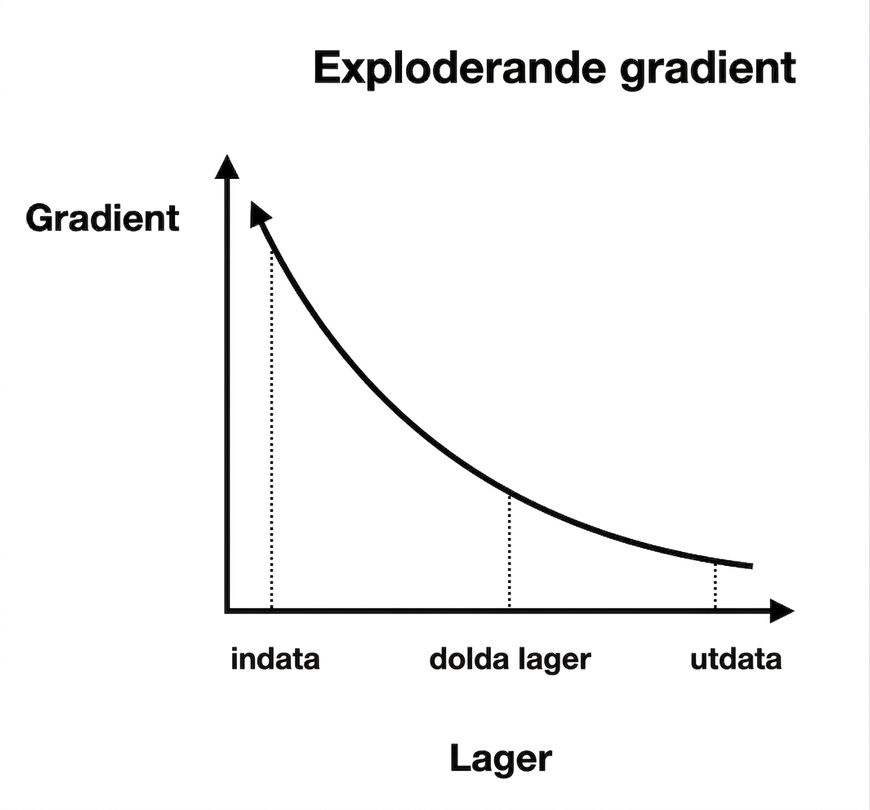
  • Gradienterna blir allt större
  • Parameteruppdateringarna är för stora
  • Träningen divergerar

Grafer som visar gradientstorleken i förhållande till lagerindex: för tidigare lager är gradienterna större

Fördjupad djupinlärning med PyTorch

Lösning på instabila gradienter

  1. Korrekt viktinitiering
  2. Lämpliga aktiveringsfunktioner
  3. Batchnormalisering


Tre steg

Fördjupad djupinlärning med PyTorch

Viktinitiering

layer = nn.Linear(8, 1)
print(layer.weight)
Parameter containing:
tensor([[-0.0195,  0.0992,  0.0391,  0.0212,
         -0.3386, -0.1892, -0.3170,  0.2148]])
Fördjupad djupinlärning med PyTorch

Viktinitiering

En bra initiering säkerställer:

  • Variansen för lagerindata = variansen för lagerutdata
  • Gradienternas varians är densamma före och efter ett lager


Hur detta uppnås beror på aktiveringsfunktionen:

  • För ReLU och liknande kan He/Kaiming-initiering användas
Fördjupad djupinlärning med PyTorch

Viktinitiering

import torch.nn.init as init

init.kaiming_uniform_(layer.weight)
print(layer.weight)
Parameter containing:
tensor([[-0.3063, -0.2410,  0.0588,  0.2664,
          0.0502, -0.0136,  0.2274,  0.0901]])
Fördjupad djupinlärning med PyTorch

He/Kaiming-initiering

init.kaiming_uniform_(self.fc1.weight)
init.kaiming_uniform_(self.fc2.weight)
init.kaiming_uniform_(
  self.fc3.weight,
  nonlinearity="sigmoid",
)
Fördjupad djupinlärning med PyTorch

He/Kaiming-initiering

import torch.nn as nn
import torch.nn.init as init

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.fc2 = nn.Linear(16, 8)
        self.fc3 = nn.Linear(8, 1)


init.kaiming_uniform_(self.fc1.weight) init.kaiming_uniform_(self.fc2.weight) init.kaiming_uniform_( self.fc3.weight, nonlinearity="sigmoid", )


    def forward(self, x):
        x = nn.functional.relu(self.fc1(x))
        x = nn.functional.relu(self.fc2(x))
        x = nn.functional.sigmoid(self.fc3(x))
        return x


Fördjupad djupinlärning med PyTorch

Aktiveringsfunktioner

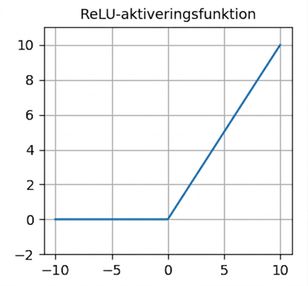
En graf som visar ReLU-funktionen. För värden under noll är linjen horisontell vid noll; för värden över noll har linjen en positiv lutning.

  • Används ofta som standardaktivering
  • nn.functional.relu()
  • Noll för negativa indata – döende neuroner
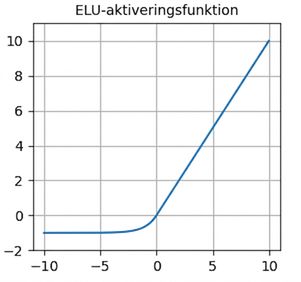
En graf som visar ELU-funktionen. Den liknar ReLU men har en mjuk och kurvig övergång från negativa värden till det positiva området.

  • nn.functional.elu()
  • Nollskilda gradienter för negativa värden – motverkar döende neuroner
  • Genomsnittlig utdata nära noll – motverkar försvinnande gradienter
Fördjupad djupinlärning med PyTorch

Batchnormalisering

Efter ett lager:

  1. Normalisera lagrets utdata genom att:

    • Subtrahera medelvärdet
    • Dividera med standardavvikelsen
  2. Skala och förskjut normaliserade utdata med inlärda parametrar

Modellen lär sig optimal indatafördelning för varje lager:

  • Snabbare förlustminskning
  • Motverkar instabila gradienter
Fördjupad djupinlärning med PyTorch

Batchnormalisering

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(9, 16)
        self.bn1 = nn.BatchNorm1d(16)

        ...


def forward(self, x): x = self.fc1(x) x = self.bn1(x) x = nn.functional.elu(x) ...
Fördjupad djupinlärning med PyTorch

Nu kör vi en övning!

Fördjupad djupinlärning med PyTorch

Preparing Video For Download...