Hypotestestning i Python
James Chapman
Curriculum Manager, DataCamp

Kontroll:

Behandling:

import pandas as pd
print(stack_overflow)
respondent age_1st_code ... age hobbyist
0 36.0 30.0 ... 34.0 Yes
1 47.0 10.0 ... 53.0 Yes
2 69.0 12.0 ... 25.0 Yes
3 125.0 30.0 ... 41.0 Yes
4 147.0 15.0 ... 28.0 No
... ... ... ... ... ...
2259 62867.0 13.0 ... 33.0 Yes
2260 62882.0 13.0 ... 28.0 Yes
[2261 rows x 8 columns]
En hypotes:
Medelvärdet för den årliga ersättningen i populationen av datavetare är 110 000 dollar
Punktskattnig (stickprovsstatistika):
mean_comp_samp = stack_overflow['converted_comp'].mean()
119574.71738168952
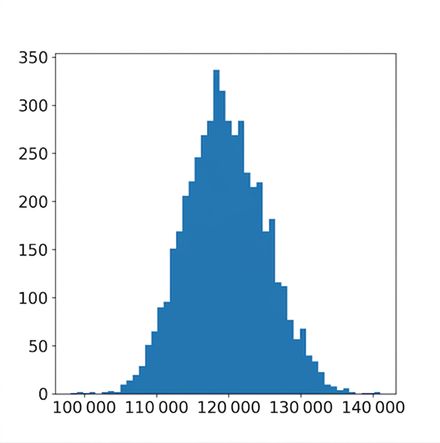
import numpy as np# Step 3. Repeat steps 1 & 2 many times, appending to a list so_boot_distn = [] for i in range(5000): so_boot_distn.append(# Step 2. Calculate point estimate np.mean(# Step 1. Resample stack_overflow.sample(frac=1, replace=True)['converted_comp']))
import matplotlib.pyplot as plt
plt.hist(so_boot_distn, bins=50)
plt.show()

std_error = np.std(so_boot_distn, ddof=1)
5607.997577378606
$\text{standardiserat värde} = \dfrac{\text{värde} - \text{medelvärde}}{\text{standardavvikelse}}$
$z = \dfrac{\text{stickprovsstat.} - \text{hyp. param. värde}}{\text{standardfel}}$
stack_overflow['converted_comp'].mean()
119574.71738168952
mean_comp_hyp = 110000
std_error
5607.997577378606
z_score = (mean_comp_samp - mean_comp_hyp) / std_error
1.7073326529796957
Avgöra om stickprovsstatistikor ligger nära eller långt från förväntade (eller "hypotetiserade") värden
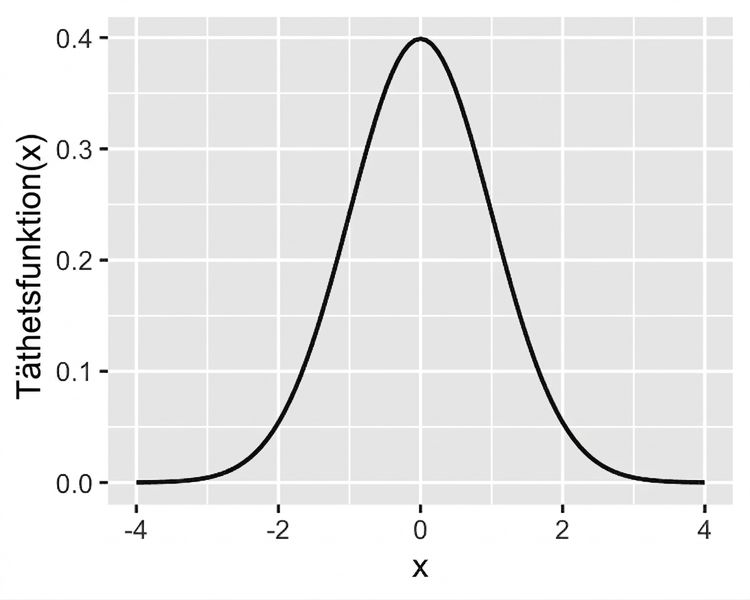
Standardnormalfördelning: normalfördelning med medelvärde = 0 + standardavvikelse = 1
Hypotestestning i Python