Optimera AI för hastighet, kostnad och kvalitet
AI-assisterad kodning för utvecklare
Francesca Donadoni
AI Curriculum Manager, DataCamp
Mätvärden
Latens
(svarstid): Hur lång tid det tar för modellen att generera ett svar
Mätvärden
Latens
(svarstid): Hur lång tid det tar för modellen att generera ett svar
$$
Tokenkostnad
(per 1M tokens): Den monetära kostnaden för att använda en AI-modell
Mätvärden
Latens
(svarstid): Hur lång tid det tar för modellen att generera ett svar
$$
Tokenkostnad
(per 1M tokens): Den monetära kostnaden för att använda en AI-modell
$$
Kvalitet
(godkännandegrad för tester/täckning): Hur ofta den genererade koden fungerar som avsett
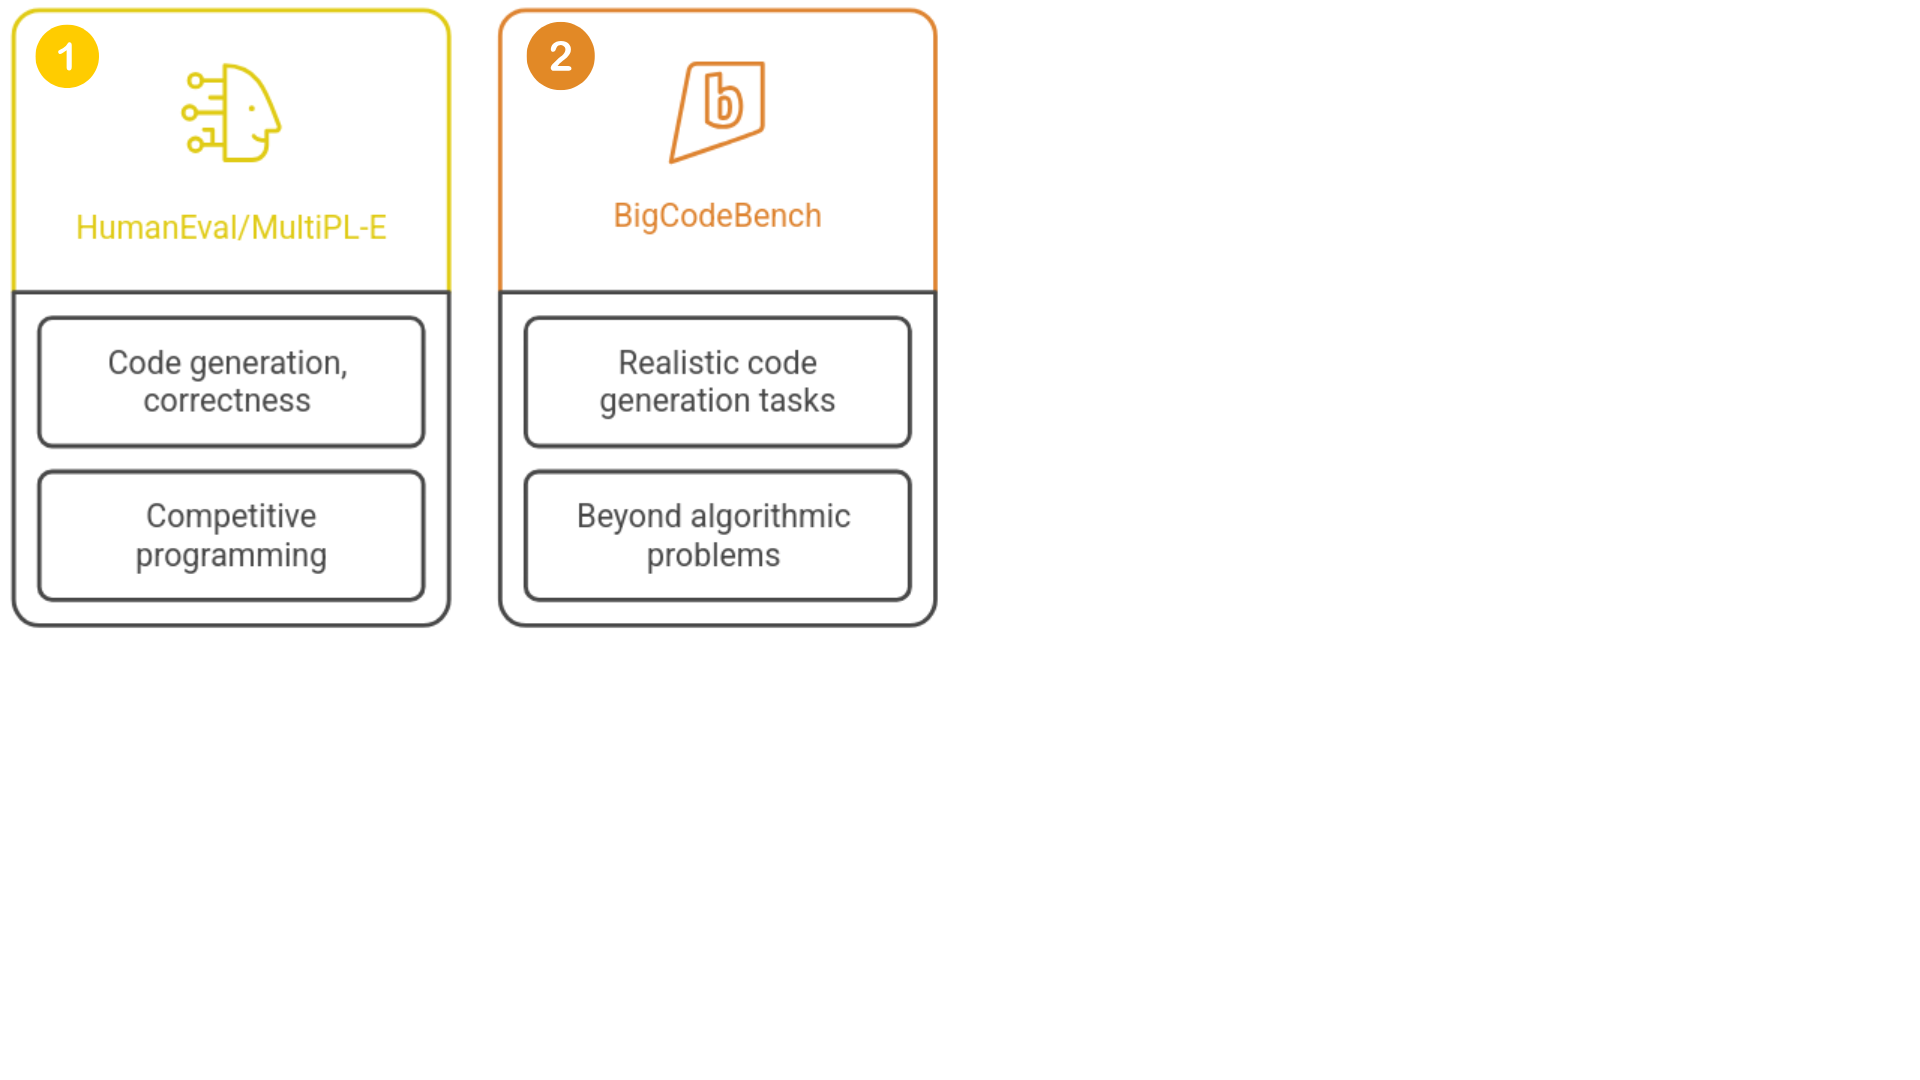
Modell-benchmarking
$$
1
https://github.com/openai/human-eval
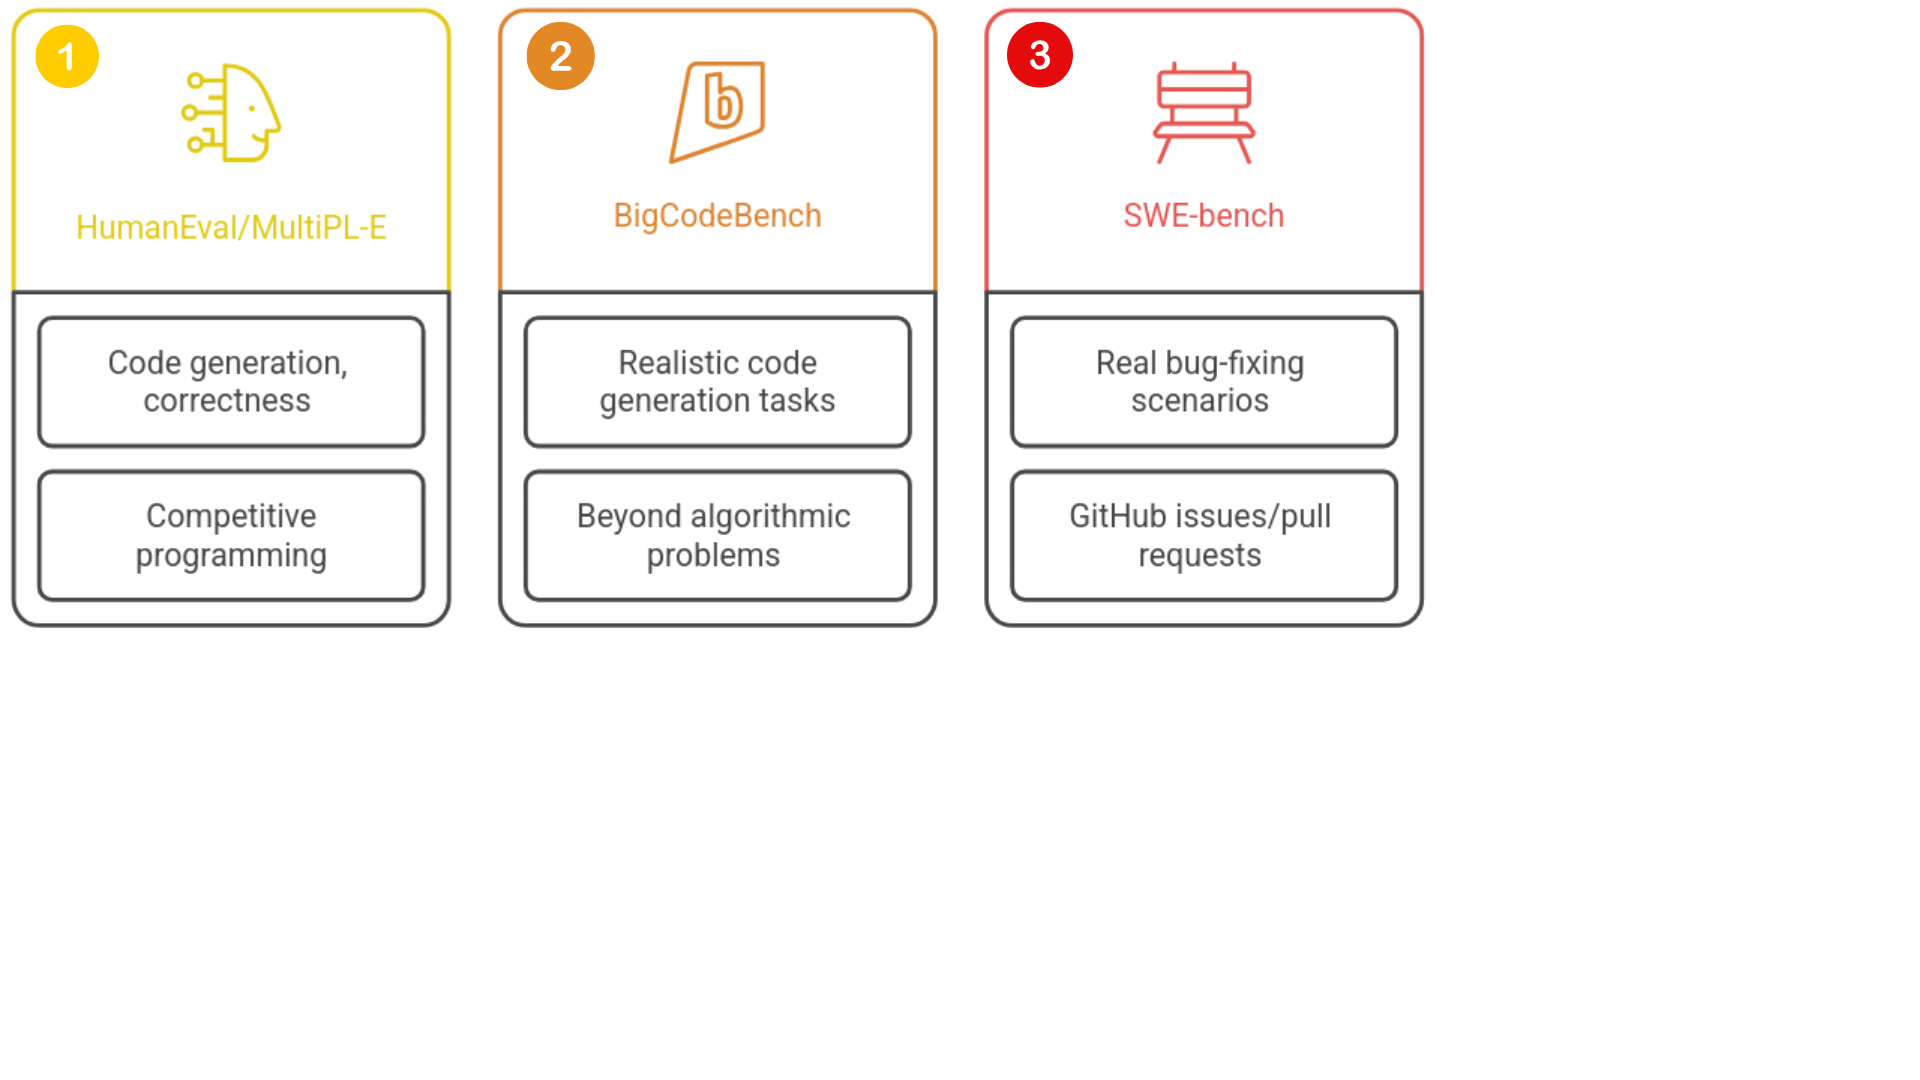
Modell-benchmarking
$$
1
https://github.com/bigcode-project/bigcodebench
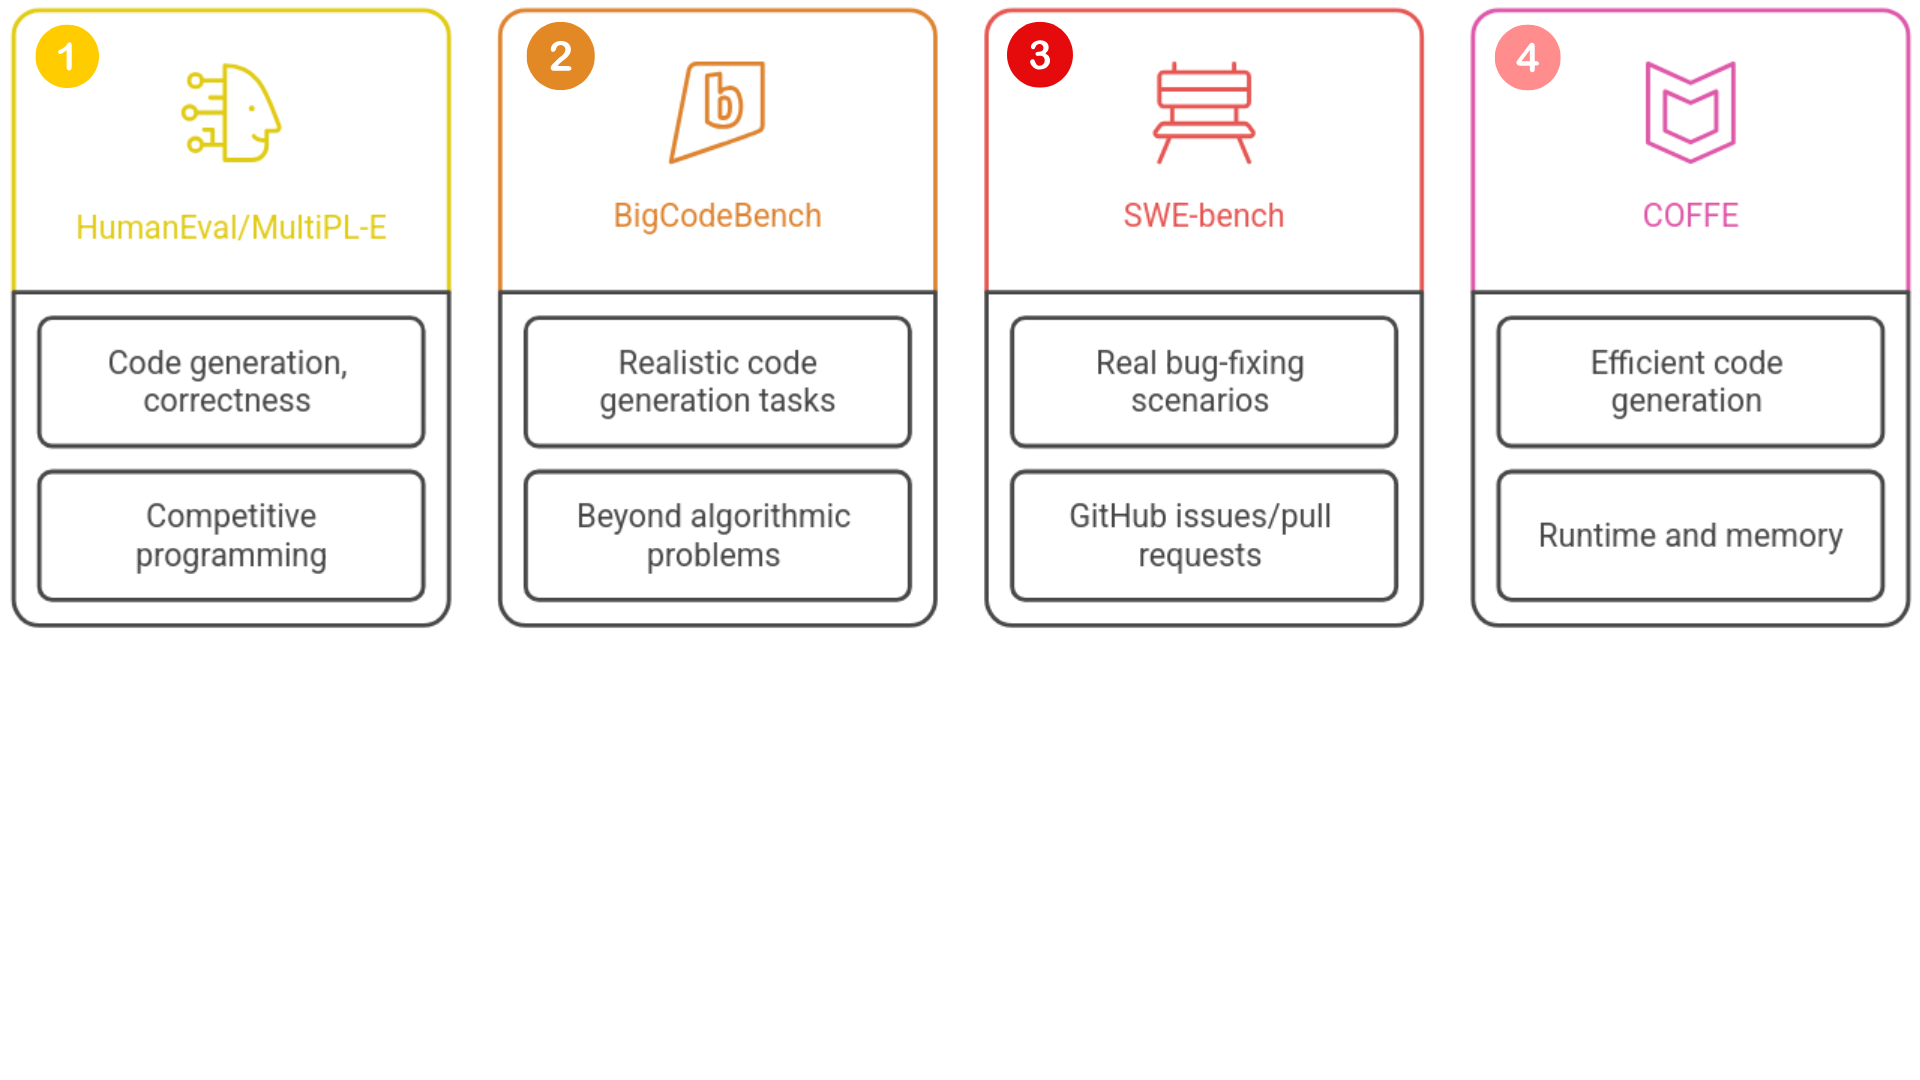
Modell-benchmarking
$$
1
https://github.com/SWE-bench/SWE-bench
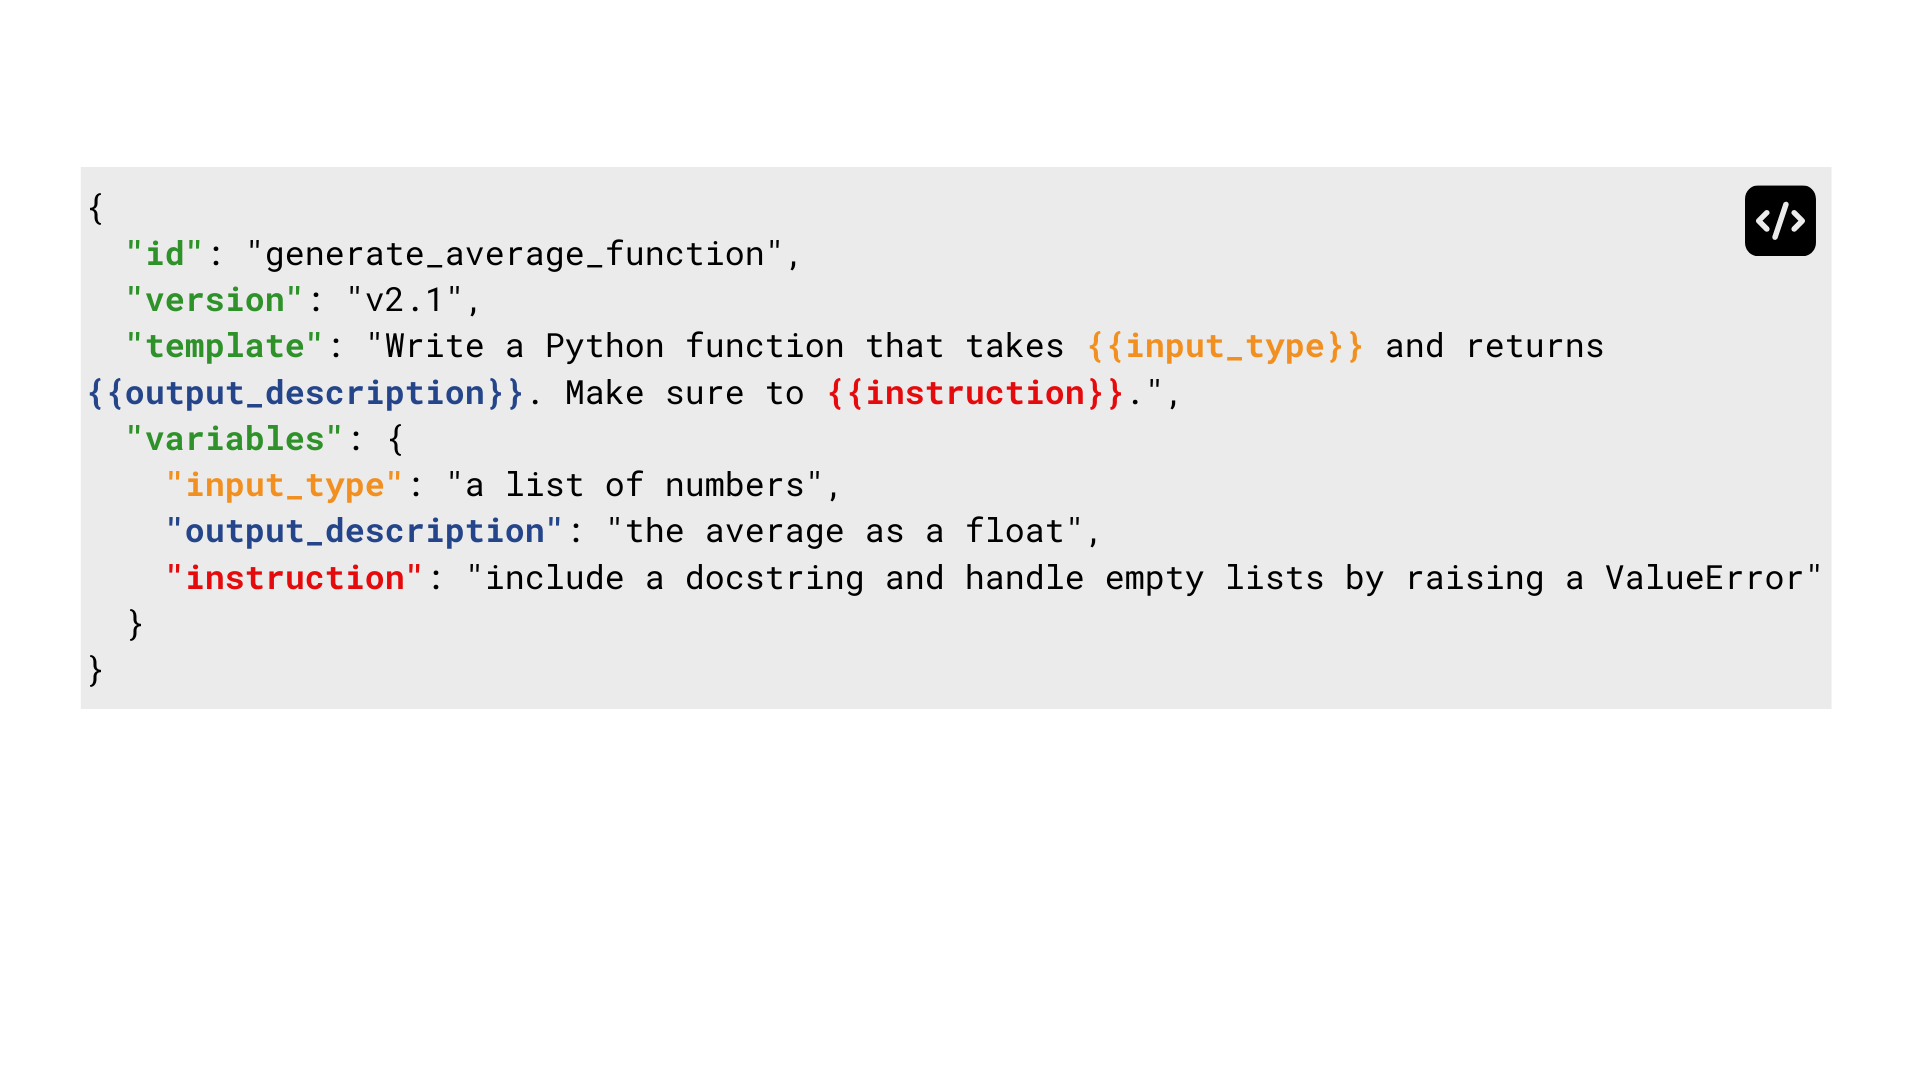
Modell-benchmarking
$$
1
https://github.com/JohnnyPeng18/Coffe
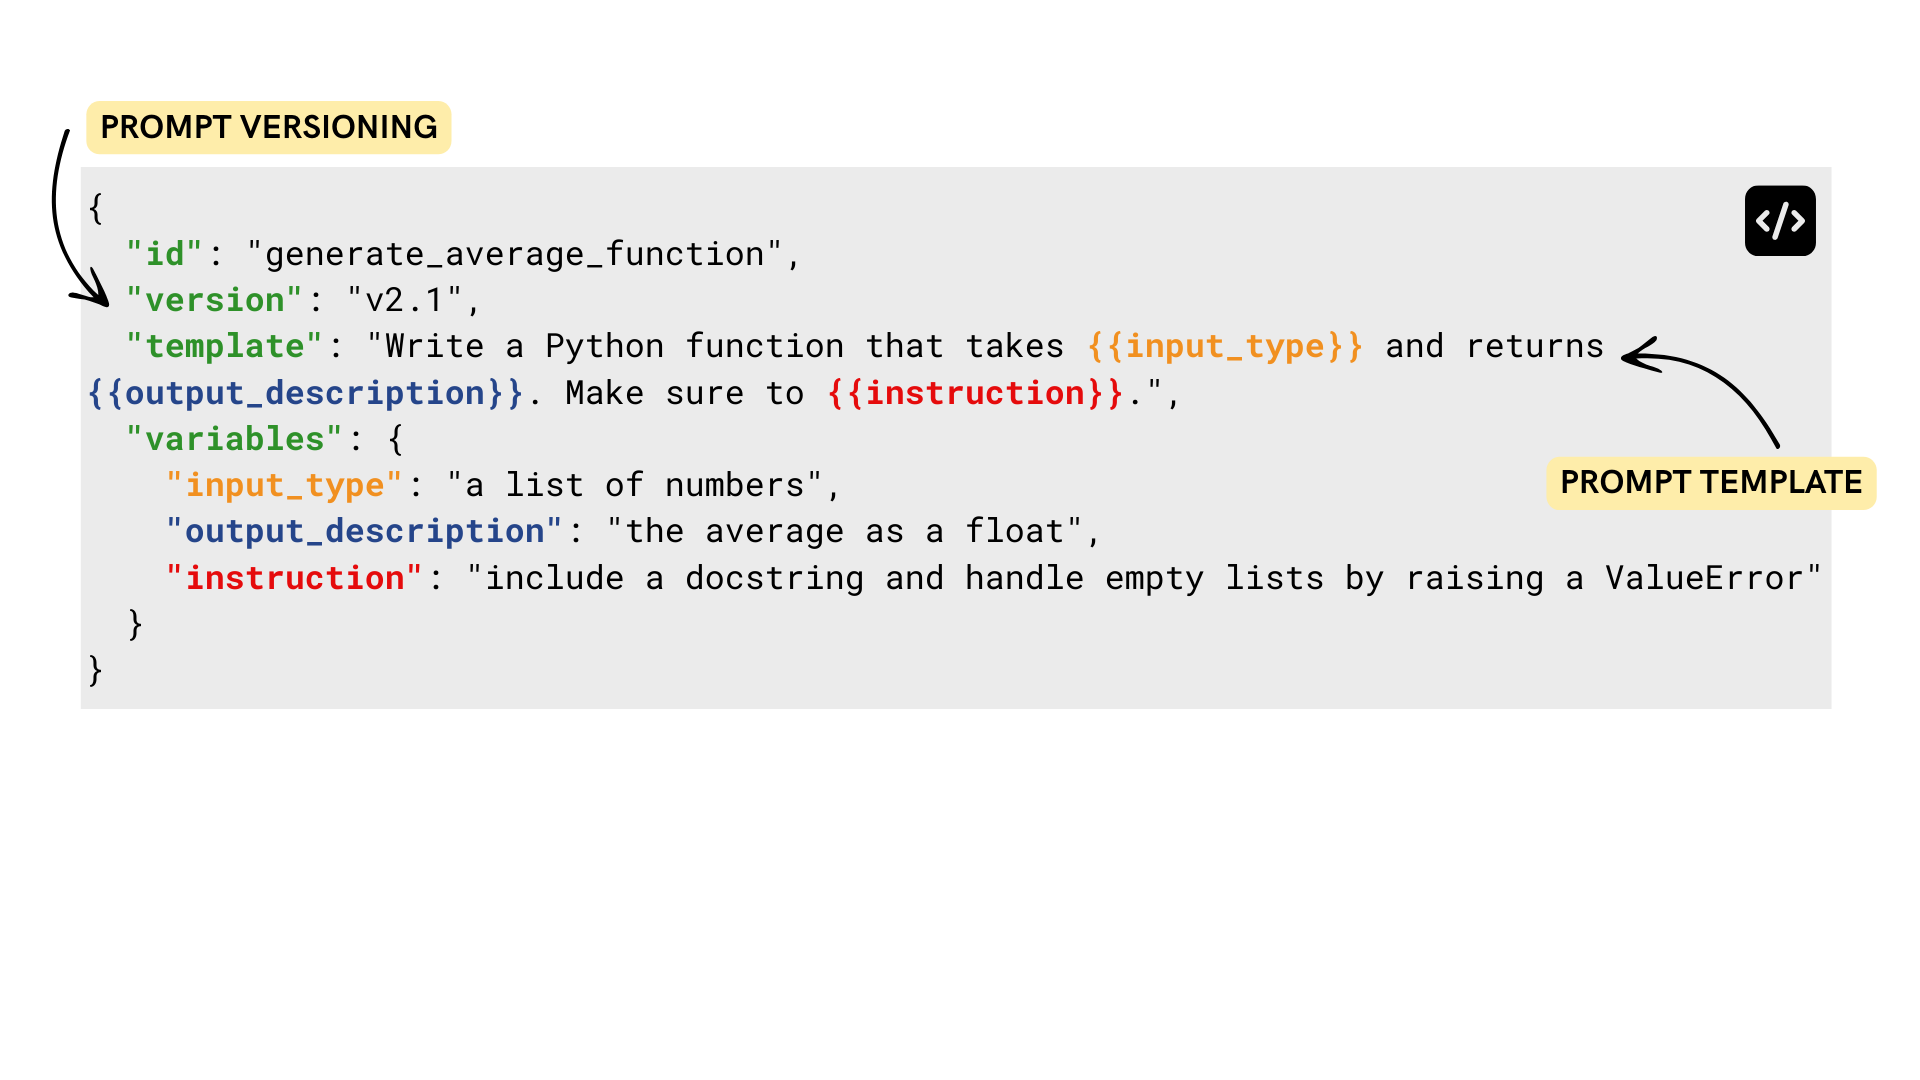
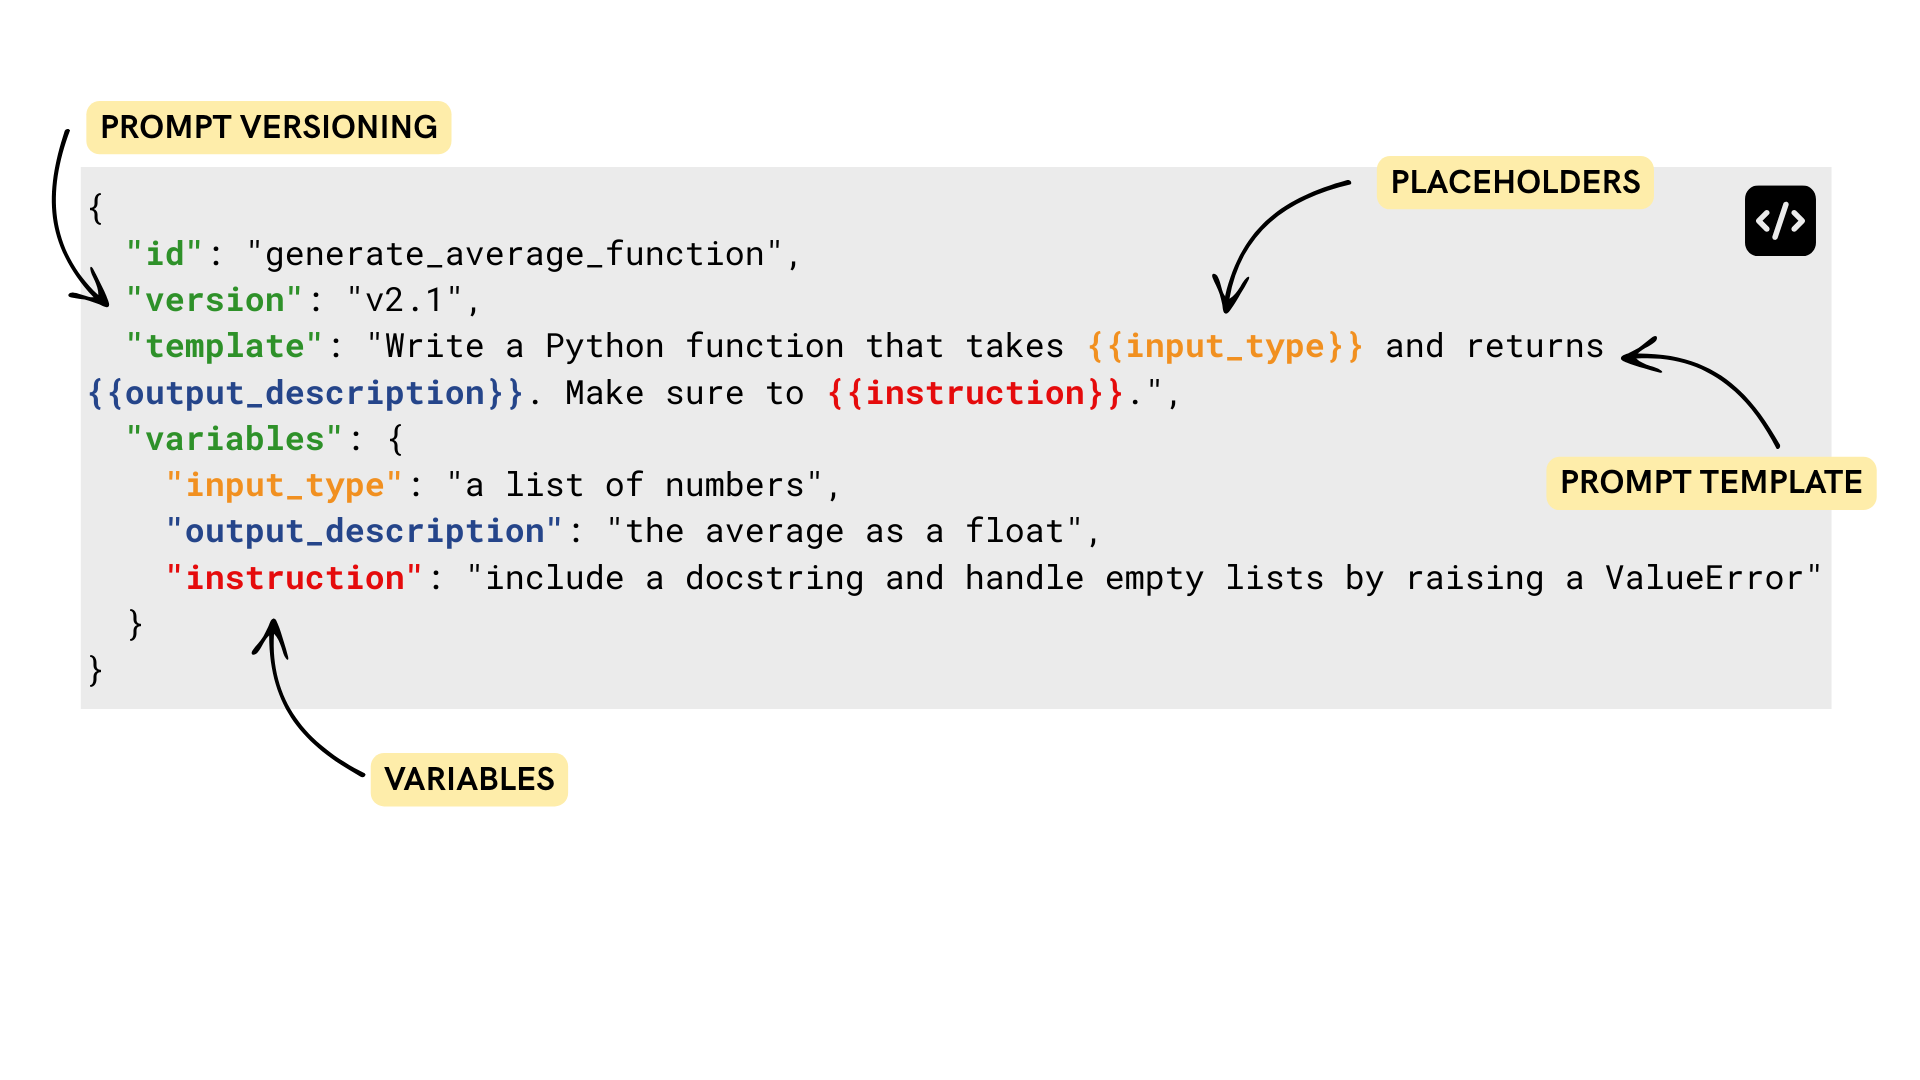
Promptversionshantering
Prompt-caching
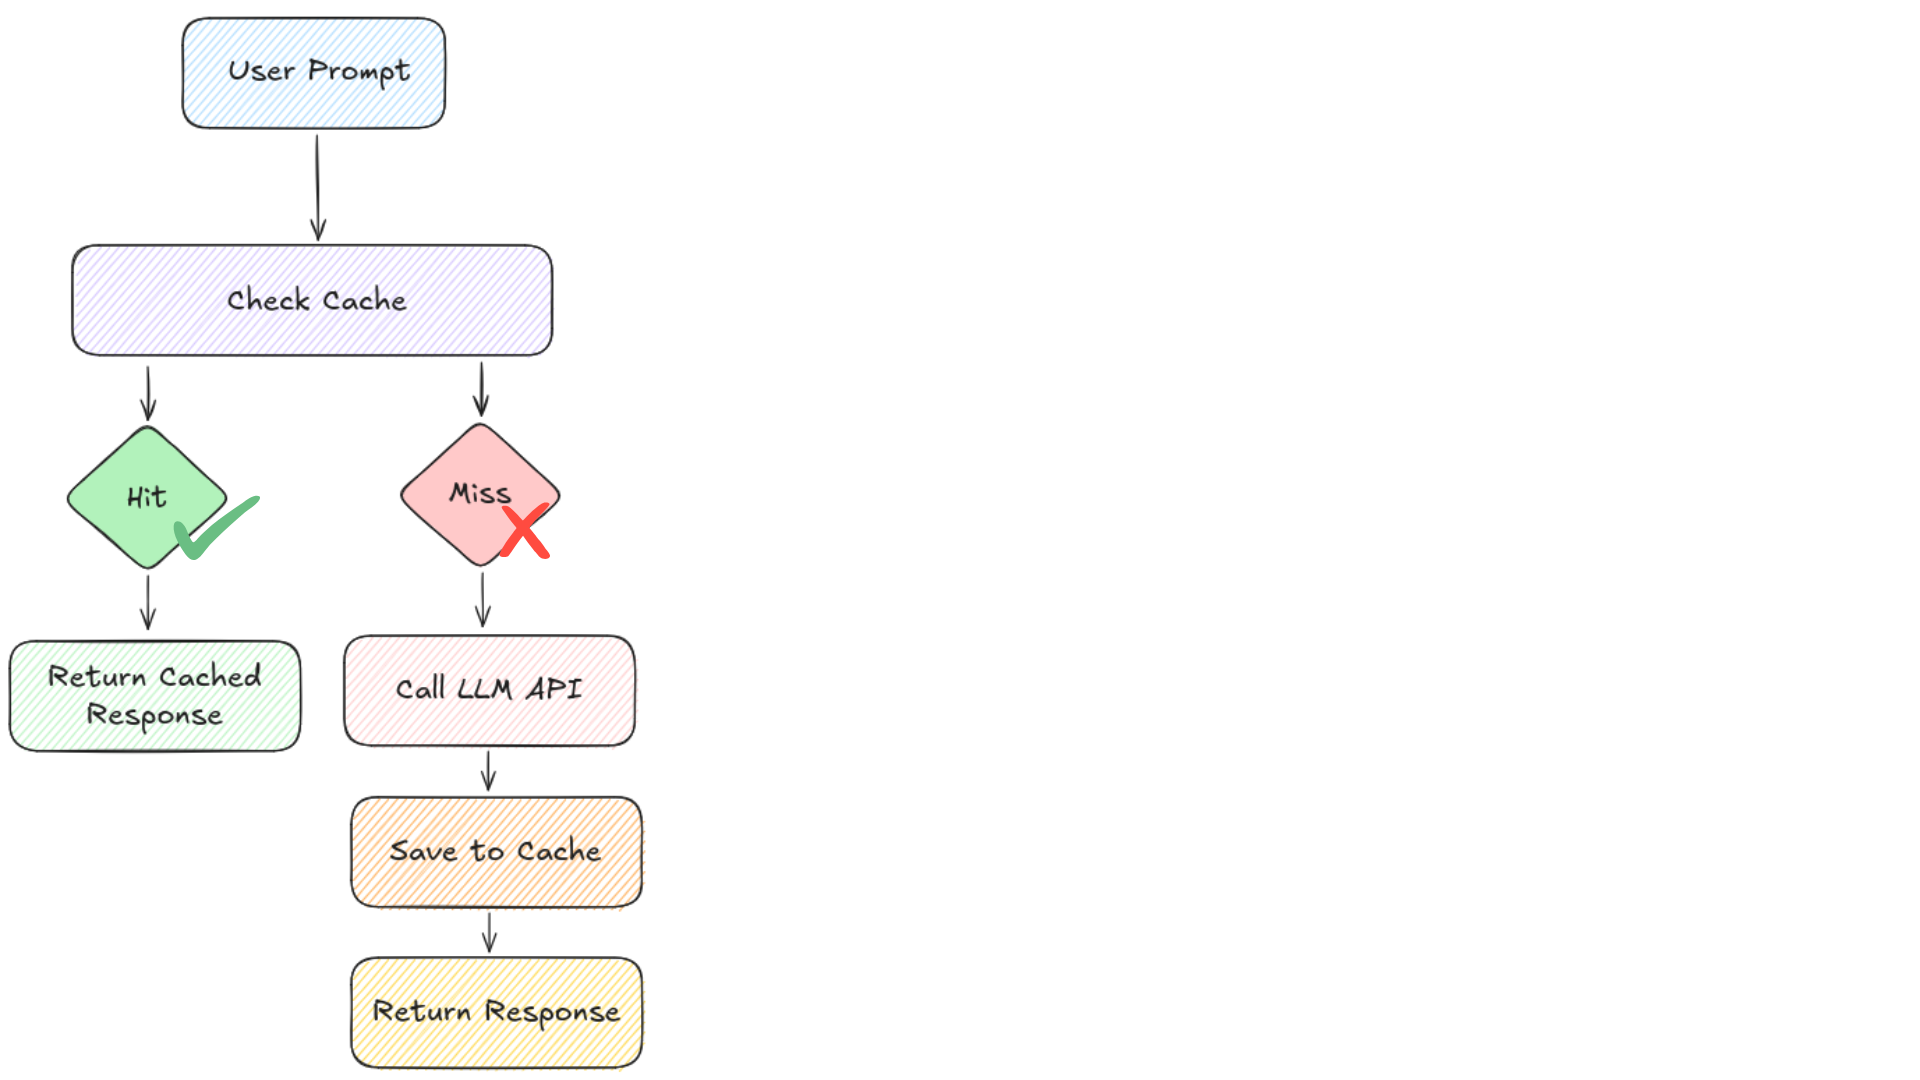
Caching fungerar genom att lagra:
Prompt
Indata
Modell
Temperatur
Nu kör vi en övning!
AI-assisterad kodning för utvecklare
Preparing Video For Download...