Преобразование признаков для улучшения кластеризации

Обучение без учителя на Python

Benjamin Wilson

Director of Research at lateral.io

Набор данных о винах Пьемонта

  • 178 образцов 3 сортов красного вина: Бароло, Гриньолино и Барбера

  • Признаки отражают химический состав: например, содержание алкоголя

  • Визуальные свойства, например «интенсивность цвета»

1 Source: https://archive.ics.uci.edu/ml/datasets/Wine
Обучение без учителя на Python

Кластеризация вин

from sklearn.cluster import KMeans
model = KMeans(n_clusters=3)
labels = model.fit_predict(samples)
Обучение без учителя на Python

Кластеры и сорта

df = pd.DataFrame({'labels': labels, 
                       'varieties': varieties})
ct = pd.crosstab(df['labels'], df['varieties'])

print(ct)
varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Обучение без учителя на Python

Дисперсии признаков

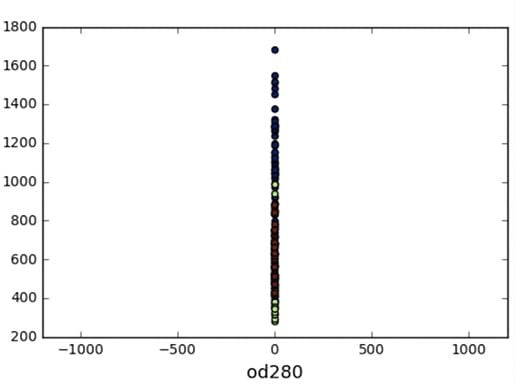
  • Признаки вина имеют очень разные дисперсии!

  • Дисперсия признака отражает разброс его значений

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

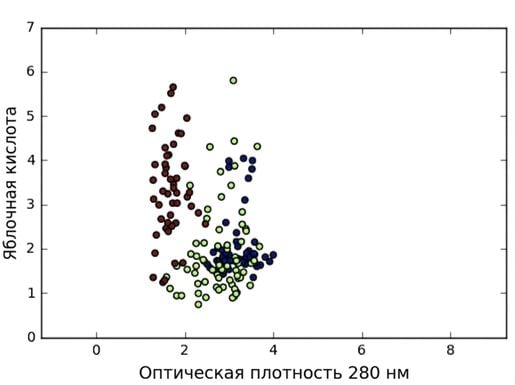
Диаграмма рассеяния: переменная od280 vs malic_acid

Обучение без учителя на Python

Дисперсии признаков

  • Признаки вина имеют очень разные дисперсии!

  • Дисперсия признака отражает разброс его значений

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

Диаграмма рассеяния: переменная od280 vs номер наблюдения

Обучение без учителя на Python

StandardScaler

  • В KMeans: дисперсия признака = влияние признака

  • StandardScaler приводит каждый признак к среднему 0 и дисперсии 1

  • Такие признаки называются «стандартизованными»
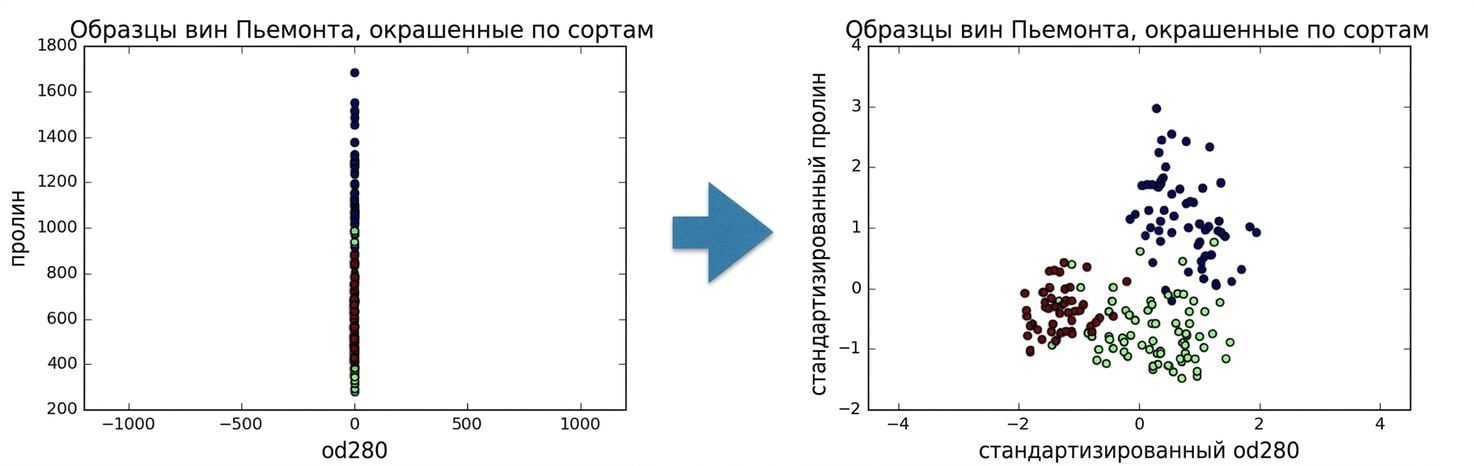
Диаграмма рассеяния: стандартизованный od280 vs стандартизованный proline

Обучение без учителя на Python

StandardScaler в sklearn

from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
scaler.fit(samples) StandardScaler(copy=True, with_mean=True, with_std=True)
samples_scaled = scaler.transform(samples)
Обучение без учителя на Python

Схожие методы

  • StandardScaler и KMeans имеют схожие методы

  • Для StandardScaler используйте fit() / transform()

  • Для KMeans используйте fit() / predict()

Обучение без учителя на Python

StandardScaler, затем KMeans

  • Нужно выполнить два шага: StandardScaler, затем KMeans

  • Конвейер sklearn позволяет объединить несколько шагов

  • Данные последовательно передаются от одного шага к следующему

Обучение без учителя на Python

Конвейеры объединяют несколько шагов

from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
kmeans = KMeans(n_clusters=3)

from sklearn.pipeline import make_pipeline
pipeline = make_pipeline(scaler, kmeans)
pipeline.fit(samples)
Pipeline(steps=...)
labels = pipeline.predict(samples)
Обучение без учителя на Python

Стандартизация признаков улучшает кластеризацию

Со стандартизацией признаков:

varieties  Barbera  Barolo  Grignolino
labels                                
0                0      59           3
1               48       0           3
2                0       0          65

Без стандартизации результат был значительно хуже:

varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Обучение без учителя на Python

Шаги предобработки в sklearn

  • StandardScaler — шаг «предобработки»

  • Другие примеры: MaxAbsScaler и Normalizer

Обучение без учителя на Python

Давайте потренируемся!

Обучение без учителя на Python

Preparing Video For Download...