使用 PySpark 进行特征工程
John Hogue
Lead Data Scientist, General Mills
df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary|         LISTPRICE|
+-------+------------------+
|  count|              5000|
|   mean|        263419.365|
| stddev|143944.10818036905|
|    min|            100000|
|    max|             99999|
+-------+------------------+
pyspark.sql.functions.mean(col)
pyspark.sql.functions.skewness(col)
pyspark.sql.functions.min(col)
cov(col1, col2)
corr(col1, col2)
mean(col)
df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783
使用 Seaborn 等标准库绘制 PySpark DataFrame 需先转换为 Pandas
警告: 在转换为 Pandas 前先对 PySpark DataFrame 进行抽样!
sample(withReplacement, fraction, seed=None)
withReplacement
fraction
seed
# 抽样 50% 的 PySpark DataFrame 并计数行数
df.sample(False, 0.5, 42).count()
2504
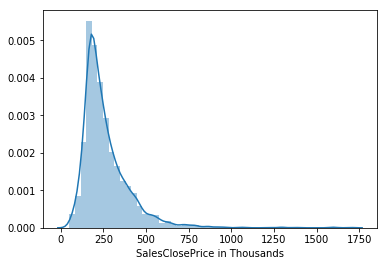
Seaborn distplot()
distplot()
seaborn.distplot(a)
a
# 导入你喜欢的可视化库
import seaborn as sns

# 抽样数据框
sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)

# 将样本转换为 Pandas DataFrame
pandas_df = sample_df.toPandas()

# 绘制
sns.distplot(pandas_df)
# 导入你喜欢的可视化库 import seaborn as sns
# 抽样数据框 sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)
# 将样本转换为 Pandas DataFrame pandas_df = sample_df.toPandas()
# 绘制 sns.distplot(pandas_df)
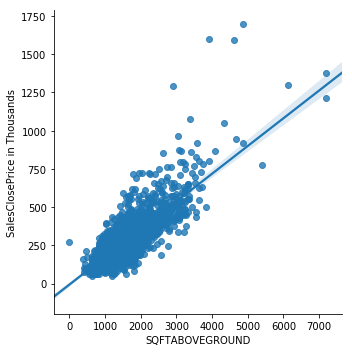
Seaborn lmplot()
lmplot()
seaborn.lmplot(x, y, data)
x
y
data
# 导入你喜欢的可视化库
import seaborn as sns

# 选择列
s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND'])
# 抽样数据框
s_df = s_df.sample(False, 0.5, 42)

# 转为 Pandas DataFrame
pandas_df = s_df.toPandas()

# 绘制
sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)
# 选择列 s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # 抽样数据框 s_df = s_df.sample(False, 0.5, 42)
# 转为 Pandas DataFrame pandas_df = s_df.toPandas()
# 绘制 sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)