使用 PySpark 进行特征工程
John Hogue
Lead Data Scientist, General Mills
数据收集
数据存储规则
合并异构数据
有意缺失
完全随机缺失(MCAR)
条件随机缺失(MAR)
非随机缺失(MNAR)
何时丢弃含缺失的行?
isNull()
df.where(df['ROOF'].isNull()).count()
765
# Import library
import seaborn as sns

# subset the dataframe
sub_df = df.select(['ROOMAREA1'])

# sample the dataframe
sample_df = sub_df.sample(False, .5, 4)

# Convert to Pandas DataFrame
pandas_df = sample_df.toPandas()

# Plot it
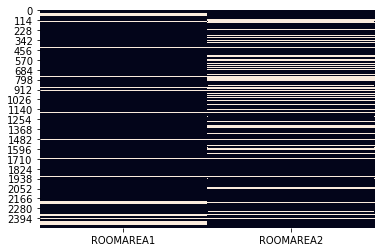
sns.heatmap(data=pandas_df.isnull())
# Import library import seaborn as sns
# subset the dataframe sub_df = df.select(['ROOMAREA1'])
# sample the dataframe sample_df = sub_df.sample(False, .5, 4)
# Convert to Pandas DataFrame pandas_df = sample_df.toPandas()
# Plot it sns.heatmap(data=pandas_df.isnull())
替换缺失值的流程
基于规则
基于统计
基于模型
** fillna(value, subset=None)
fillna(value, subset=None)
value
subset
# 用 0 替换缺失值
df.fillna(0, subset=['DAYSONMARKET'])
# 用该列的均值替换
col_mean = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
df.fillna(col_mean, subset=['DAYSONMARKET'])