深度Q学习简介

Python 中的深度强化学习

Timothée Carayol

Principal Machine Learning Engineer, Komment

什么是深度Q学习?
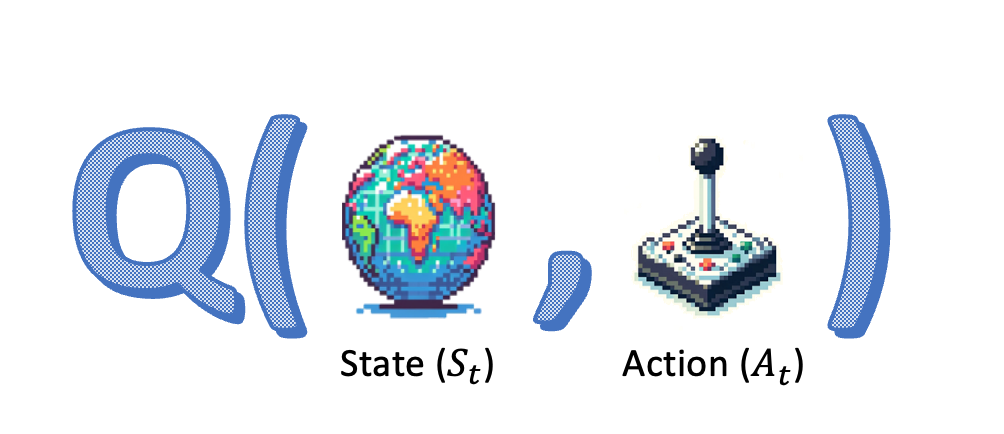


Q(状态, 动作) 的示意图;状态以地球表示,动作以操纵杆表示

Python 中的深度强化学习

Q-Learning 复习


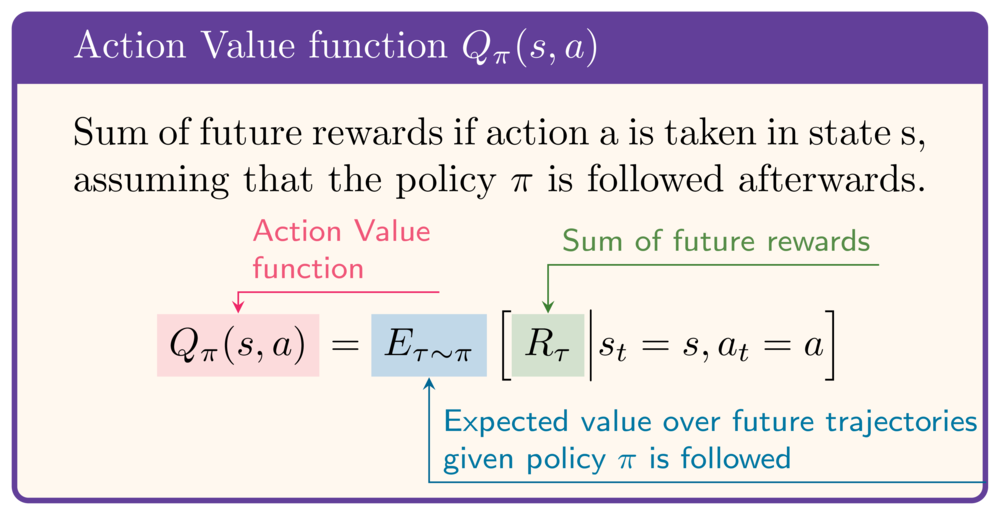
动作价值函数 Q_pi(s,a):在状态 s 采取动作 a 后、随后遵循策略 pi 时的未来回报之和。Q_pi(s,a) = 在后续轨迹上、给定遵循策略 pi 且 s_t=s、a_t=a 的情况下,对回报 R_tau 的期望值


  • 若已知 $Q$,可得最优策略:$$ \pi(s_t) = {\arg\max}_a Q(s_t, a) $$

  • Q-learning 的目标:随时间学习 $Q$

Python 中的深度强化学习

Q-Learning 复习

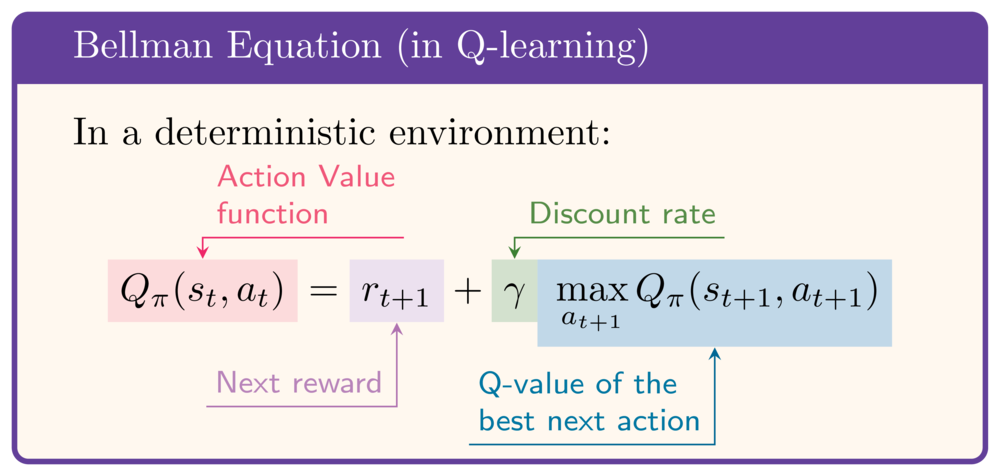
确定性环境下(Q-learning)的贝尔曼方程:Q_pi(s_t, a_t) = 奖励 r_t+1 + 折扣因子 gamma * 对 a_t+1 的最大值 Q_pi(s_t+1, a_t+1))

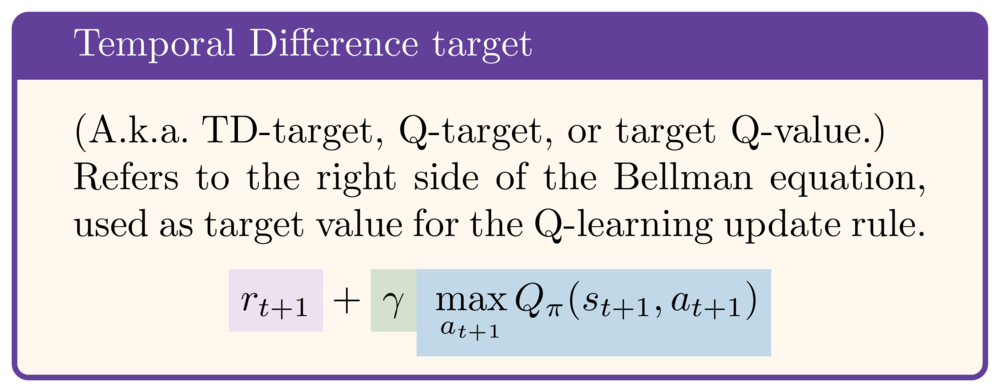
时序差分目标(TD-target),又称 Q 目标或目标 Q 值:指贝尔曼方程右侧,用作 Q-learning 更新规则的目标值。r_t+1 + gamma * max over a_t+1 of Q_pi(s_t+1, a_t+1))

  • 贝尔曼方程:$Q$ 的递推公式
  • 贝尔曼方程右侧:TD-target
  • 用 TD-target 更新每步的 $\hat{Q}$

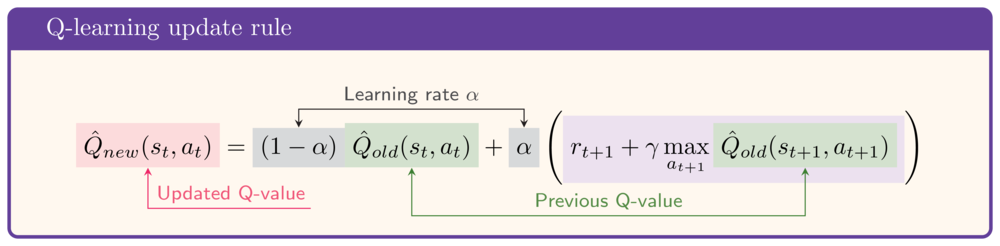
Q-learning 更新规则:Q_new = (1-alpha) Q_old + alpha * TD-target

Python 中的深度强化学习

Q网络

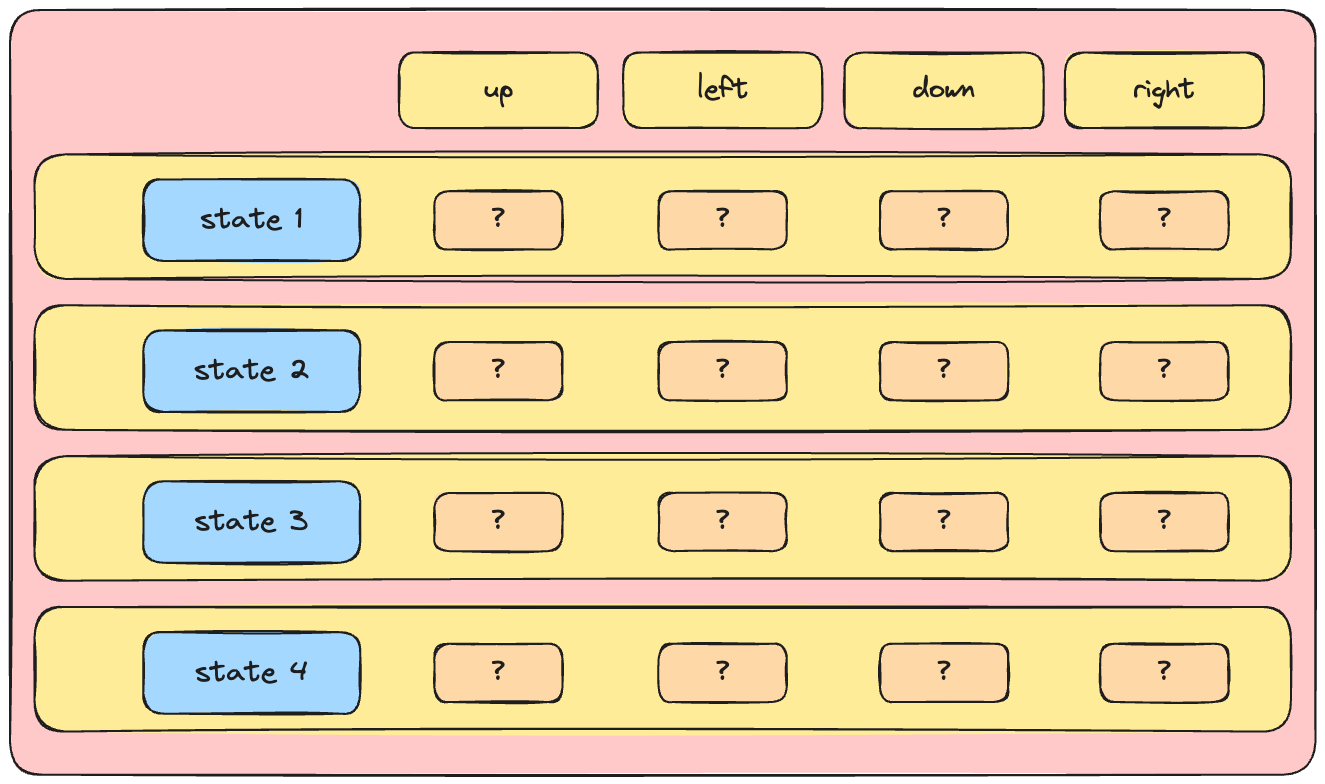
一个含4个状态和4个动作的Q表,共16个单元格

Python 中的深度强化学习

Q网络

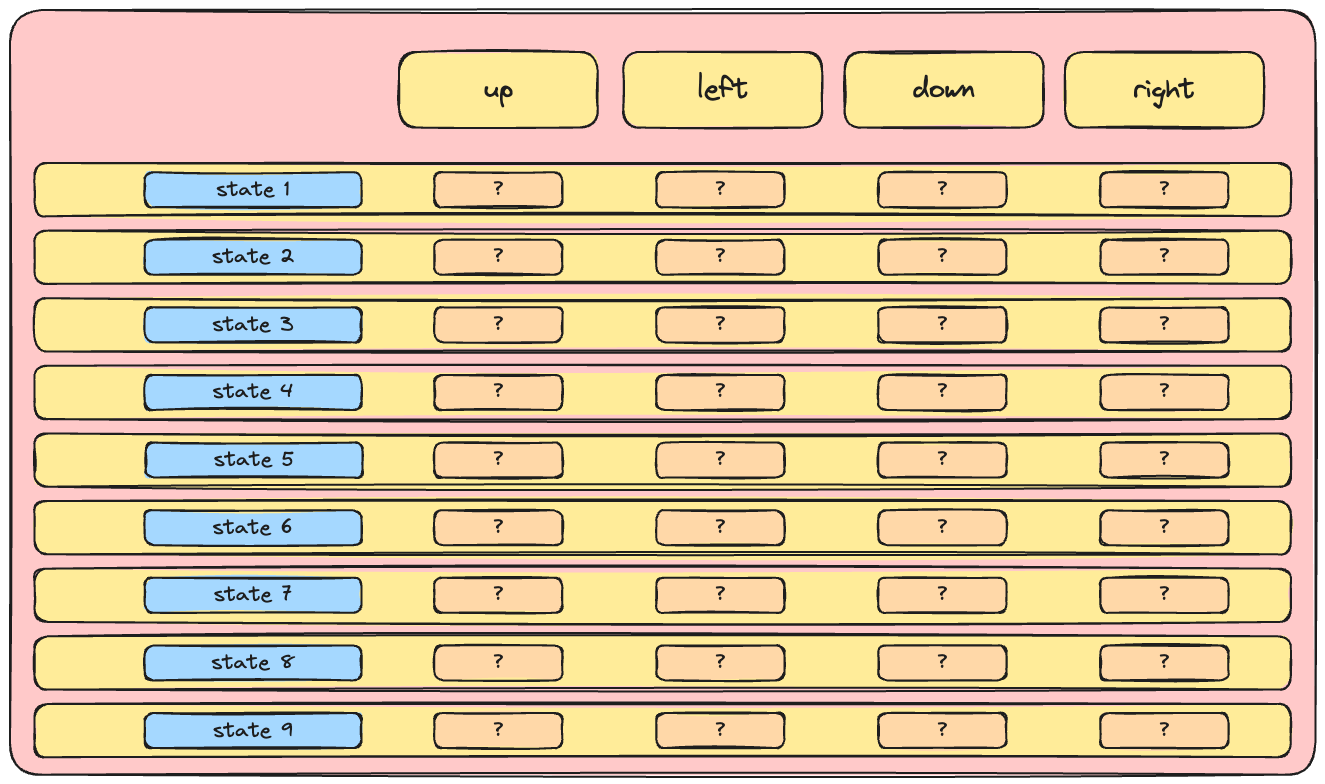
一个含9个状态和4个动作的Q表,共36个单元格

Python 中的深度强化学习

Q网络

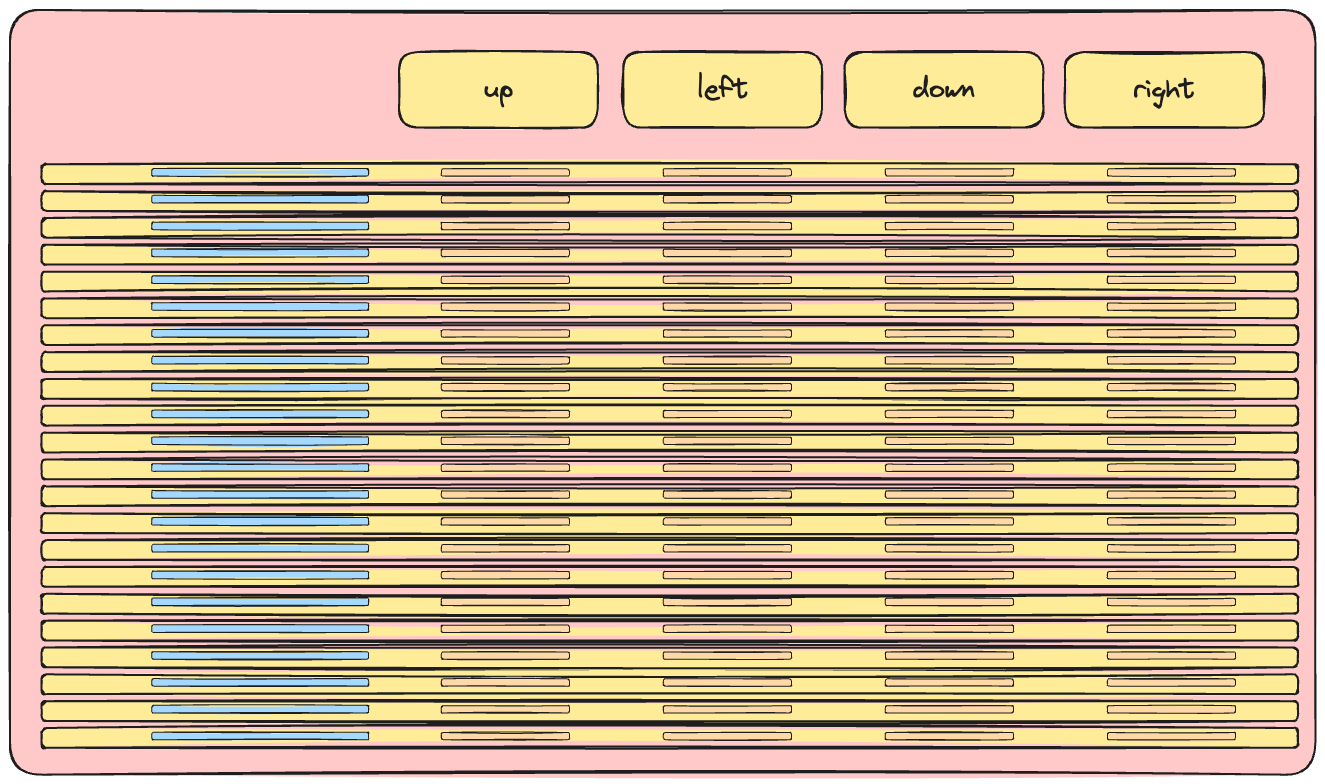
一个含数十个状态和4个动作的Q表,约有100个单元格

Python 中的深度强化学习

Q网络

  • 深度Q学习的核心:神经网络

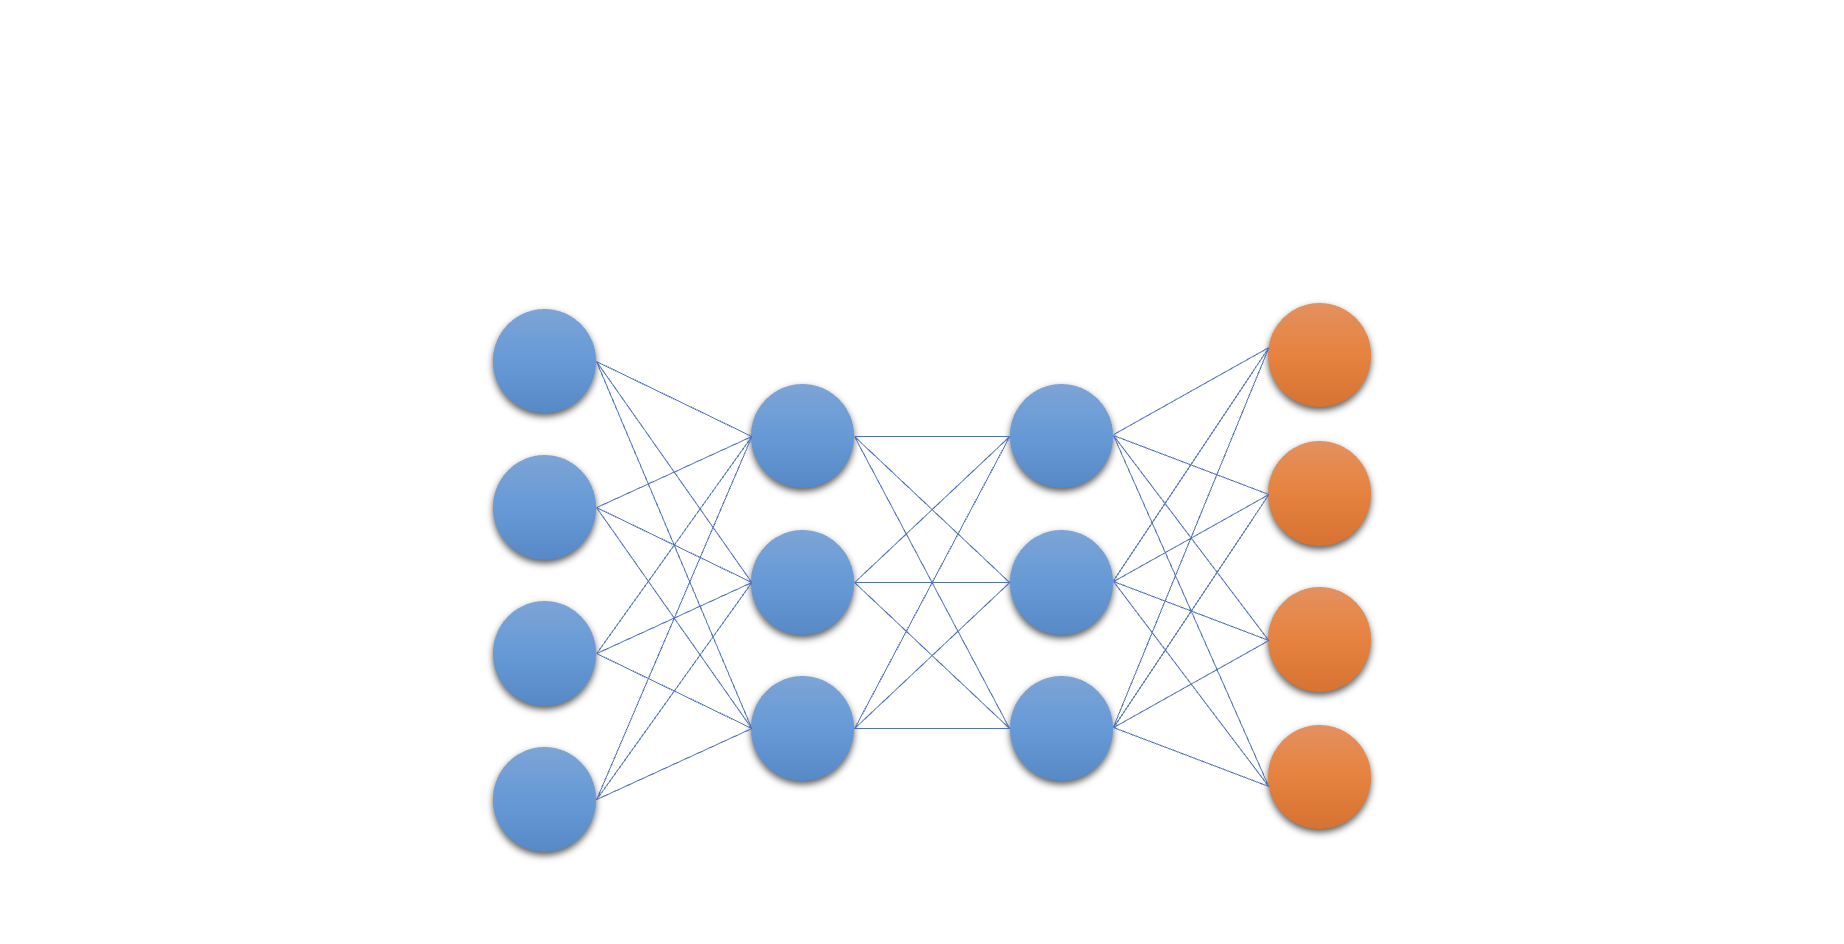
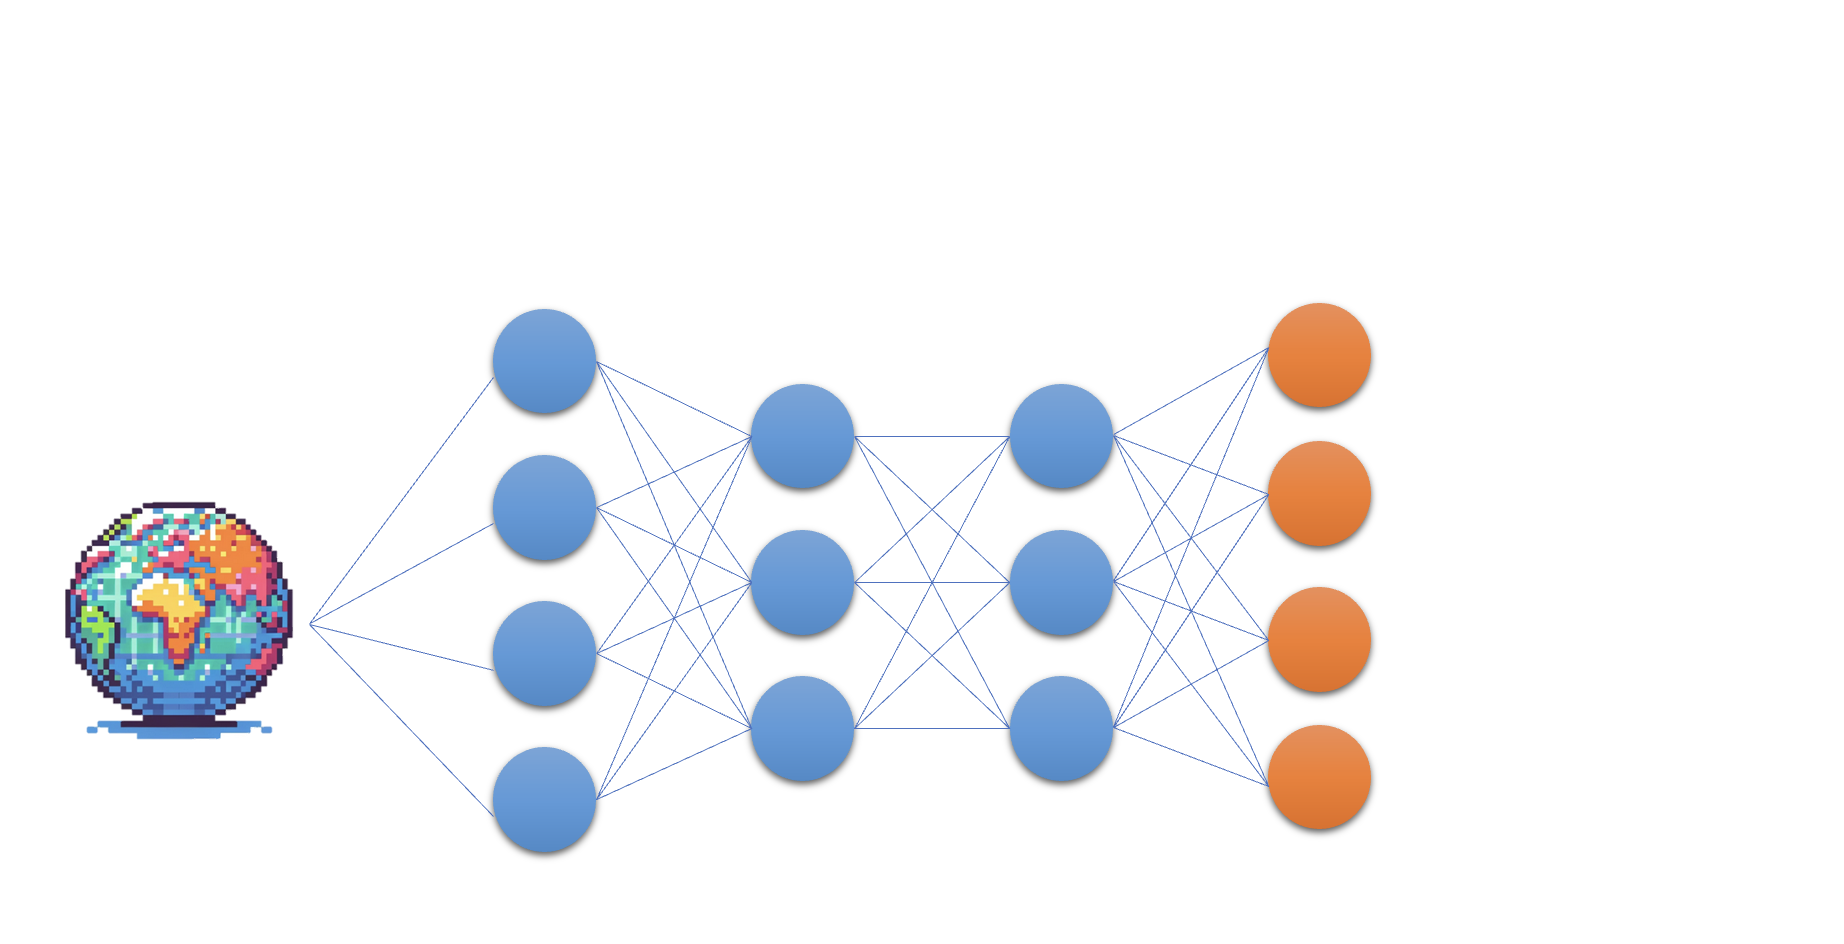
一个含两层隐藏层的全连接神经网络示意图

Python 中的深度强化学习

Q网络

  • 深度Q学习的核心:神经网络

全连接网络示意图,含两层隐藏层;上一页的地球图像输入到输入层

Python 中的深度强化学习

Q网络

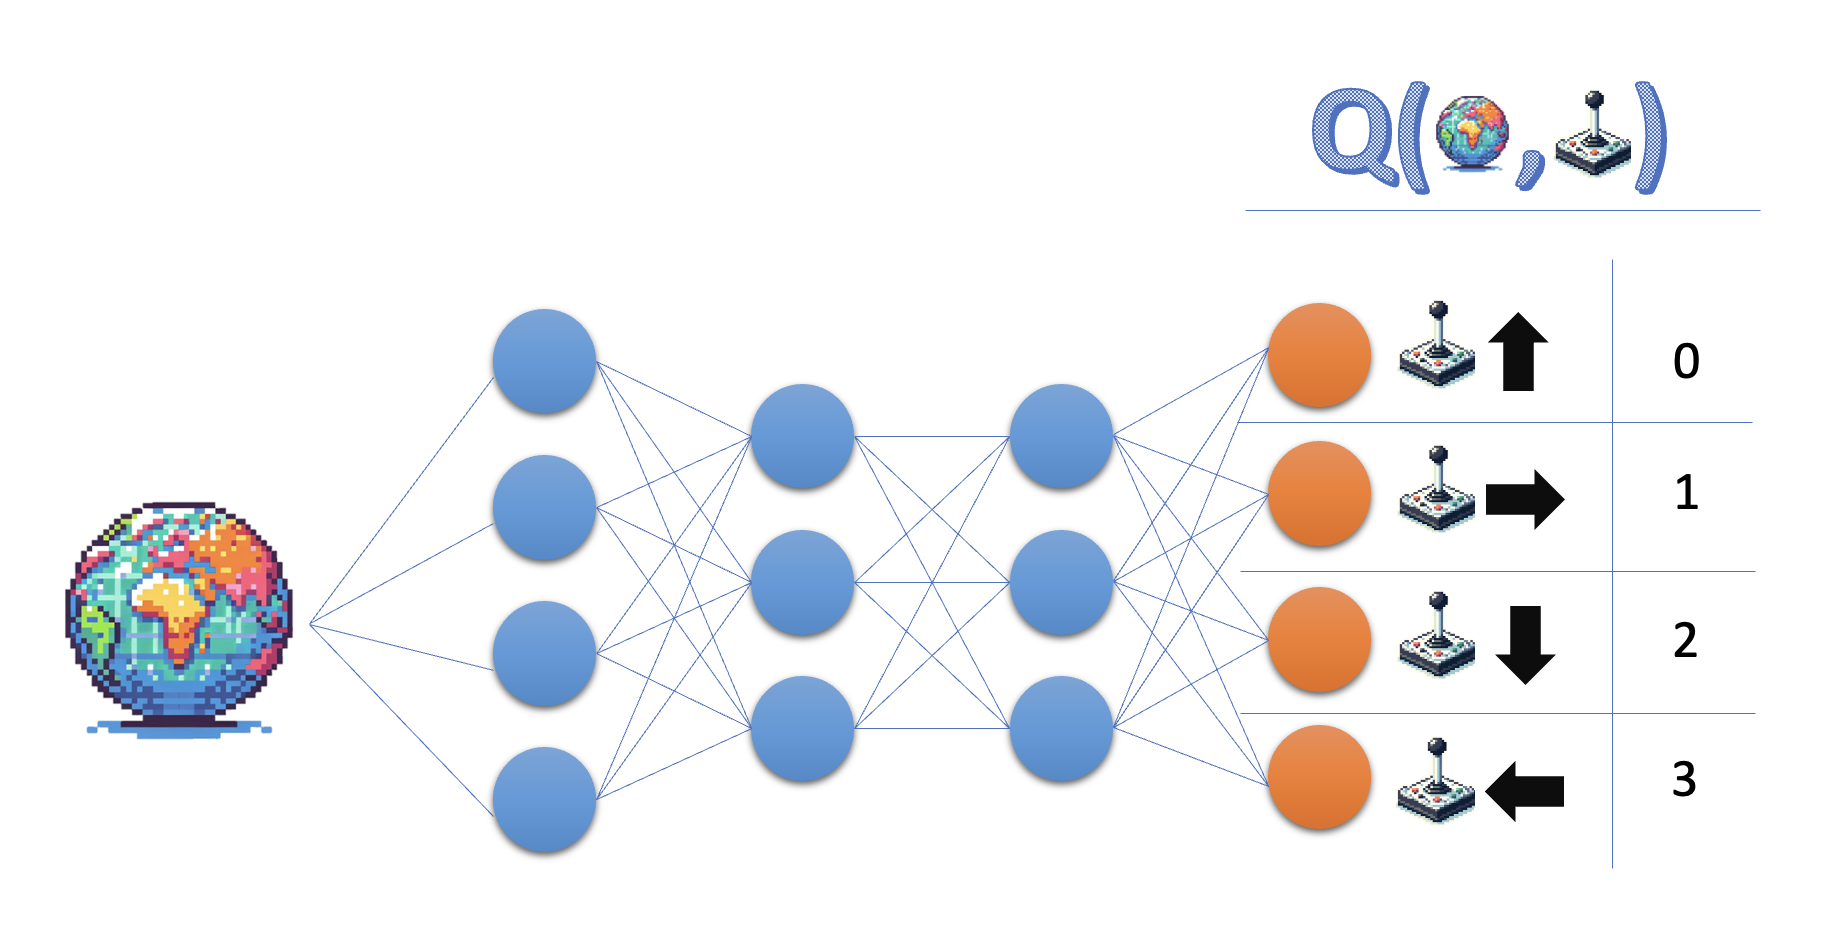
  • 深度Q学习的核心:将状态映射到Q值的神经网络

沿用上一页示意图,输出层各节点对应操纵杆方向的动作:上=动作0,右=1,下=2,左=3。

  • 近似动作价值函数的网络称为"Q网络"
  • Q网络常用于深度Q学习算法,如DQN。
Python 中的深度强化学习

实现Q网络

class QNetwork(nn.Module):

def __init__(self, state_size, action_size): super(QNetwork, self).__init__()
self.fc1 = nn.Linear(state_size, 64) self.fc2 = nn.Linear(64, 64) self.fc3 = nn.Linear(64, action_size)
def forward(self, state): x = torch.relu(self.fc1(torch.tensor(state))) x = torch.relu(self.fc2(x)) return self.fc3(x)
q_network = QNetwork(8, 4)
optimizer = optim.Adam(q_network.parameters(), lr=0.0001)
  • 输入维度由状态决定
  • 输出维度由可选动作数决定

  • 本例:

    • 2个隐藏层,每层64个节点
    • ReLu 激活函数
Python 中的深度强化学习

开始练习吧!

Python 中的深度强化学习

Preparing Video For Download...