Python 中的深度强化学习
Timothée Carayol
Principal Machine Learning Engineer, Komment
| 示例 |
|---|
| 折扣率 |
| PPO:裁剪 epsilon、熵奖励 |
| 经验回放:缓冲区大小、批大小 |
| 递减的 epsilon 贪心策略 |
| 固定 Q 目标:$\tau$ |
| 学习率 |
| 层数、每层节点数… |
目标:平均累计回报
超参数搜索方法:


Optuna 工作流:
study
import optunadef objective(trial): ...study = optuna.create_study()study.optimize(objective, n_trials=100)
study.best_params
{'learning_rate': 0.001292481, 'batch_size': 8}
在目标函数中:
超参数指定方式高度灵活:
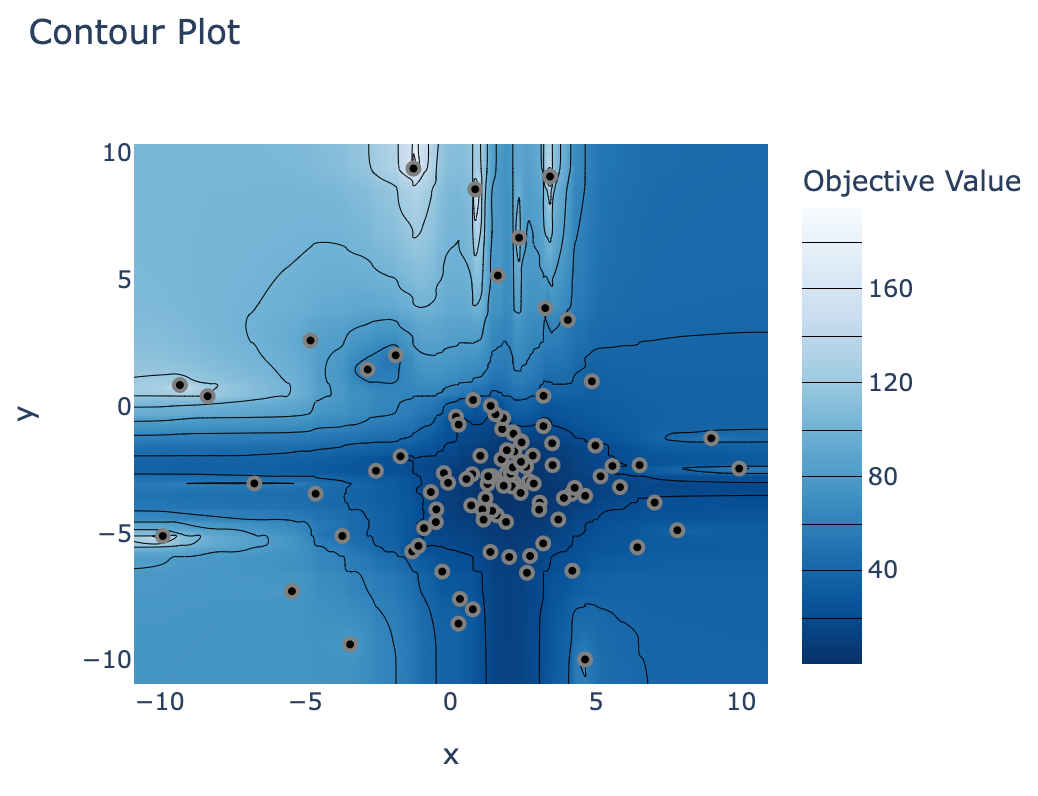
def objective(trial: optuna.trial.Trial):# Hyperparameters x and y between -10 and 10x = trial.suggest_float('x', -10, 10) y = trial.suggest_float('y', -10, 10)# Return the metric to minimize return (x - 2) ** 2 + 1.2 * (y + 3) ** 2
n_trialsn_trials:持续运行直至中断
import sqlite study = optuna.create_study( storage="sqlite:///DRL.db", study_name="my_study")study.optimize(objective, n_trials=100)
loaded_study = optuna.load_study(
study_name="my_study",
storage="sqlite:///DRL.db")
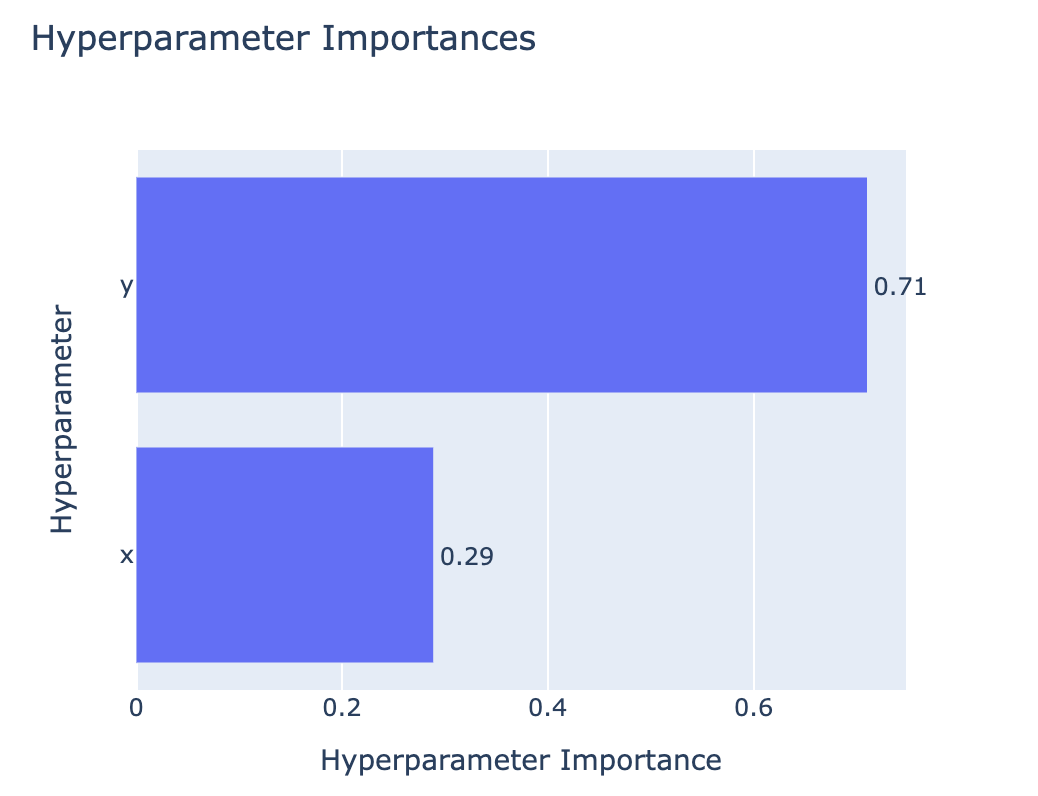
optuna.visualization.plot_param_importances(study)
optuna.visualization.plot_contour(study)
Python 中的深度强化学习