策略梯度的批量更新

Python 中的深度强化学习

Timothée Carayol

Principal Machine Learning Engineer, Komment

逐步更新 vs 批量梯度更新
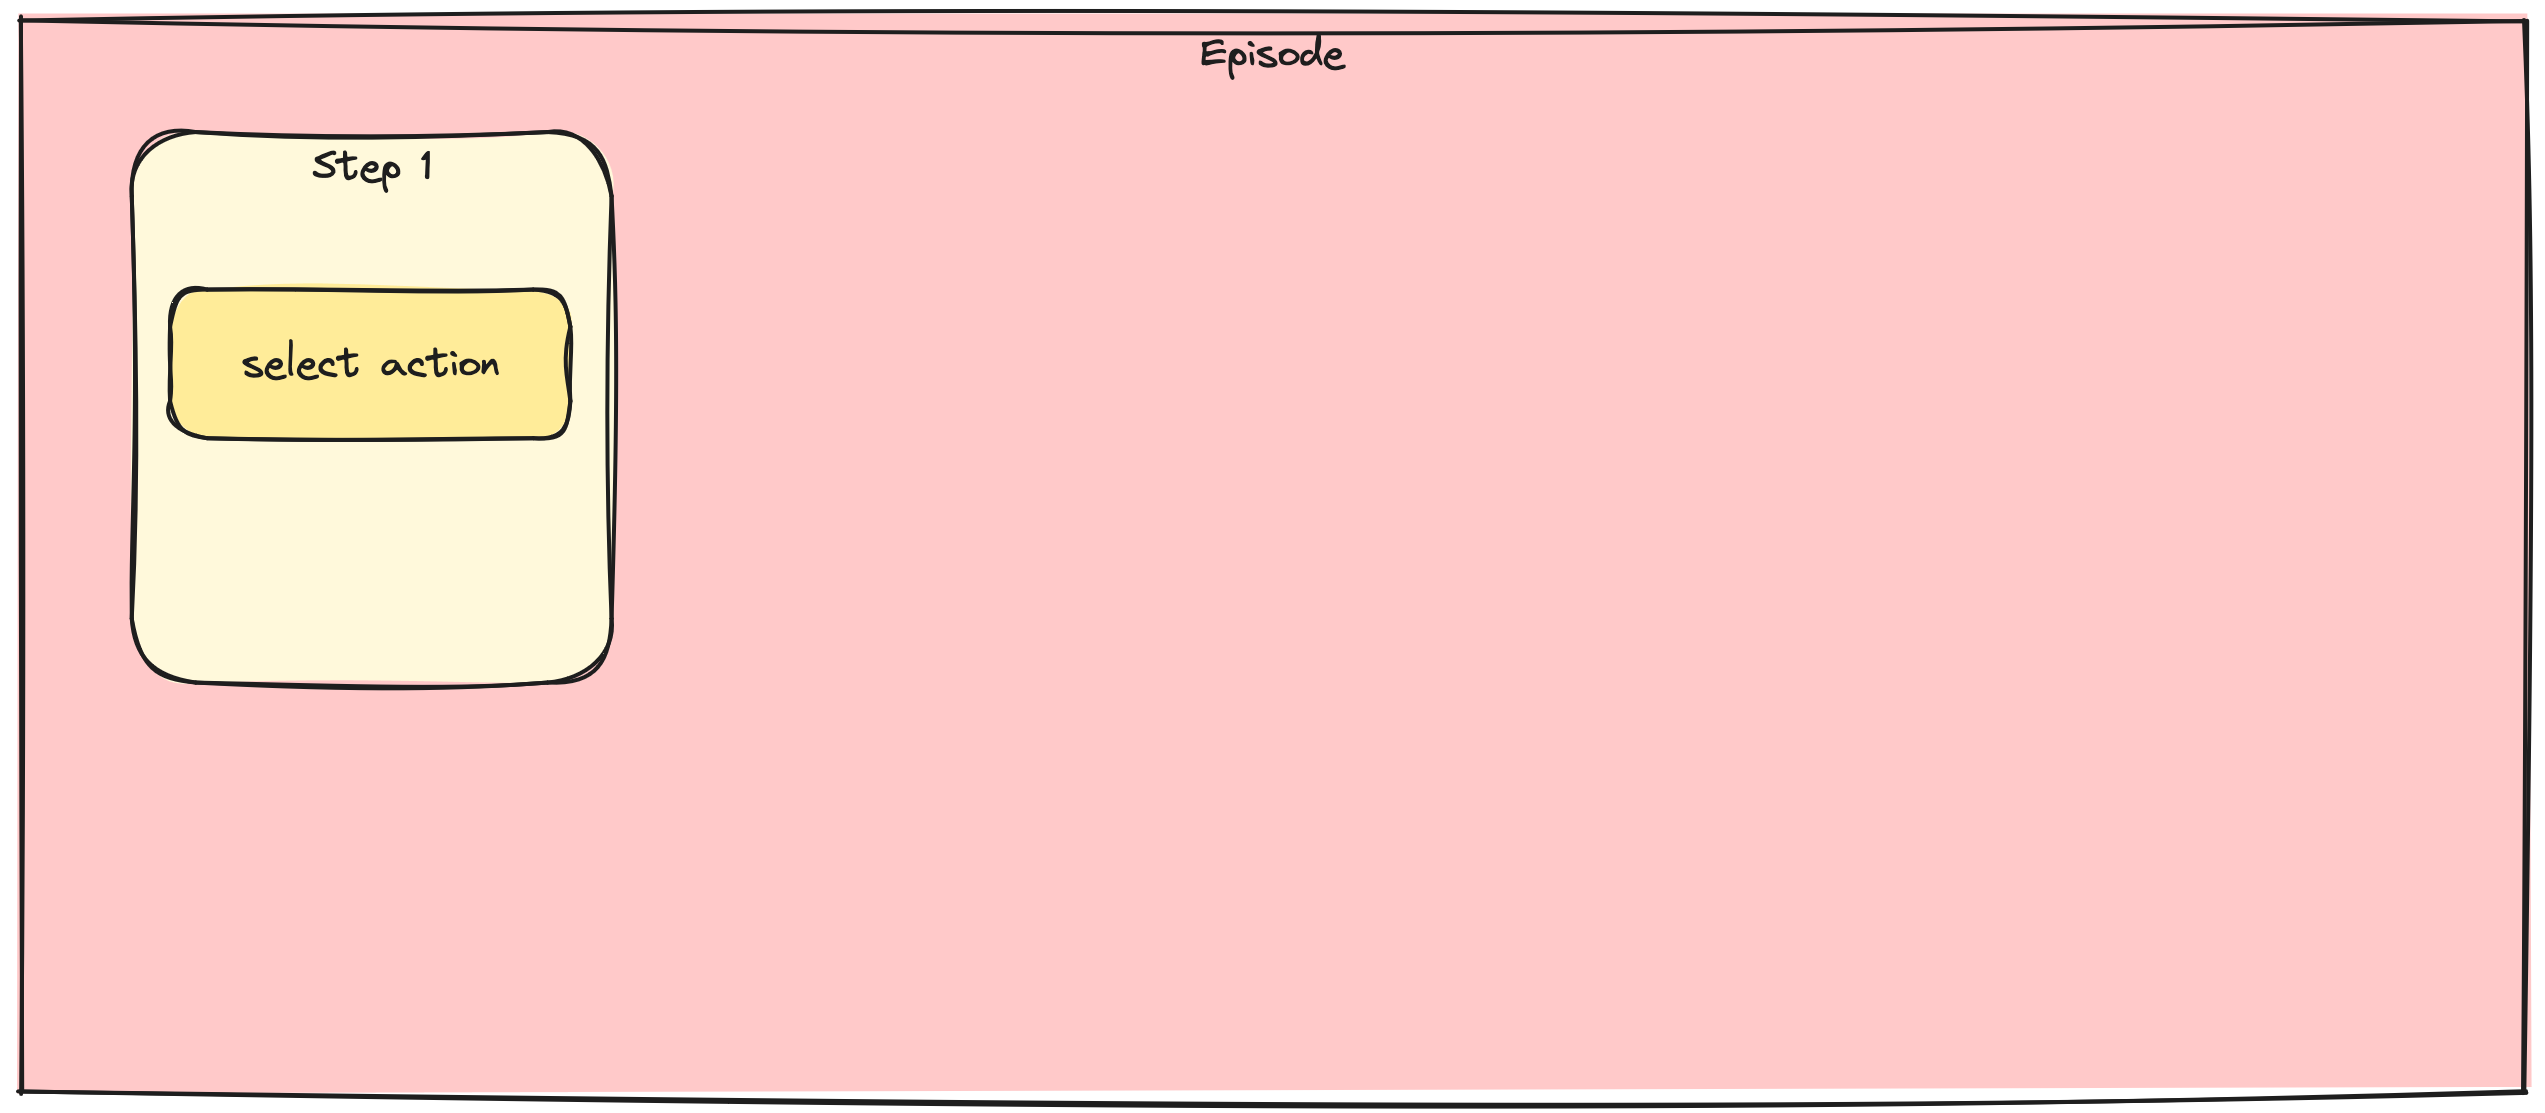
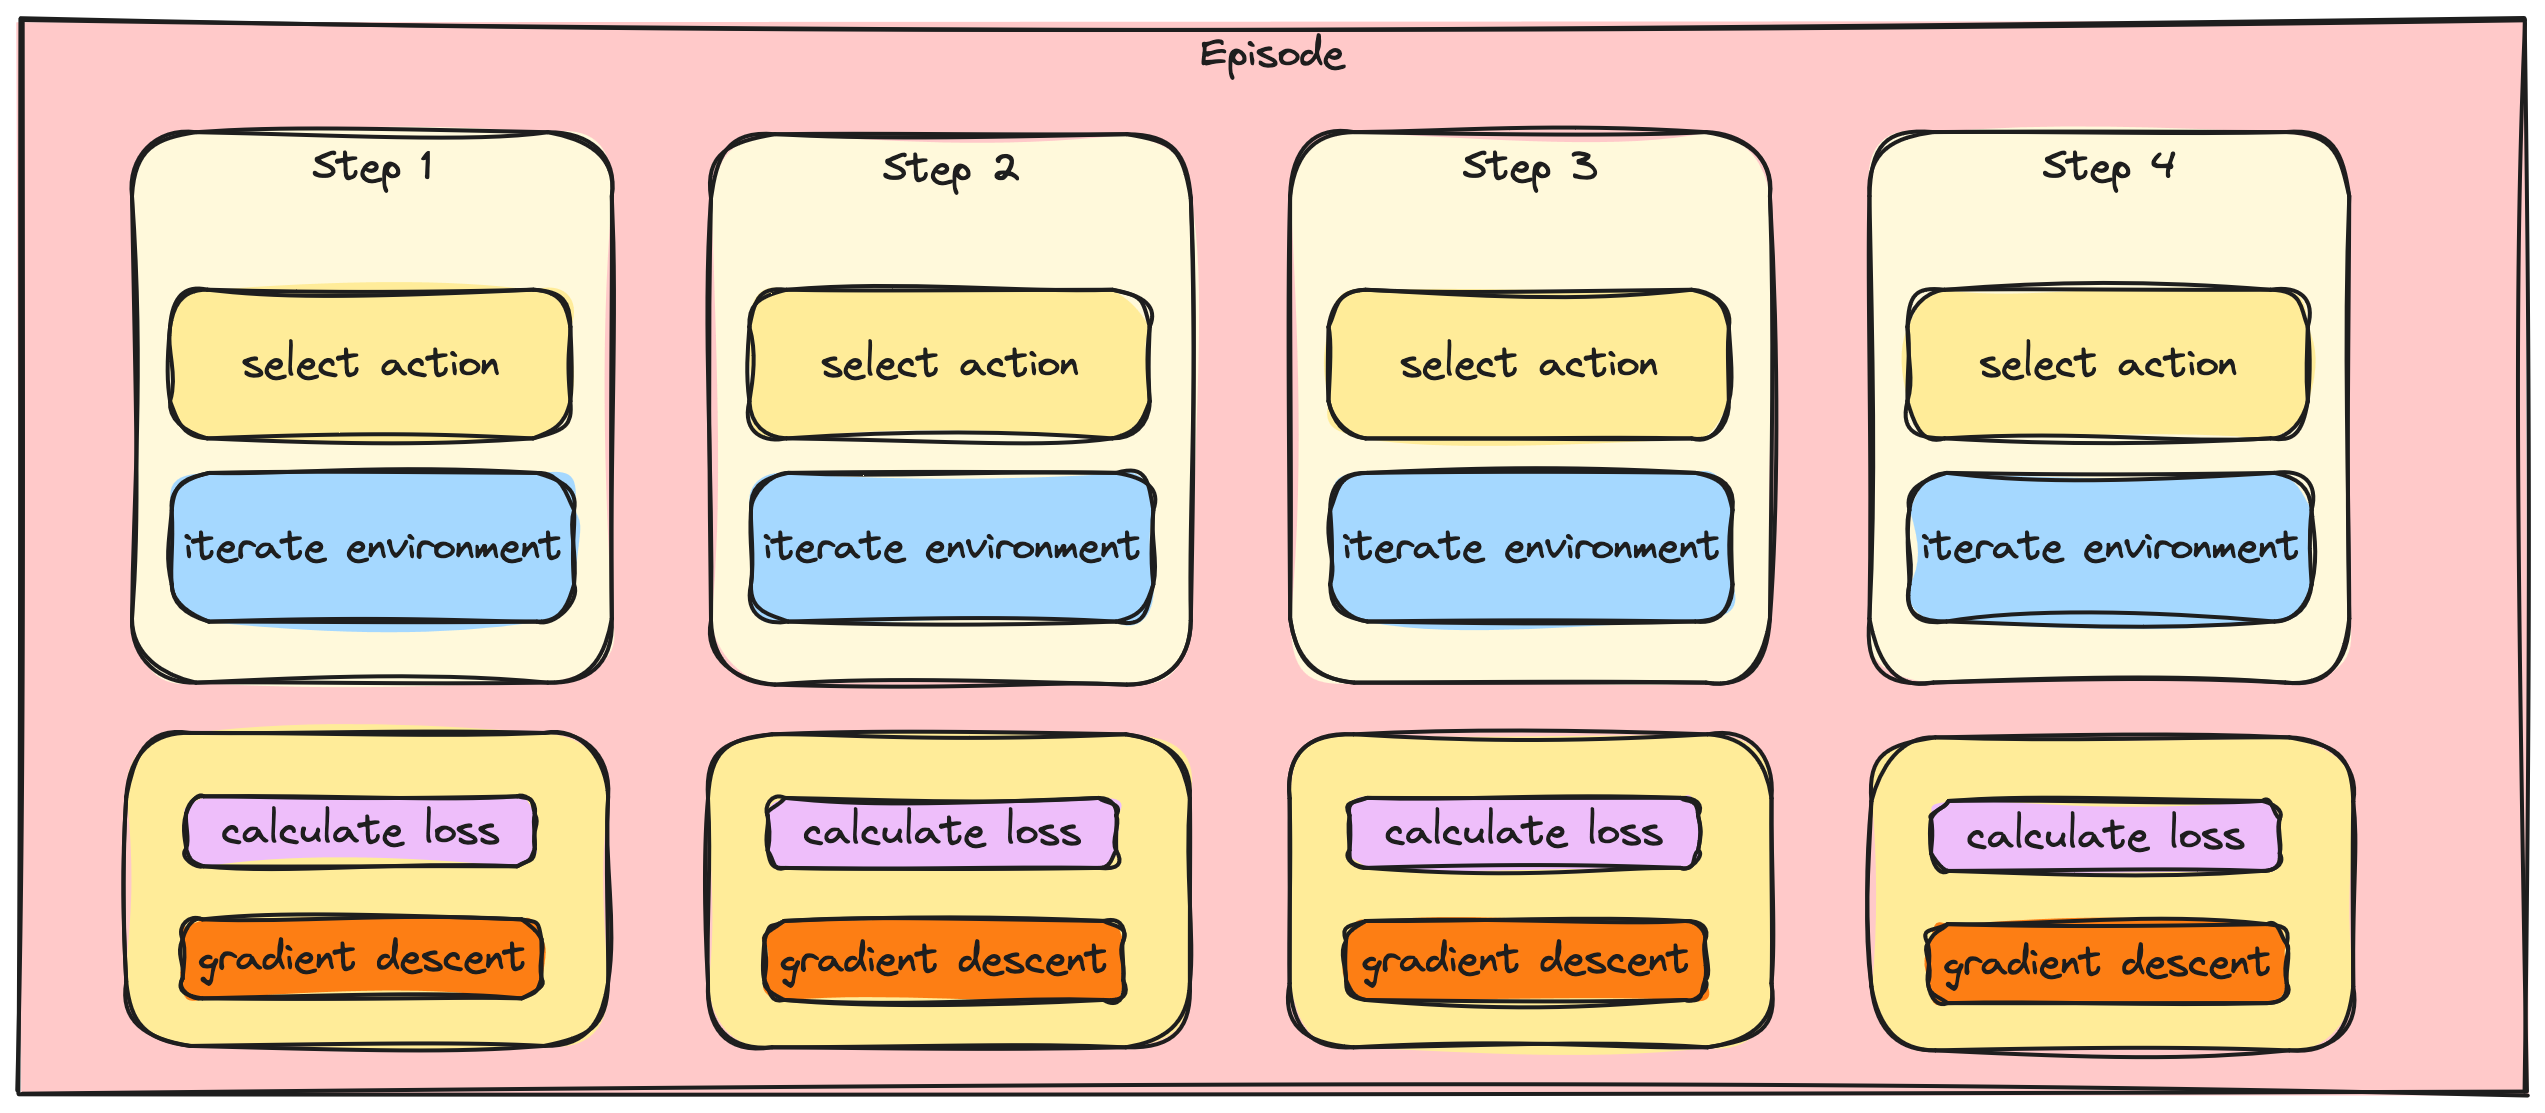
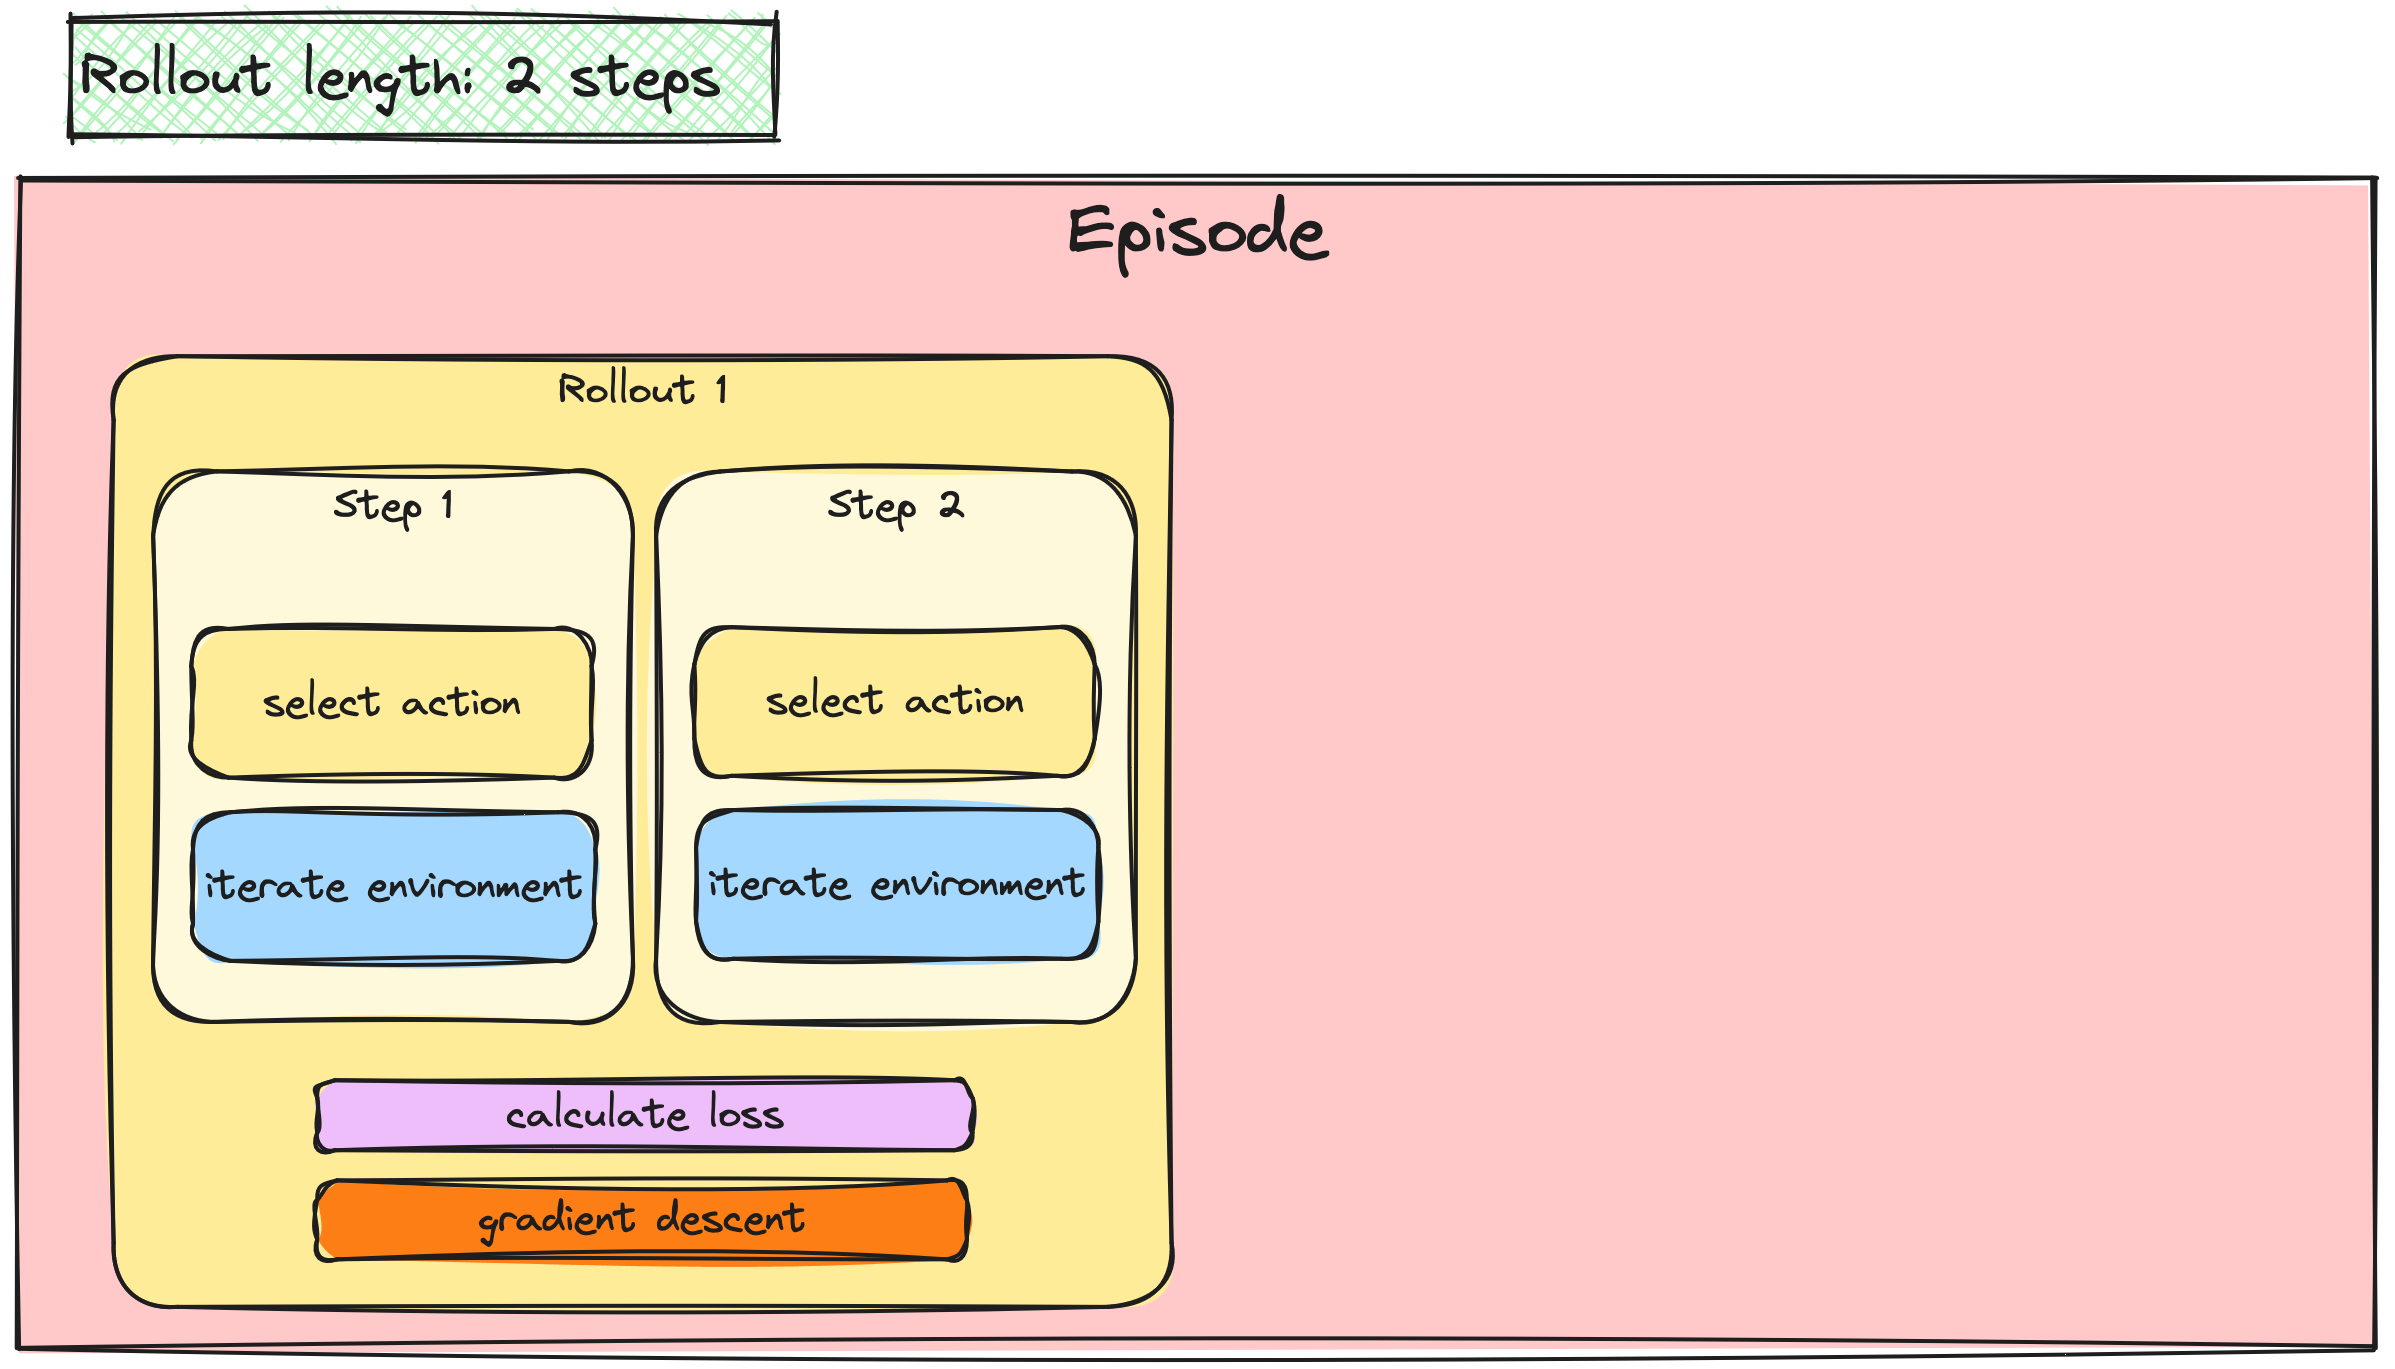
一个表示 episode 的大框。

Python 中的深度强化学习

逐步更新 vs 批量梯度更新

在大框中出现一个较小的"step 1"框;其中有一框写着"选择动作"。

Python 中的深度强化学习

逐步更新 vs 批量梯度更新

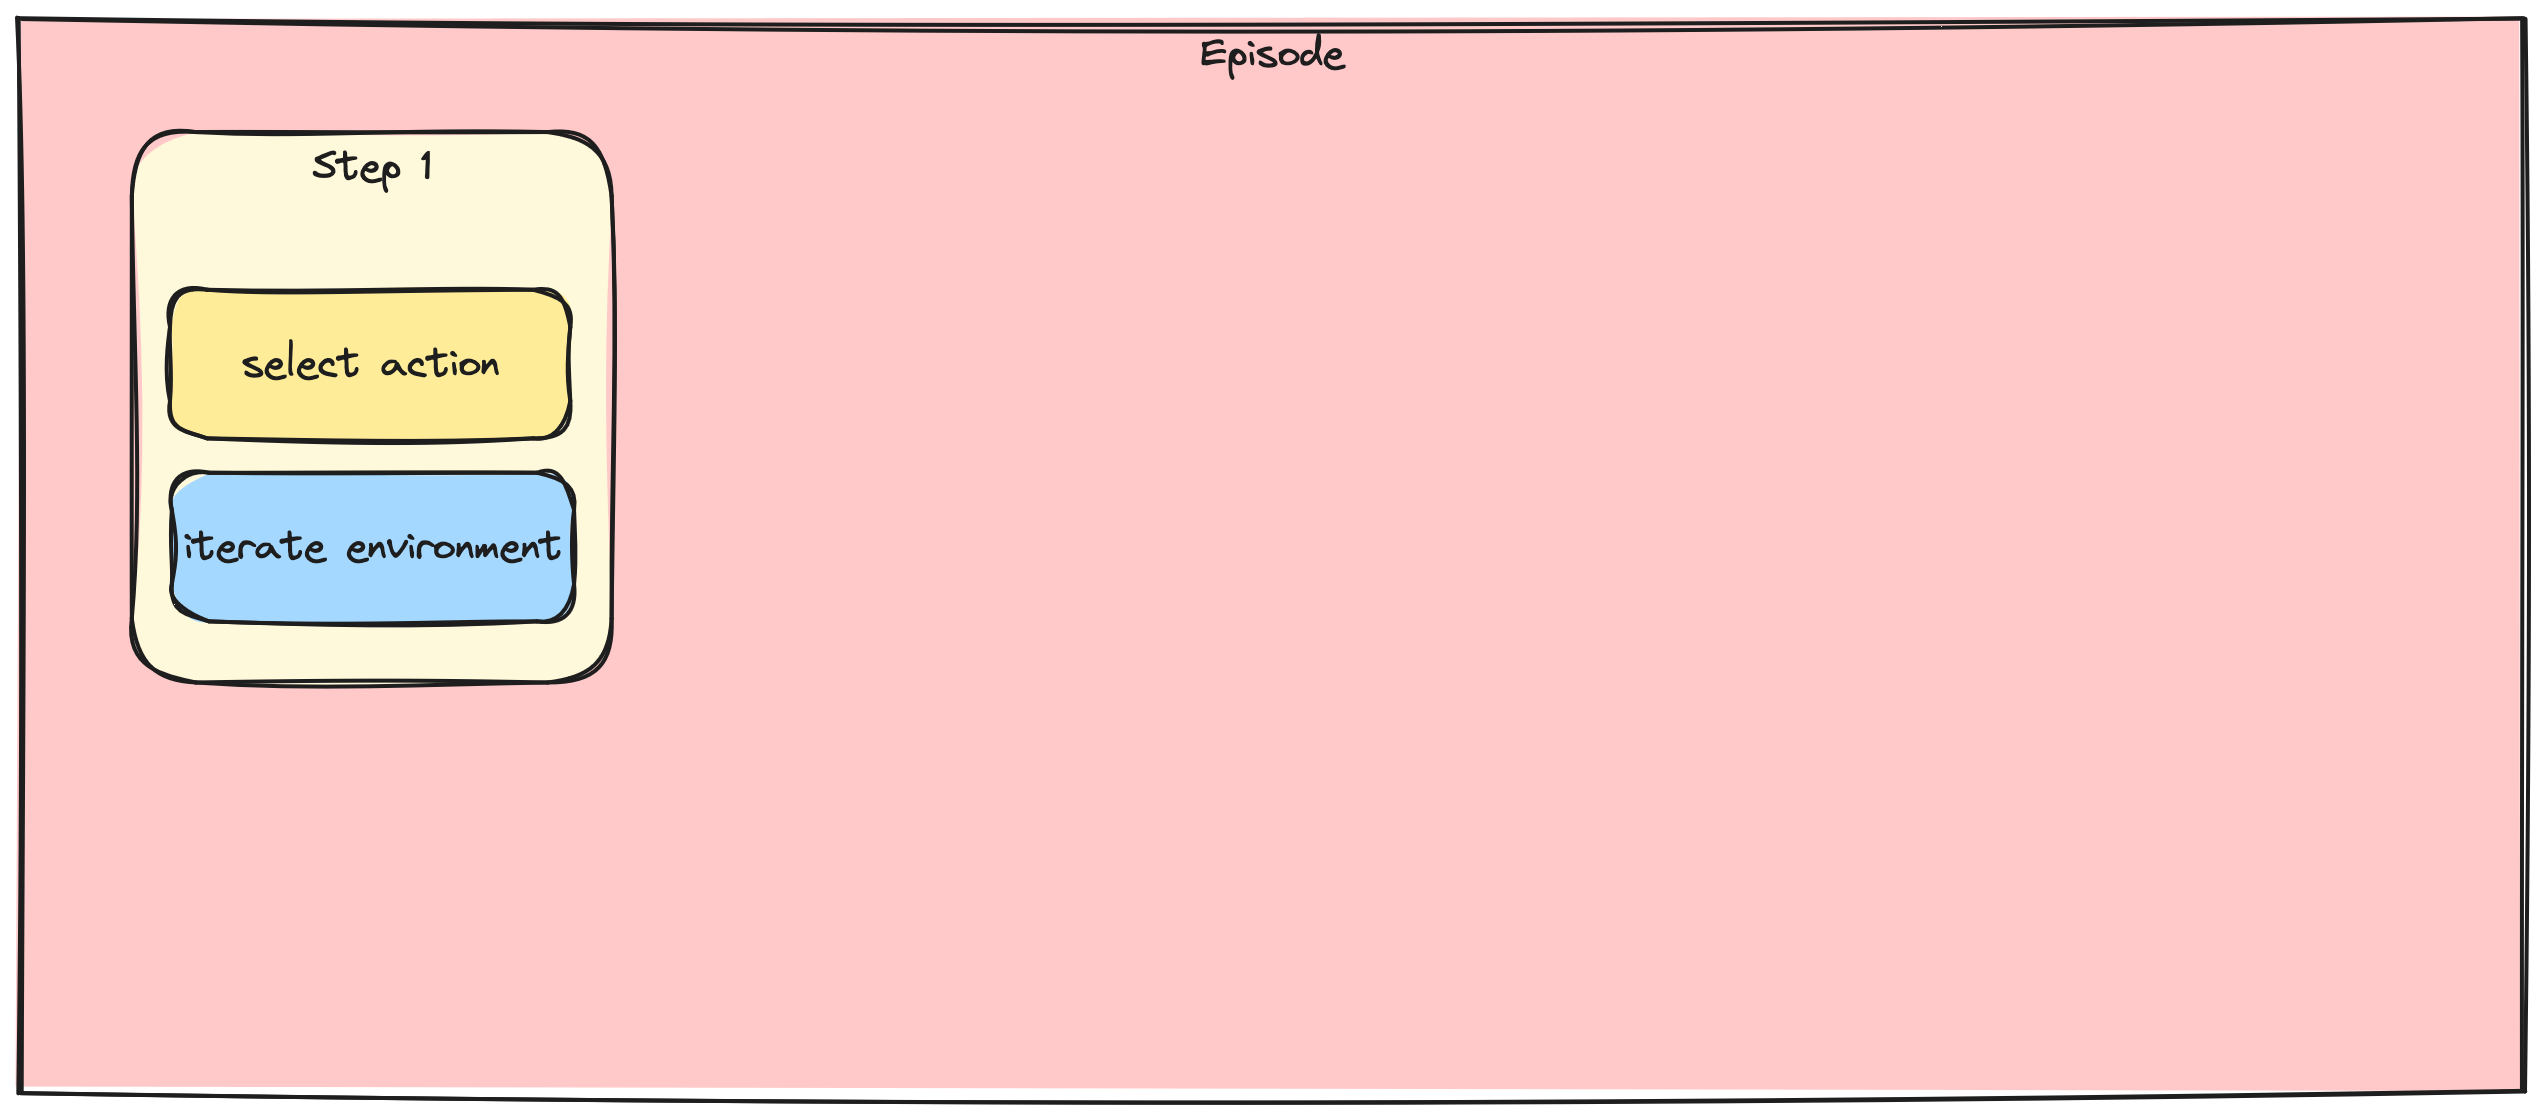
在 step 1 框内,又出现一个写着"环境迭代"的小框

Python 中的深度强化学习

逐步更新 vs 批量梯度更新

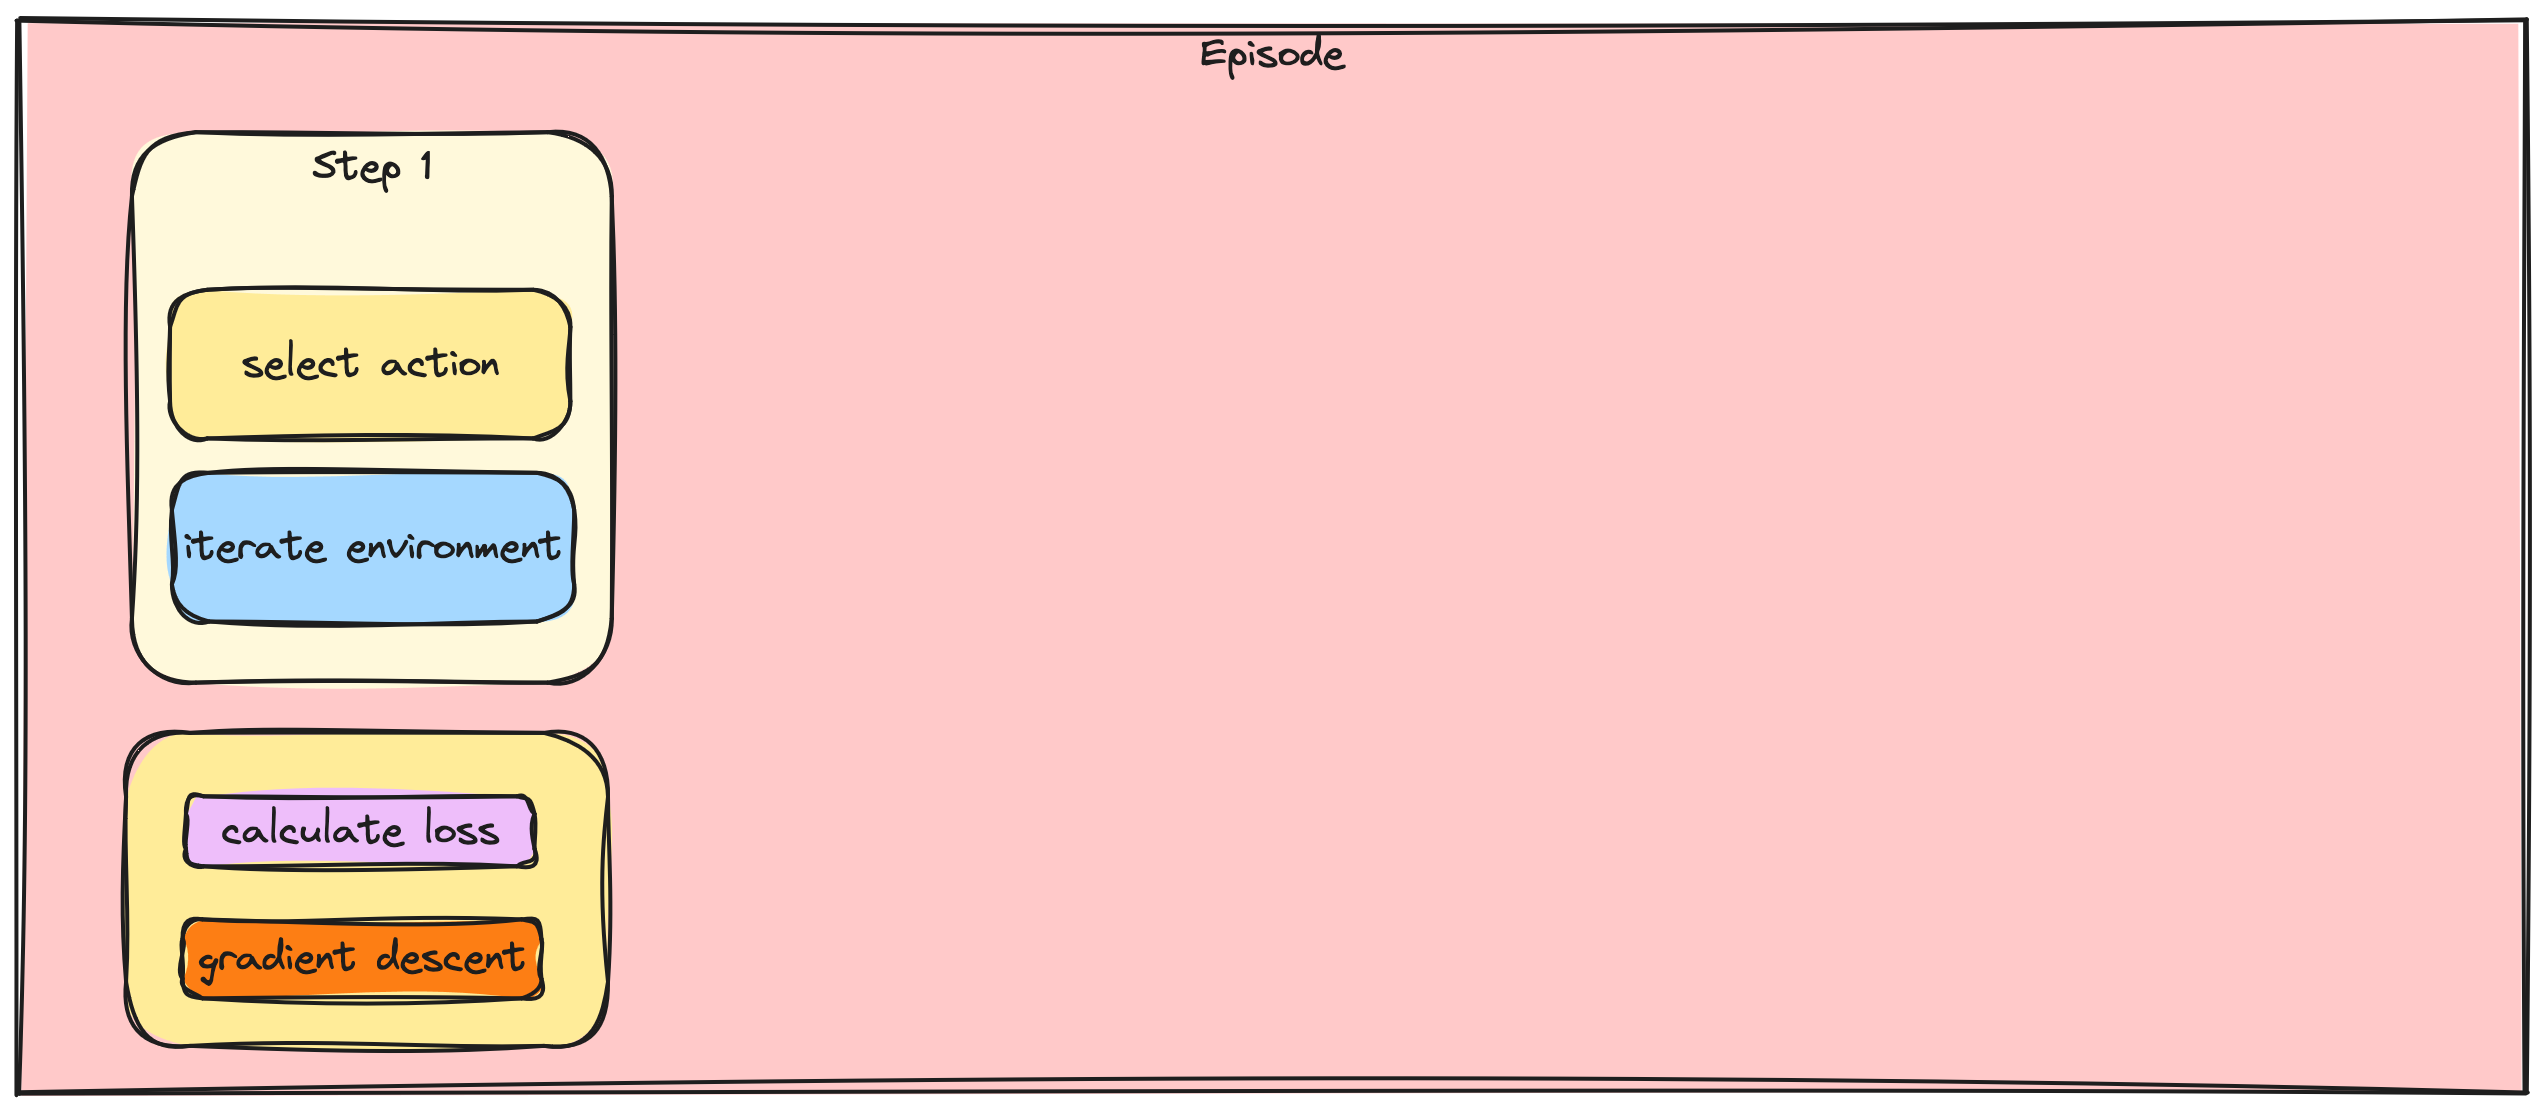
在 step 1 框下方出现"计算损失""梯度下降"框

Python 中的深度强化学习

逐步更新 vs 批量梯度更新

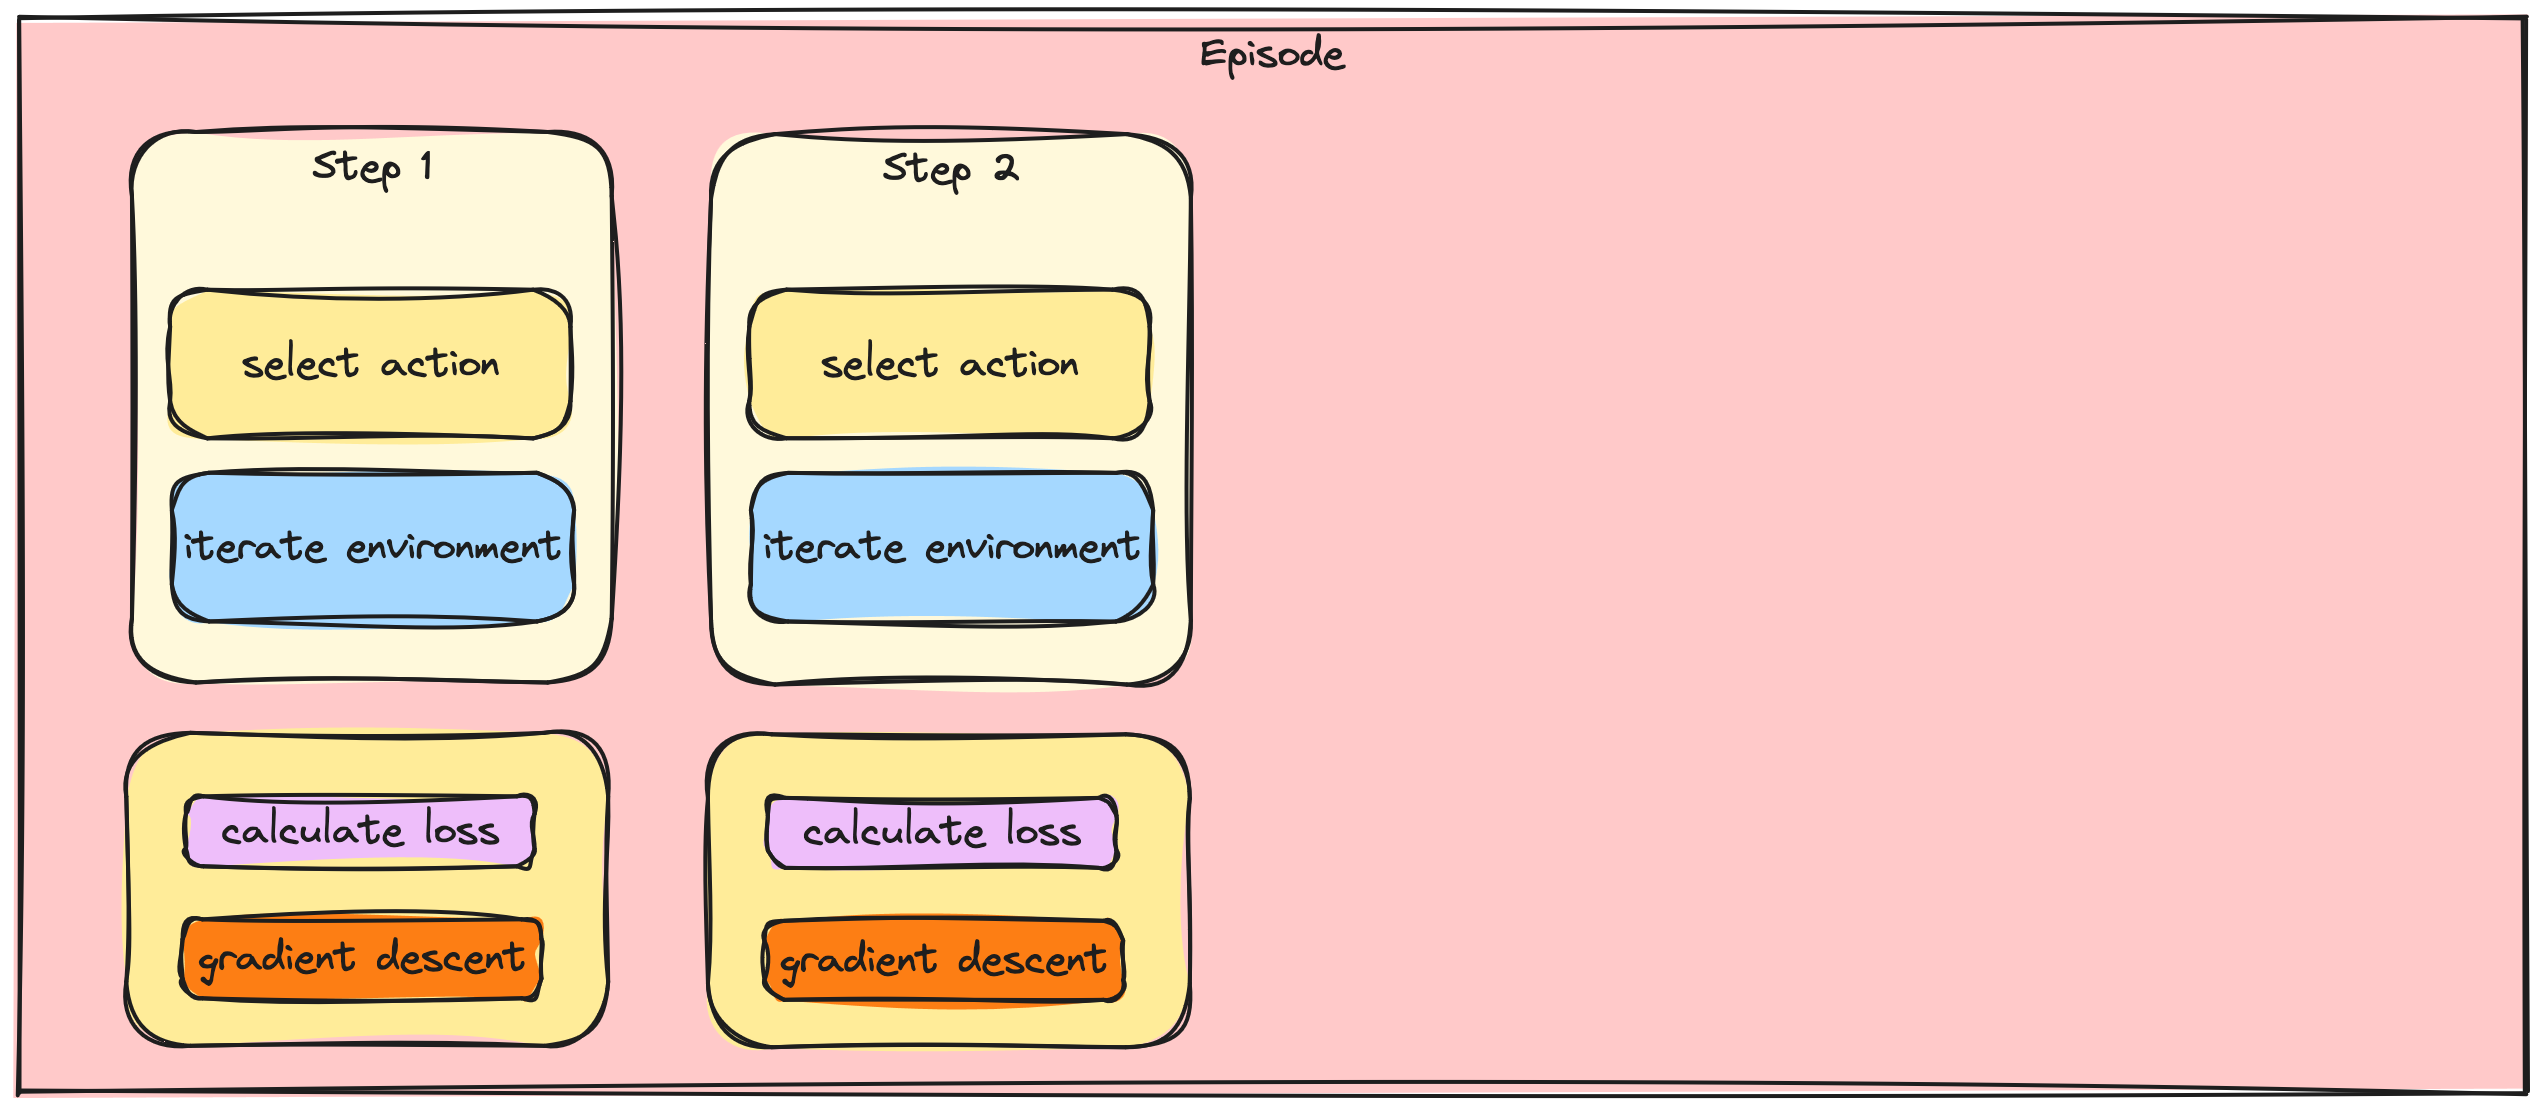
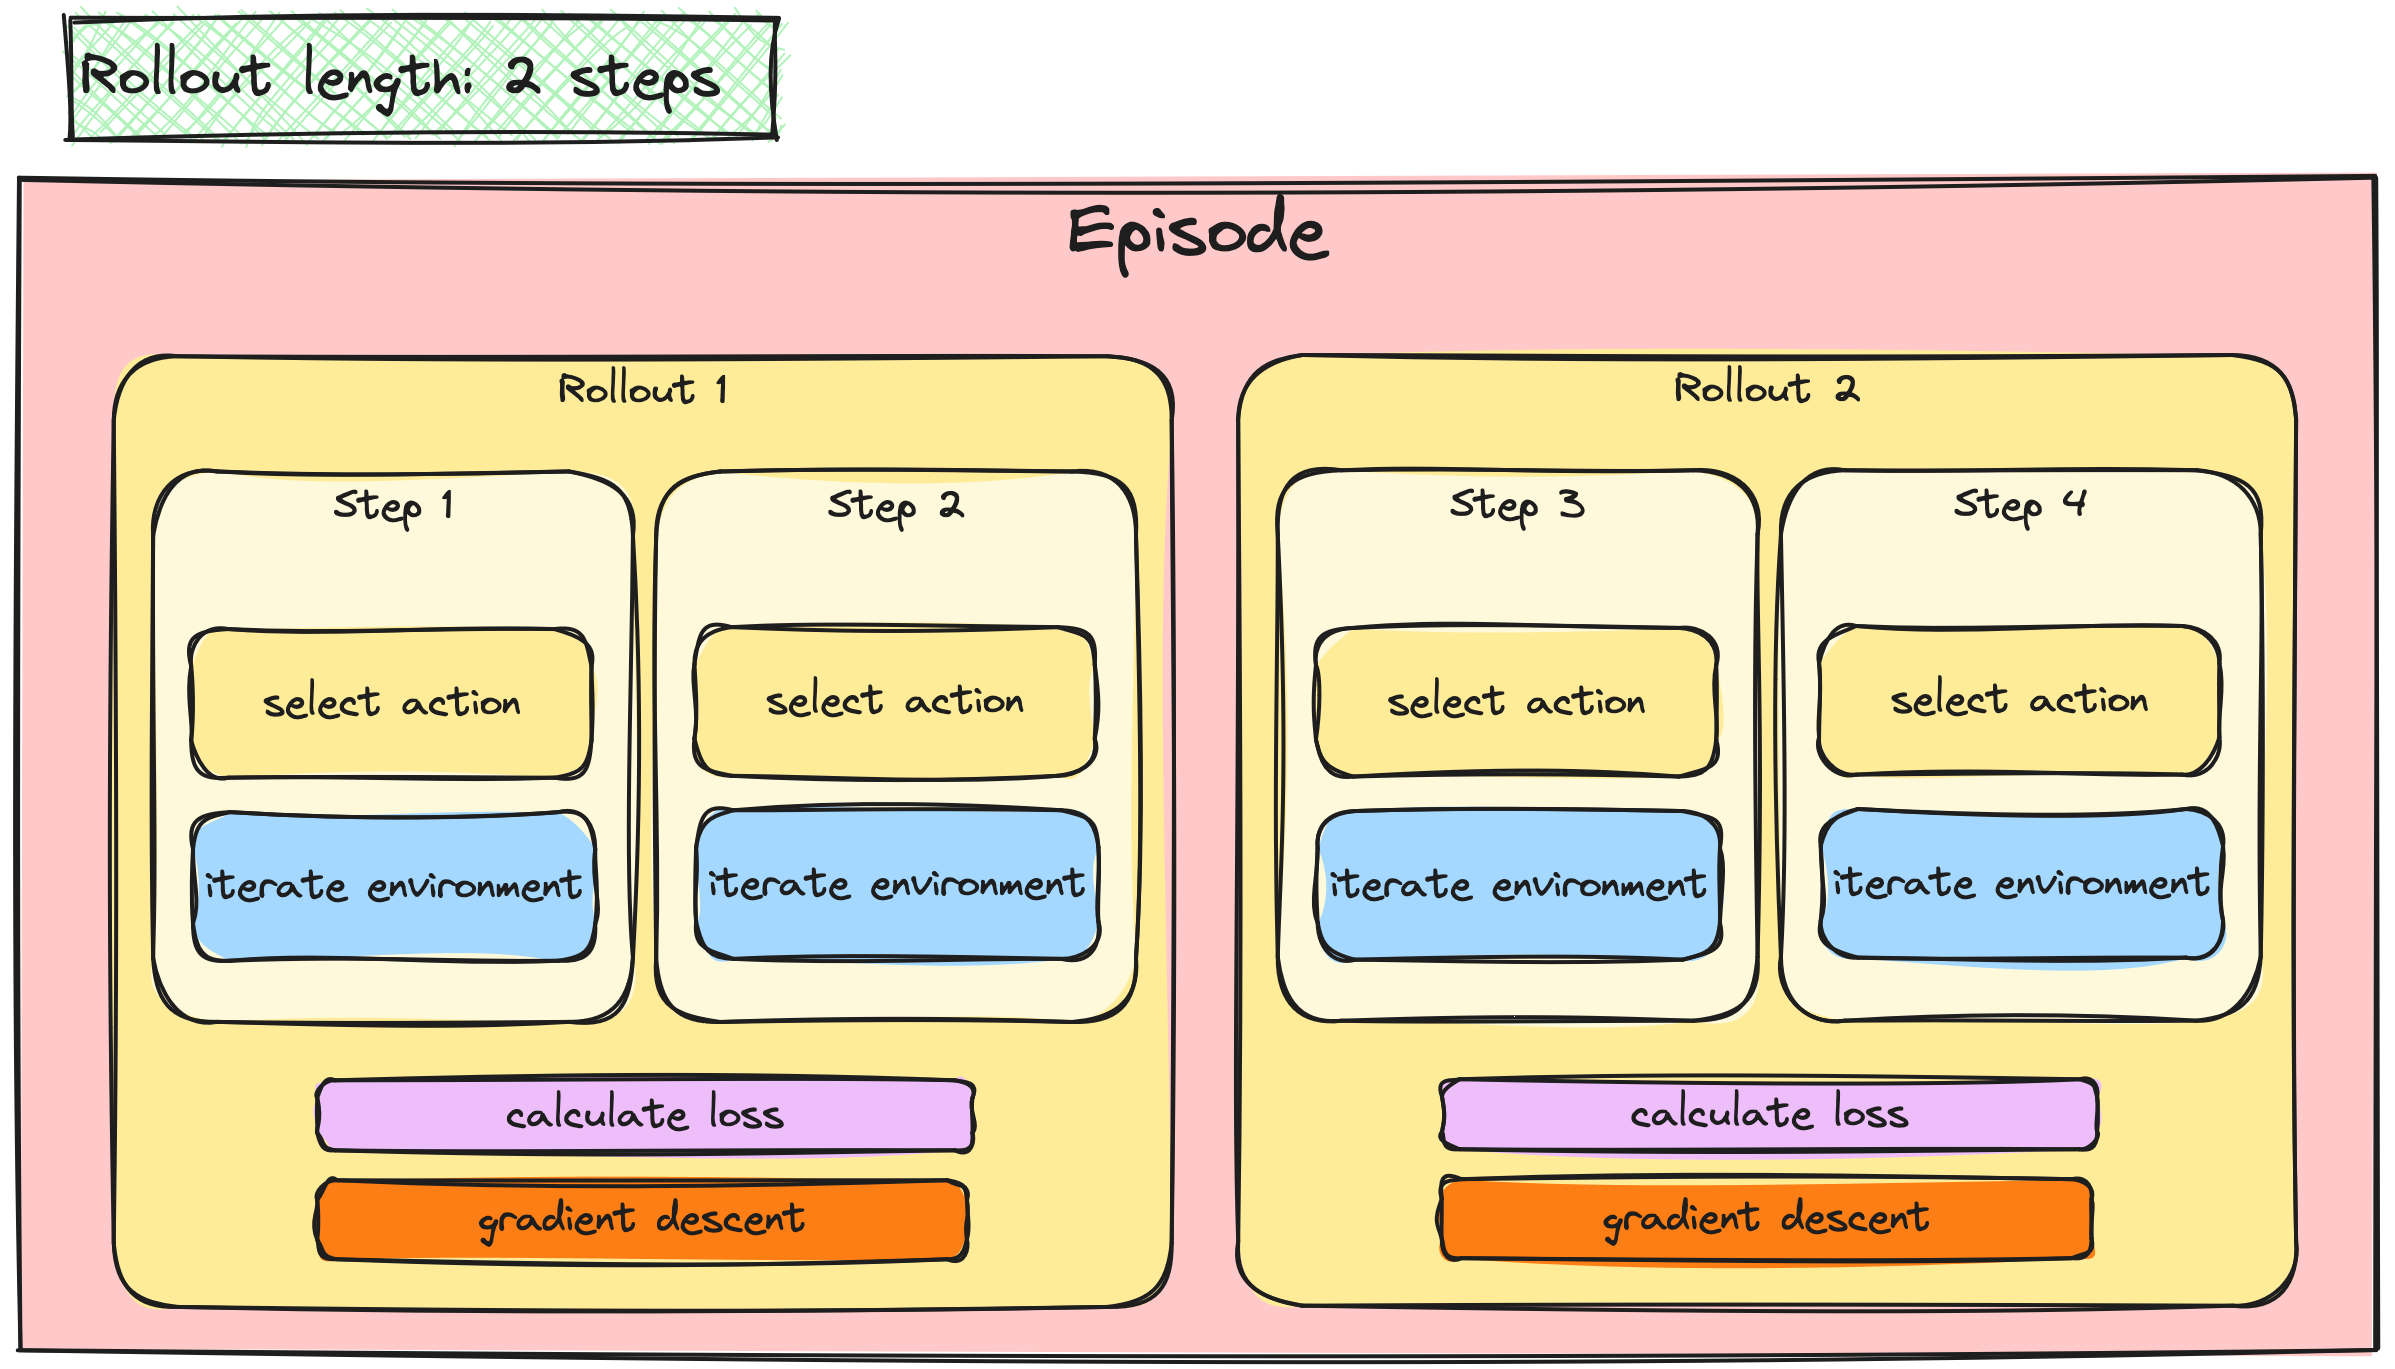
第二步出现一组相同的框,内容一致

Python 中的深度强化学习

逐步更新 vs 批量梯度更新

步骤 3 和步骤 4 也出现。

Python 中的深度强化学习

A2C / PPO 的批量更新

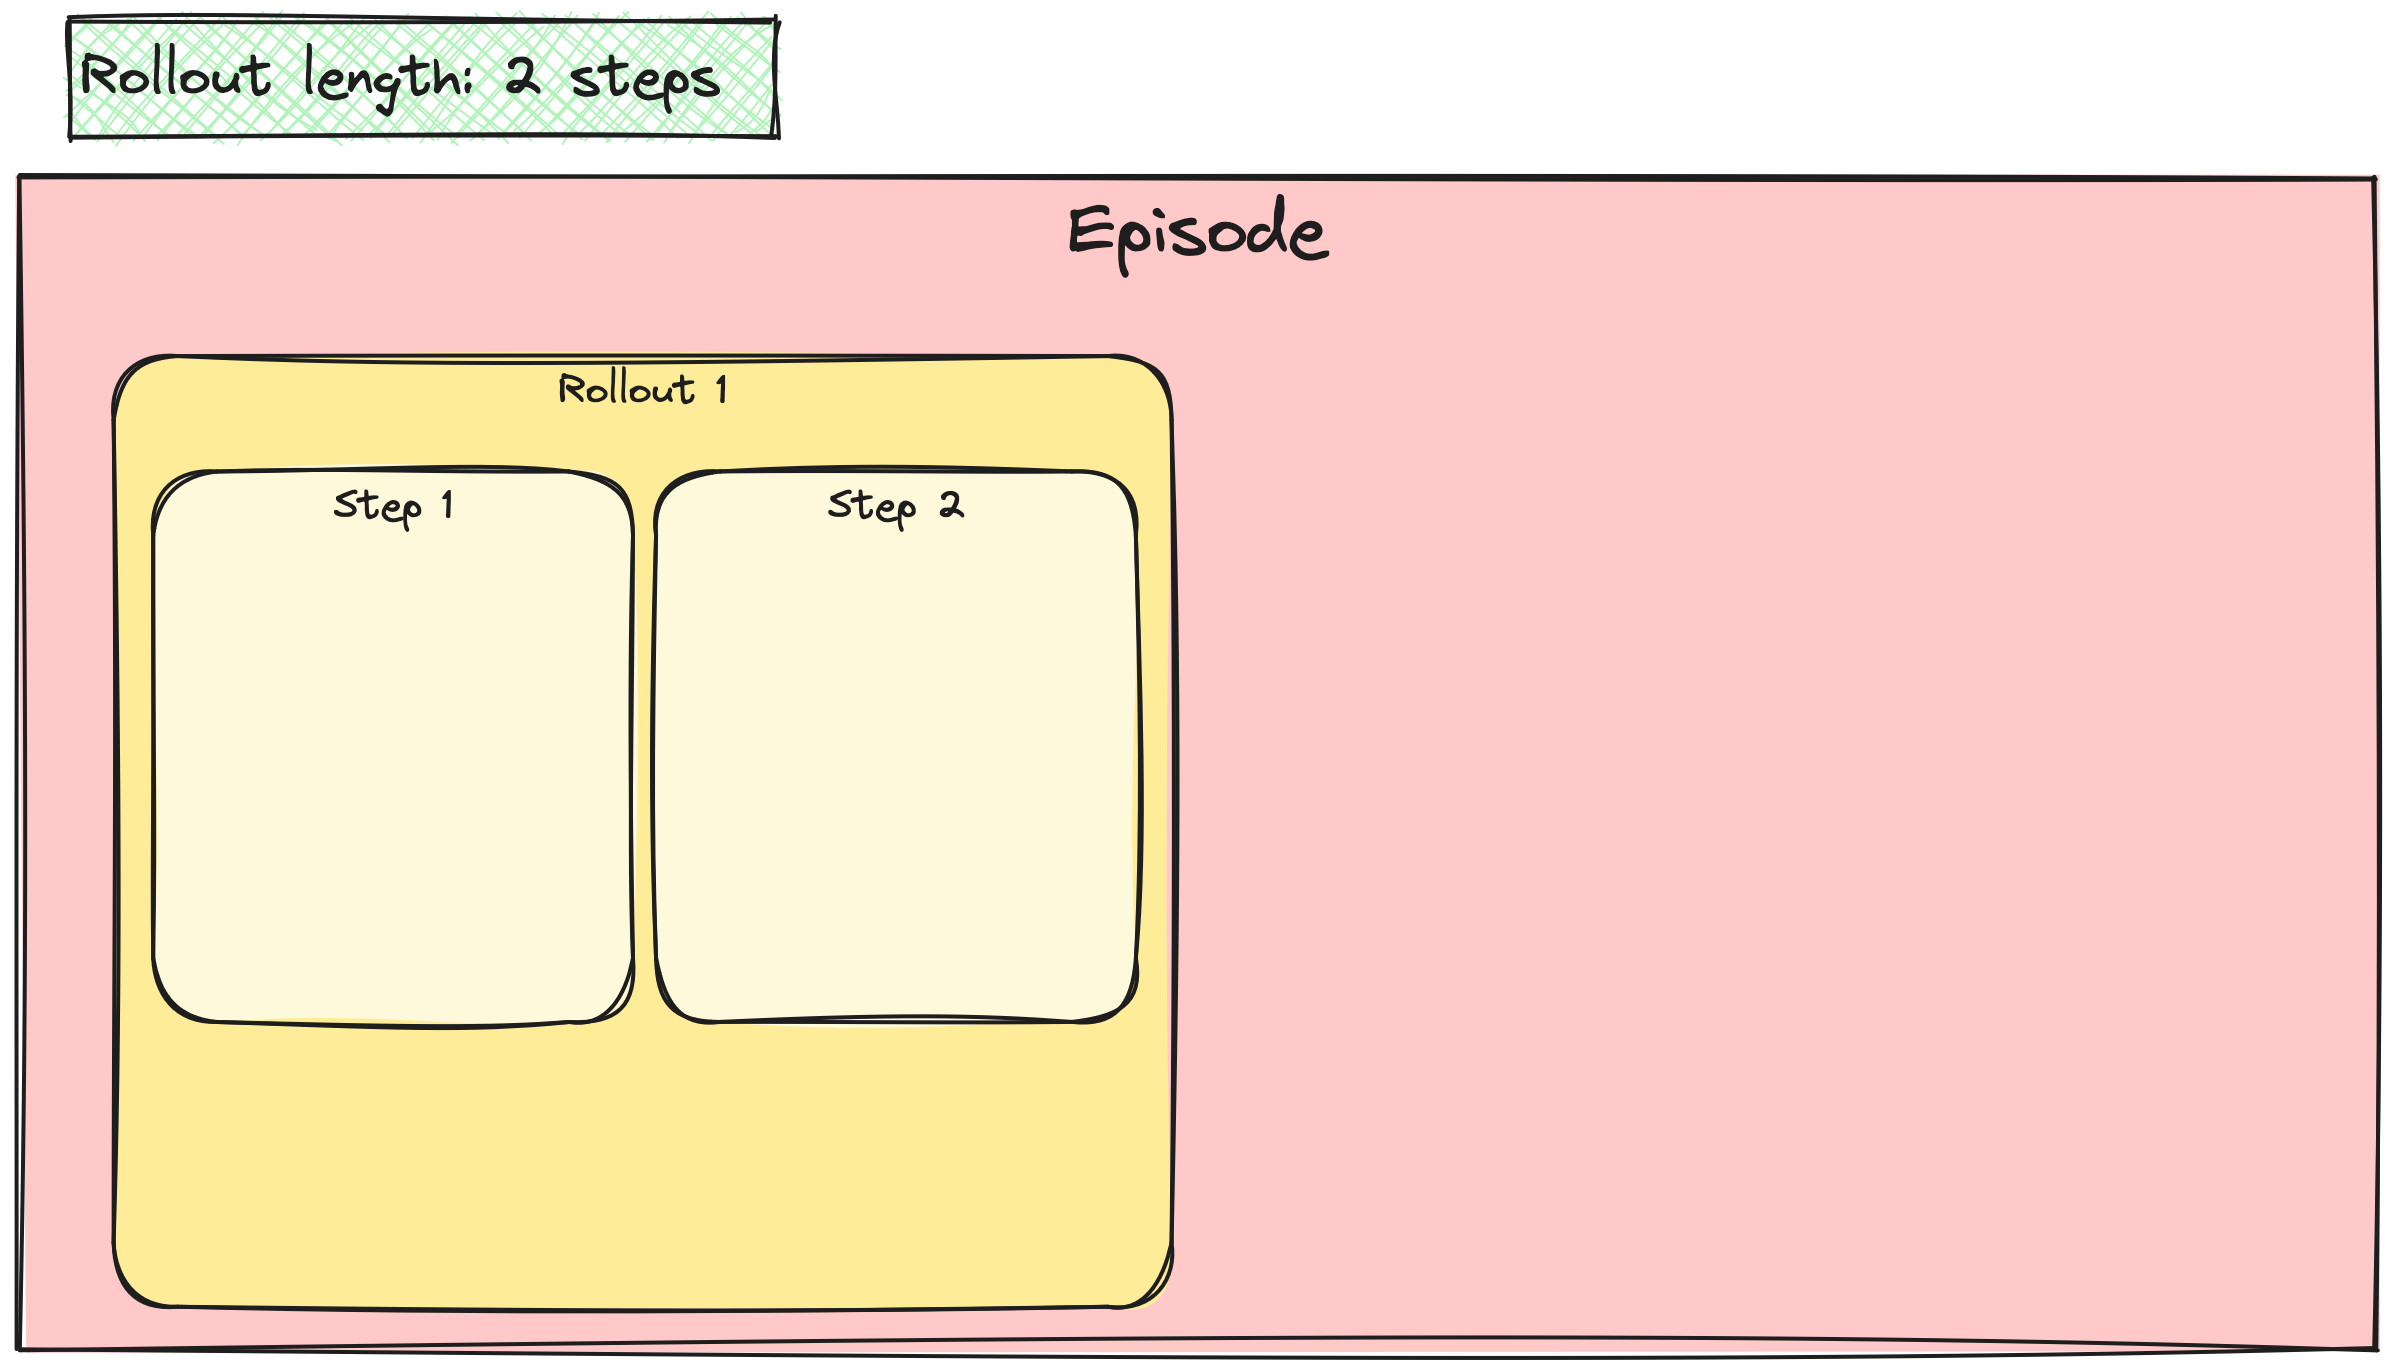
一个大的 episode 框;占其一半区域的是标记为"rollout 1"的框;其中有两个空框,标为"step 1"和"step 2"

Python 中的深度强化学习

A2C / PPO 的批量更新

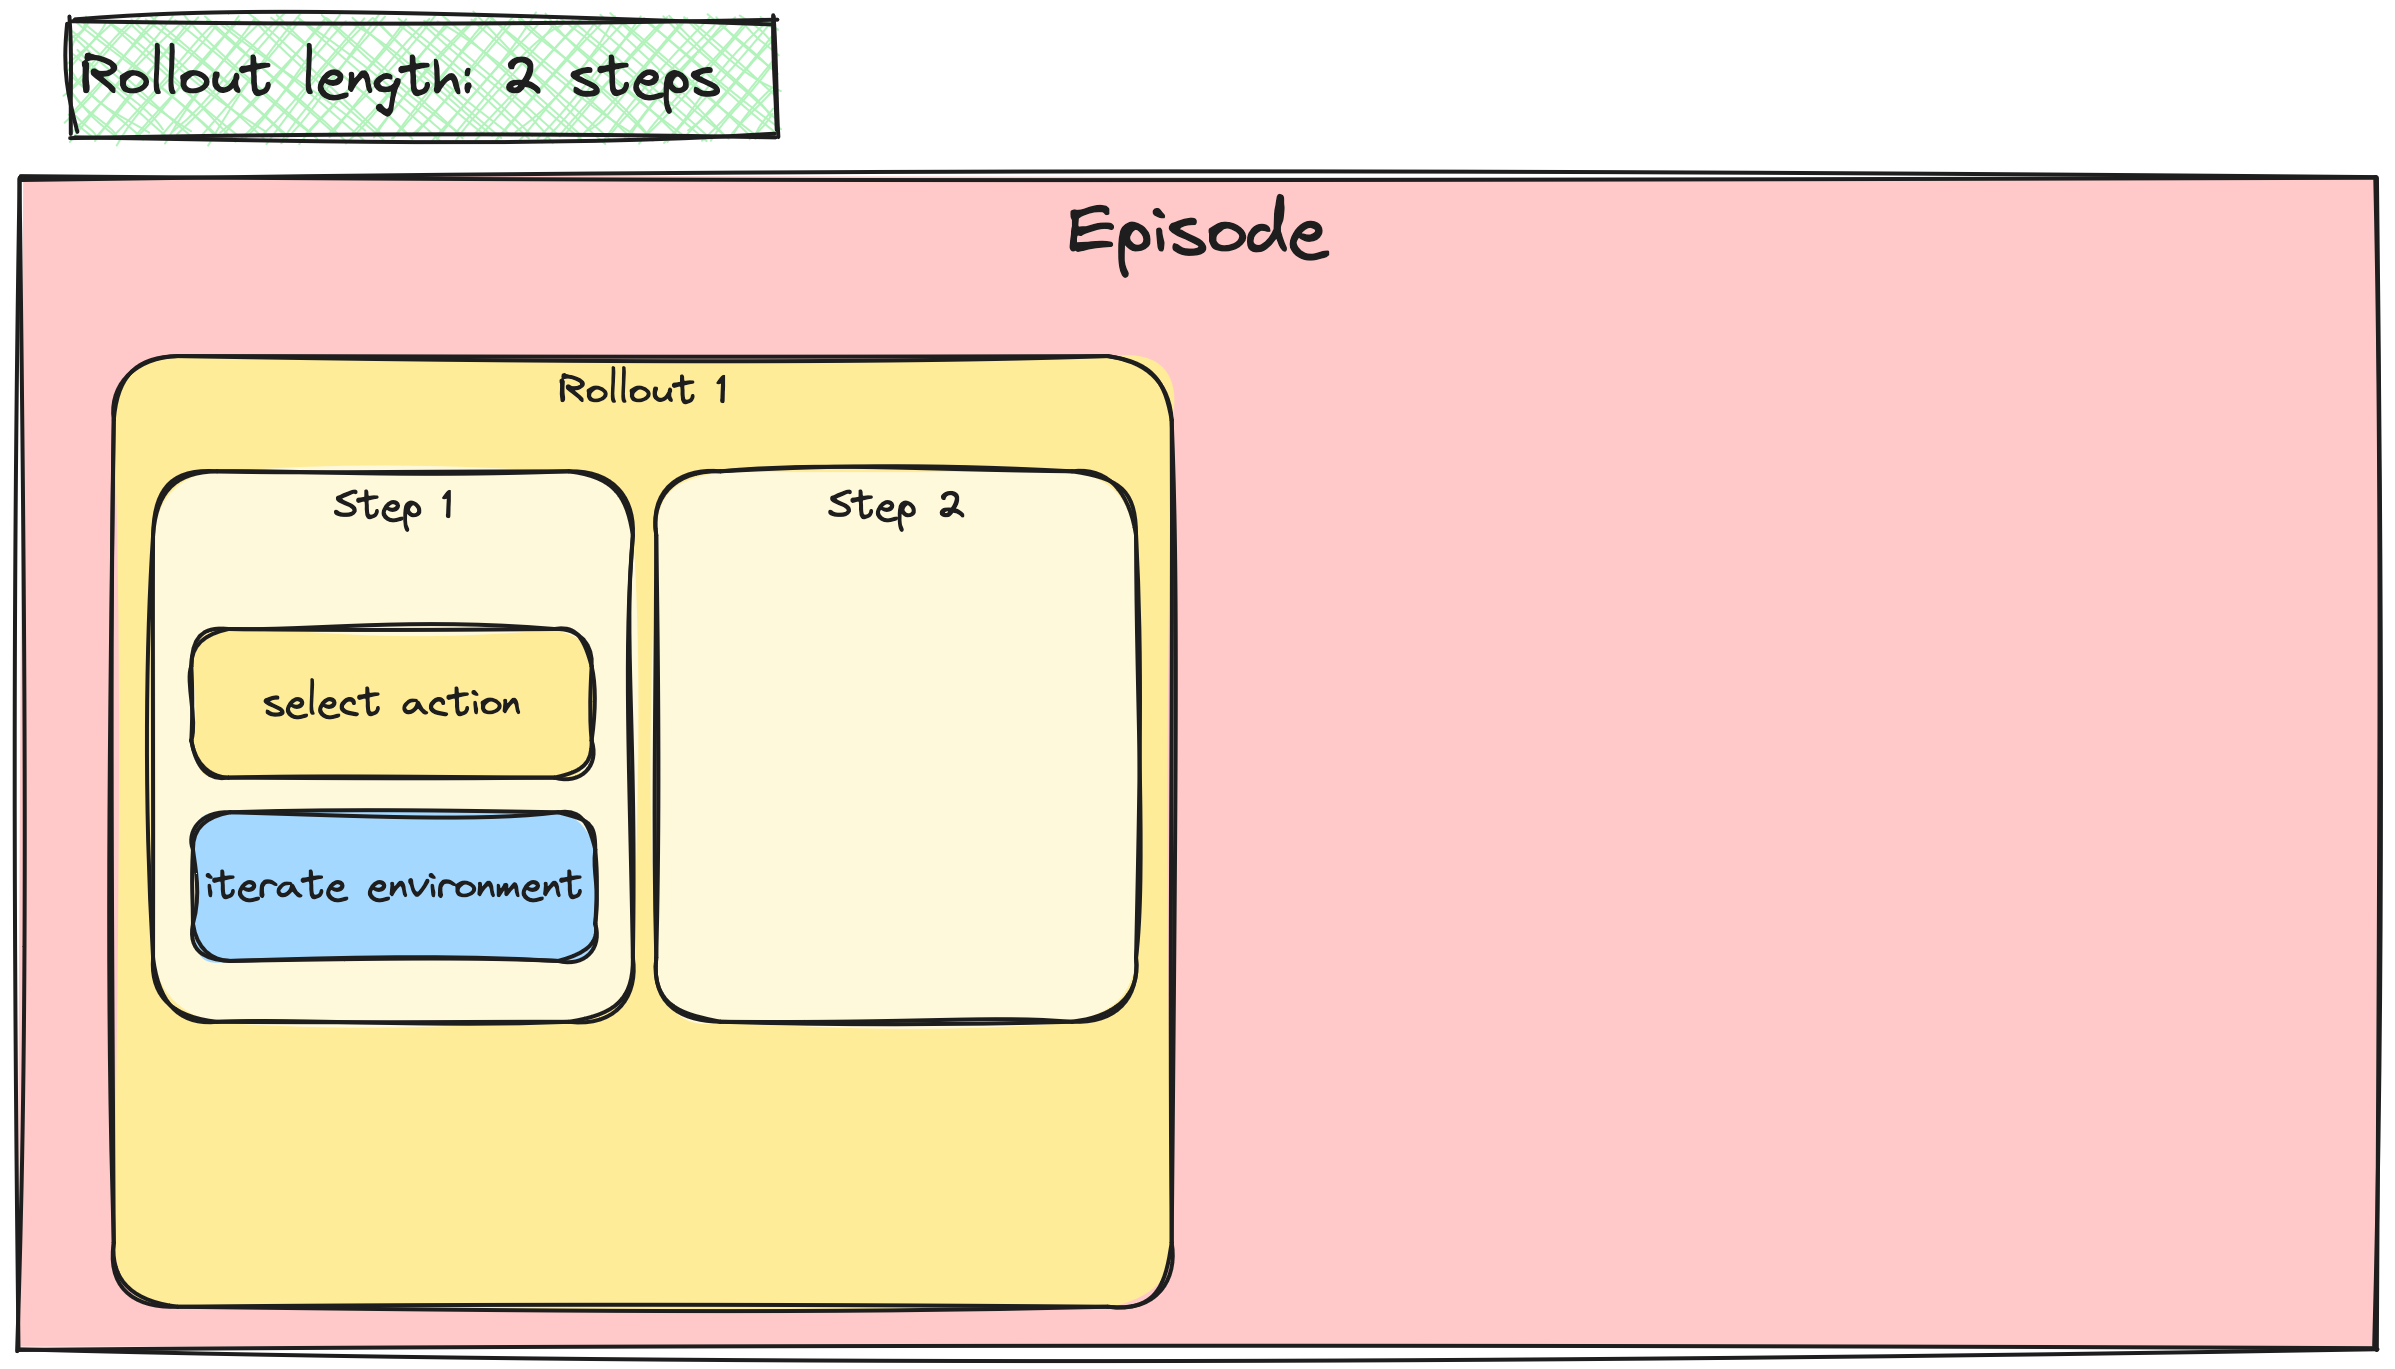
在 step 1 框内,出现"选择动作""环境迭代"标签。

Python 中的深度强化学习

A2C / PPO 的批量更新

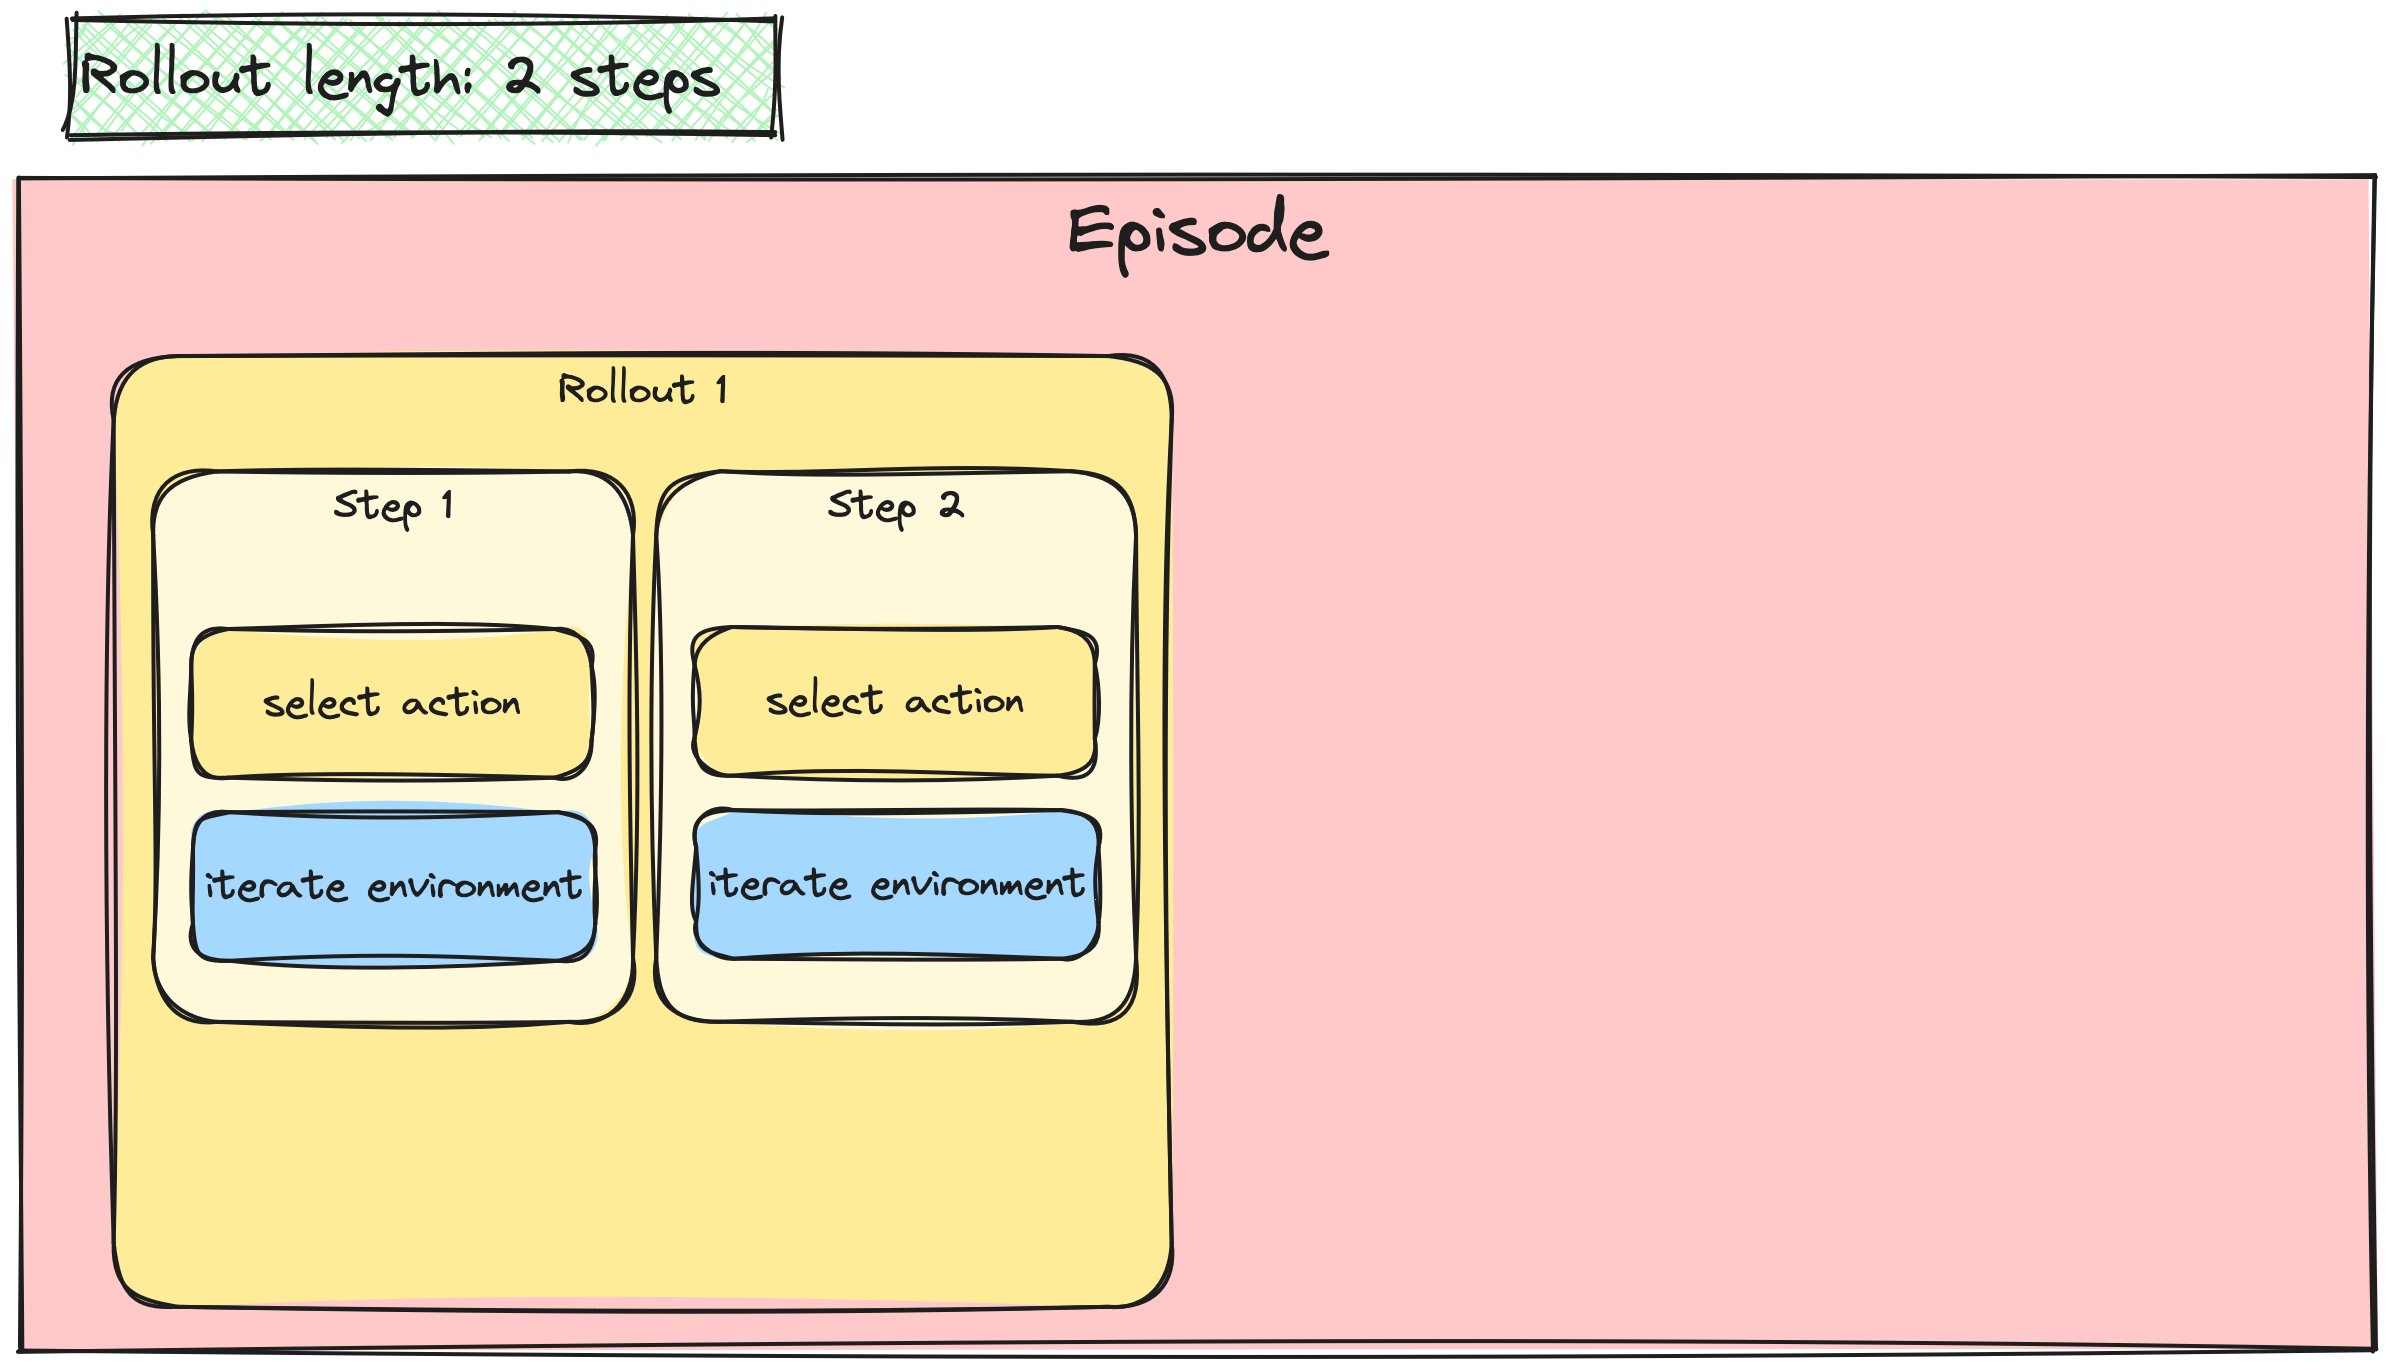
step 2 同样如此。

Python 中的深度强化学习

A2C / PPO 的批量更新

在 step 1 和 step 2 框下方,出现一个"计算损失"标签和一个"梯度下降"标签。

Python 中的深度强化学习

A2C / PPO 的批量更新

episode 剩余的一半区域被另一个相同、含两步的"rollout 2"框占据。

Python 中的深度强化学习

带批量更新的 A2C 训练循环


# Set rollout length
rollout_length = 10

# Initiate loss batches
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
  • 初始化损失批次
  • 像往常一样遍历 episode 与 step


for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob = select_action(actor, 
                                            state)                
    next_state, reward, terminated, truncated, _ = (
                                   env.step(action))
    done = terminated or truncated    
    actor_loss, critic_loss = calculate_losses(
        critic, action_log_prob, 
        reward, state, next_state, done)
    ...
Python 中的深度强化学习

带批量更新的 A2C 训练循环

  ...
  actor_losses = torch.cat((actor_losses, actor_loss))
  critic_losses = torch.cat((critic_losses, critic_loss))

# If rollout is full, update the networks if len(actor_losses) >= rollout_length:
actor_loss_batch = actor_losses.mean() critic_loss_batch = critic_losses.mean()
actor_optimizer.zero_grad() actor_loss_batch.backward() actor_optimizer.step() critic_optimizer.zero_grad() critic_loss_batch.backward() critic_optimizer.step()
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
state = next_state


  • 将每步损失追加到损失批次
  • 当 rollout 已满:
    • 用 .mean() 求批量平均损失
    • 执行梯度下降
    • 重新初始化损失批次
Python 中的深度强化学习

多智能体的 A2C / PPO


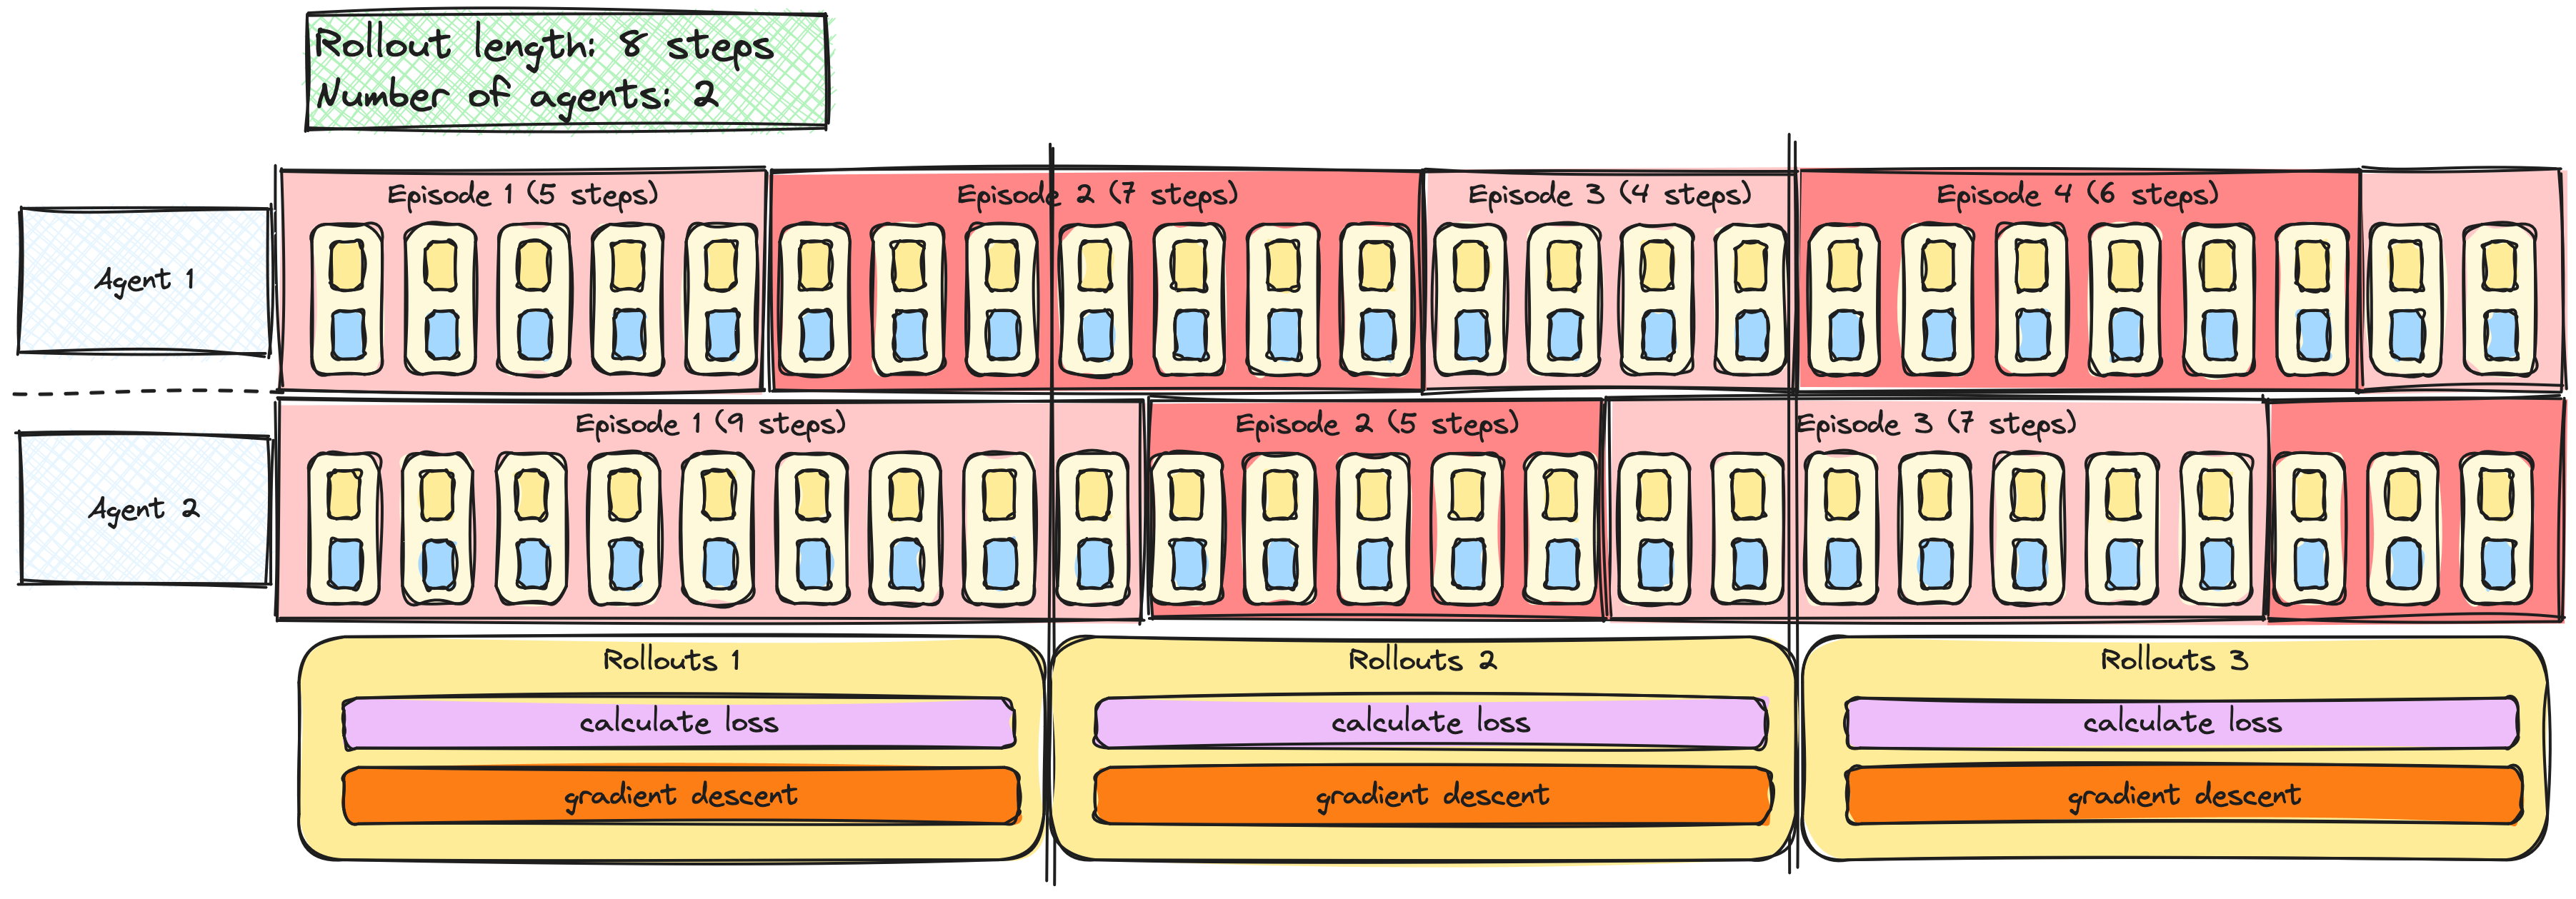
两条水平带表示智能体 1 和智能体 2。每个智能体分别经历 4 和 3 个长度不等的 episode。每个 episode 内有与前述相同的 step 框。两条带下方有三个 rollout 框,每个覆盖 8 个 step。每个 rollout 框内有"计算损失"和"梯度下降"标签。图顶端图例:"rollout 长度:8 步;智能体数:2"

Python 中的深度强化学习

Rollout 与小批量(minibatch)

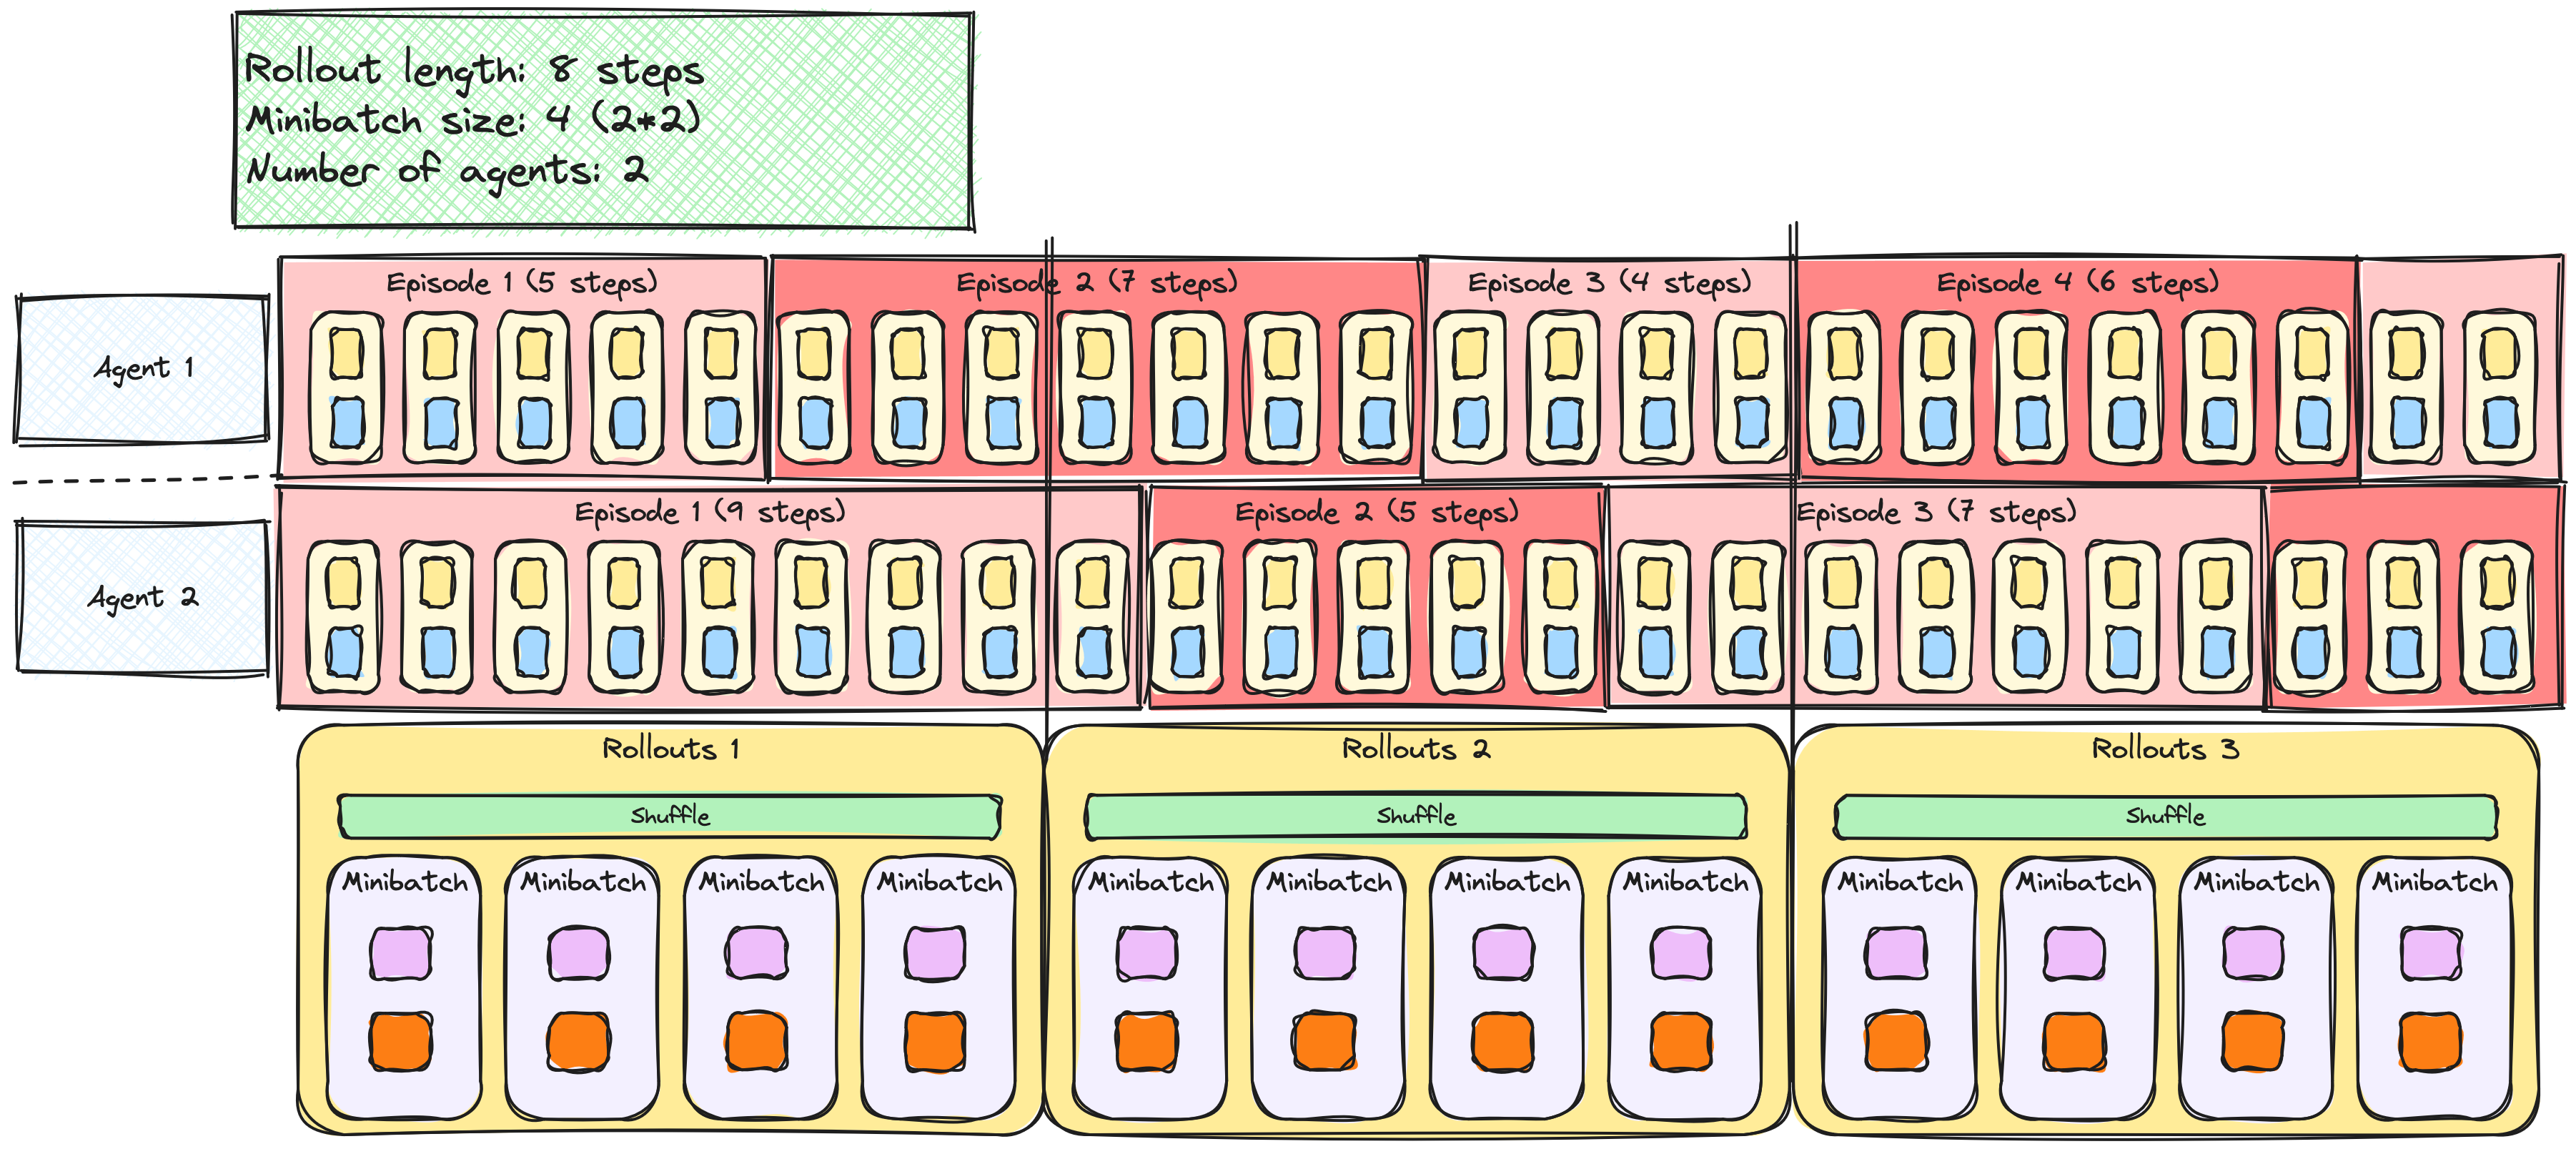
与上一页相同的两条智能体带。下方再次出现 3 个 rollout 框,但内容改变:顶部为"shuffle"长条;其下按长度分成 4 个"minibatch",各含"计算损失""梯度下降"。顶部图例:"Rollout 长度:8 步;minibatch 大小:4(2x2);智能体数:2"

Python 中的深度强化学习

含多轮次(epoch)的 PPO

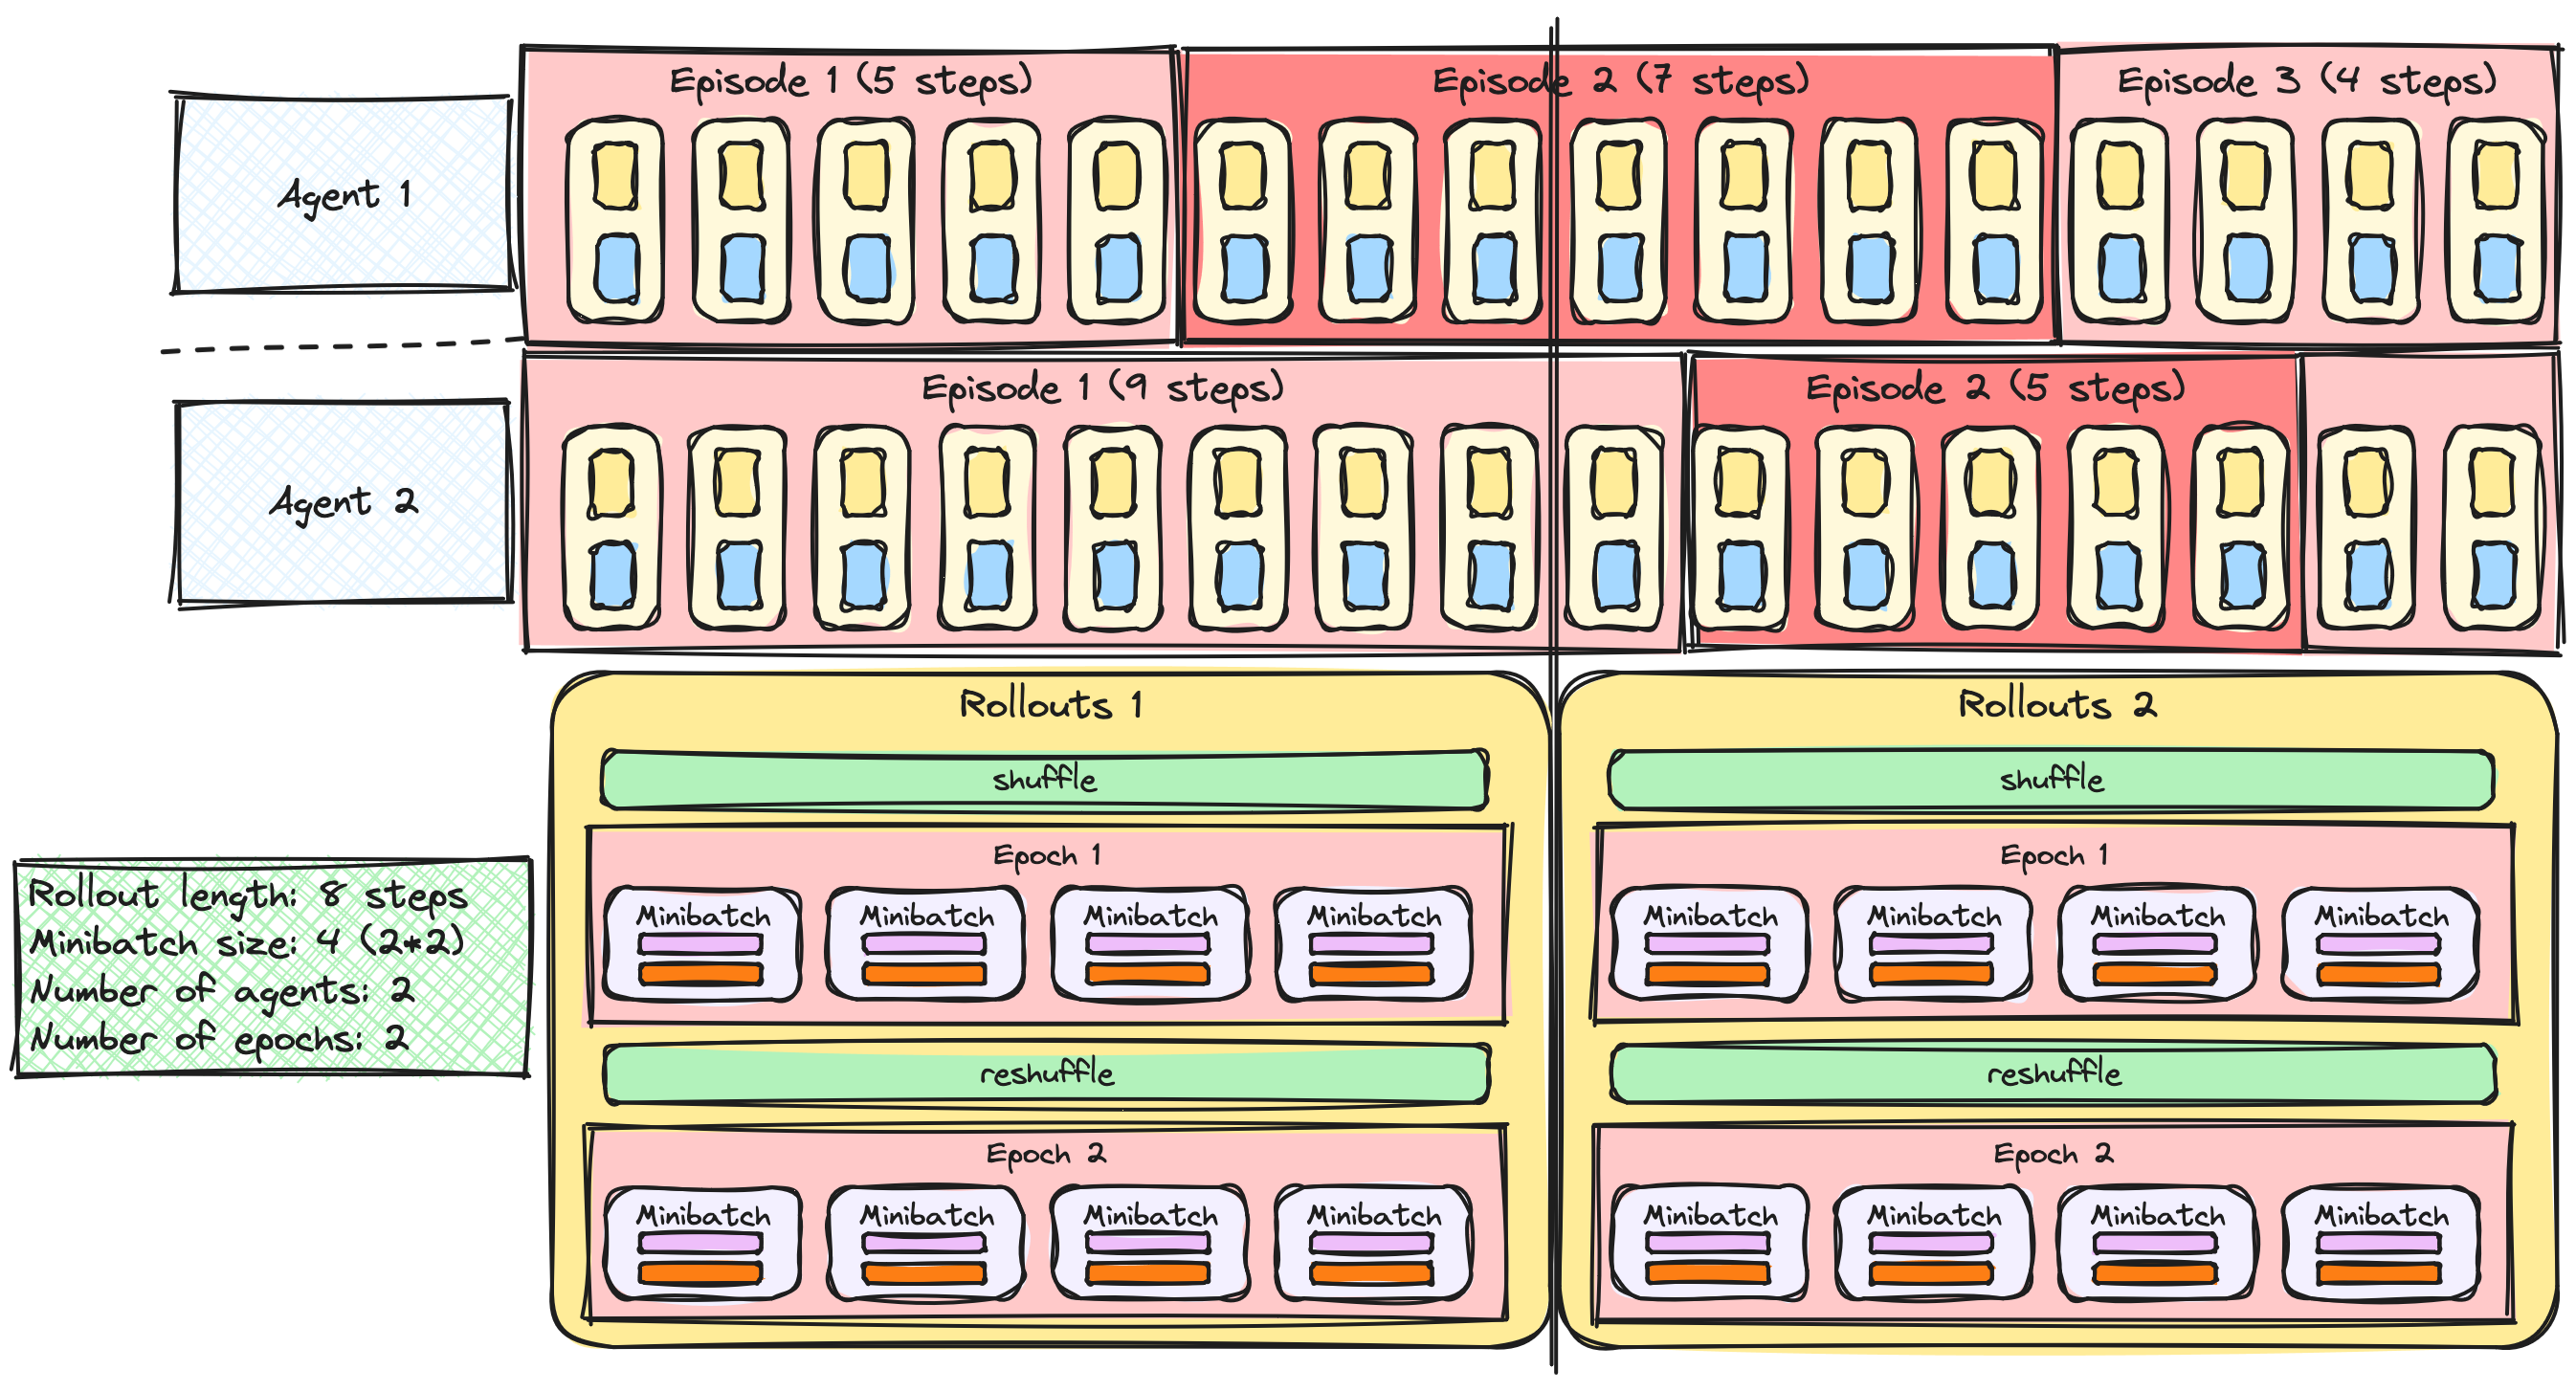
与前图相似,但 rollout 批次也垂直分为 4 区:顶部为"shuffle";第二部分为"大框'epoch 1'",内有 4 个按长度排列的 minibatch;第三部分为"reshuffle";最后为"大框'epoch 2'",同样含 4 个 minibatch。图例:"Rollout 长度:8 步;minibatch 大小:4(2x2);智能体数:2;epoch 数:2"。

Python 中的深度强化学习

Passons à la pratique !

Python 中的深度强化学习

Preparing Video For Download...