策略梯度简介

Python 中的深度强化学习

Timothée Carayol

Principal Machine Learning Engineer, Komment

DRL 中的策略方法简介


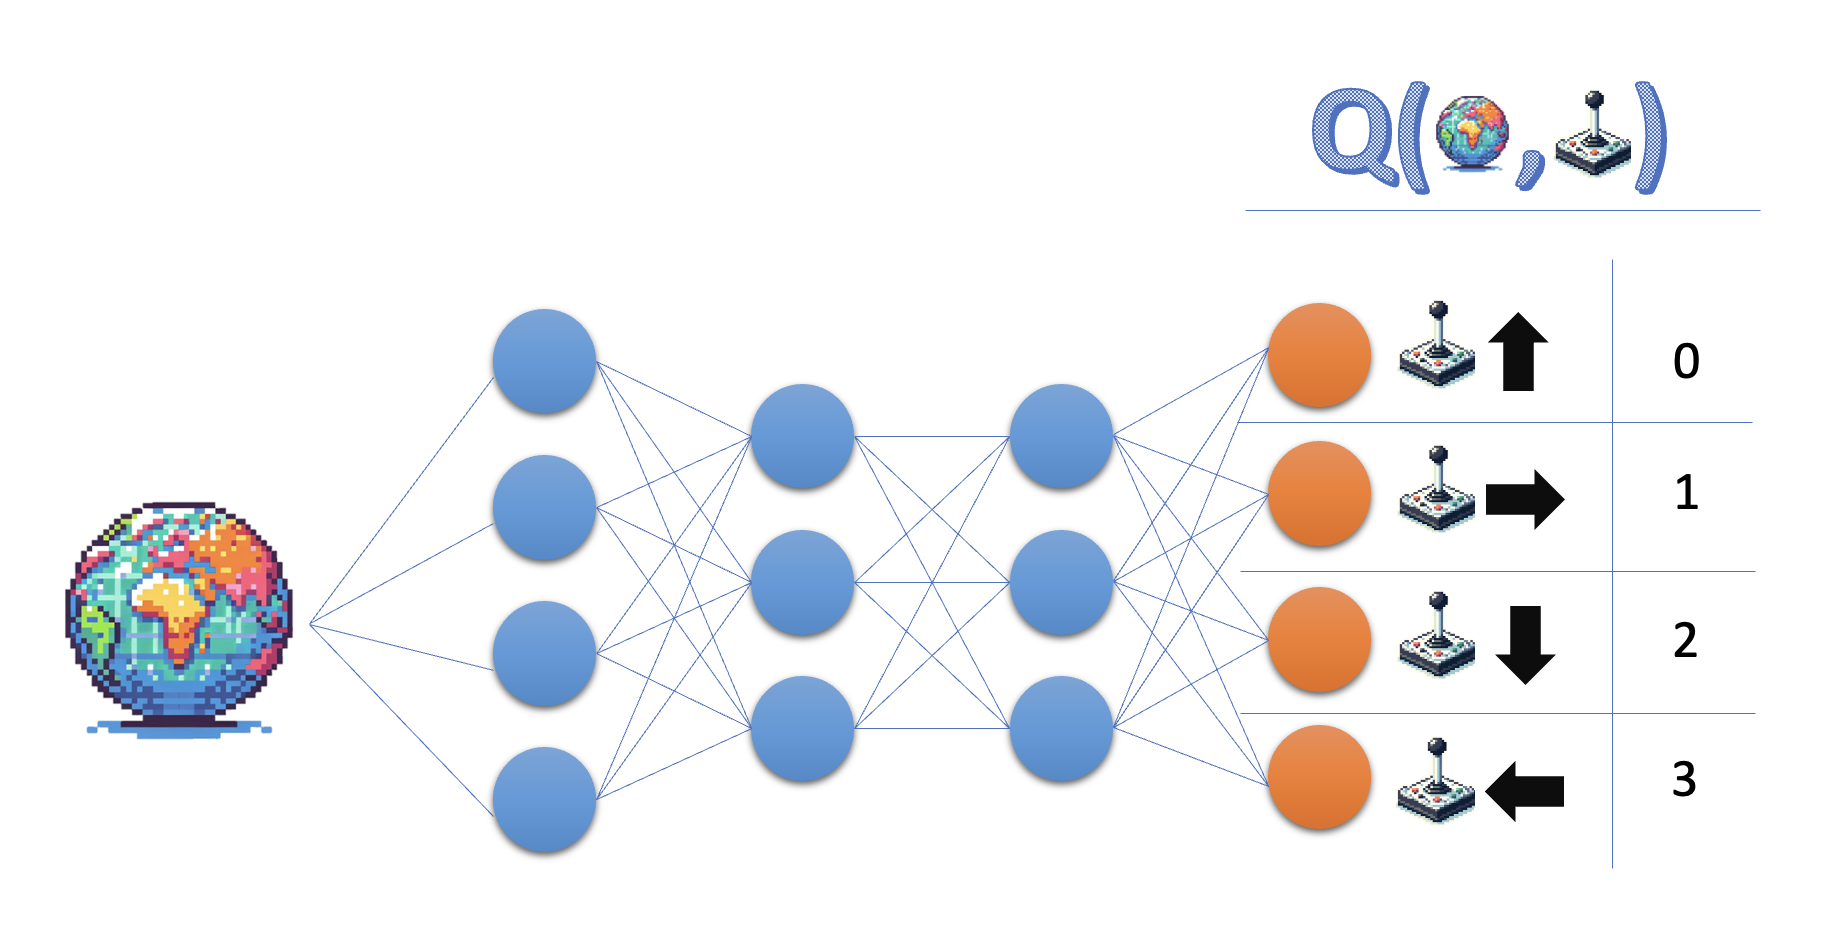
Q-learning:

  • 学习动作价值函数 Q

一个 Q 网络,输入为状态,输出为各动作的价值

  • 策略:选择价值最高的动作


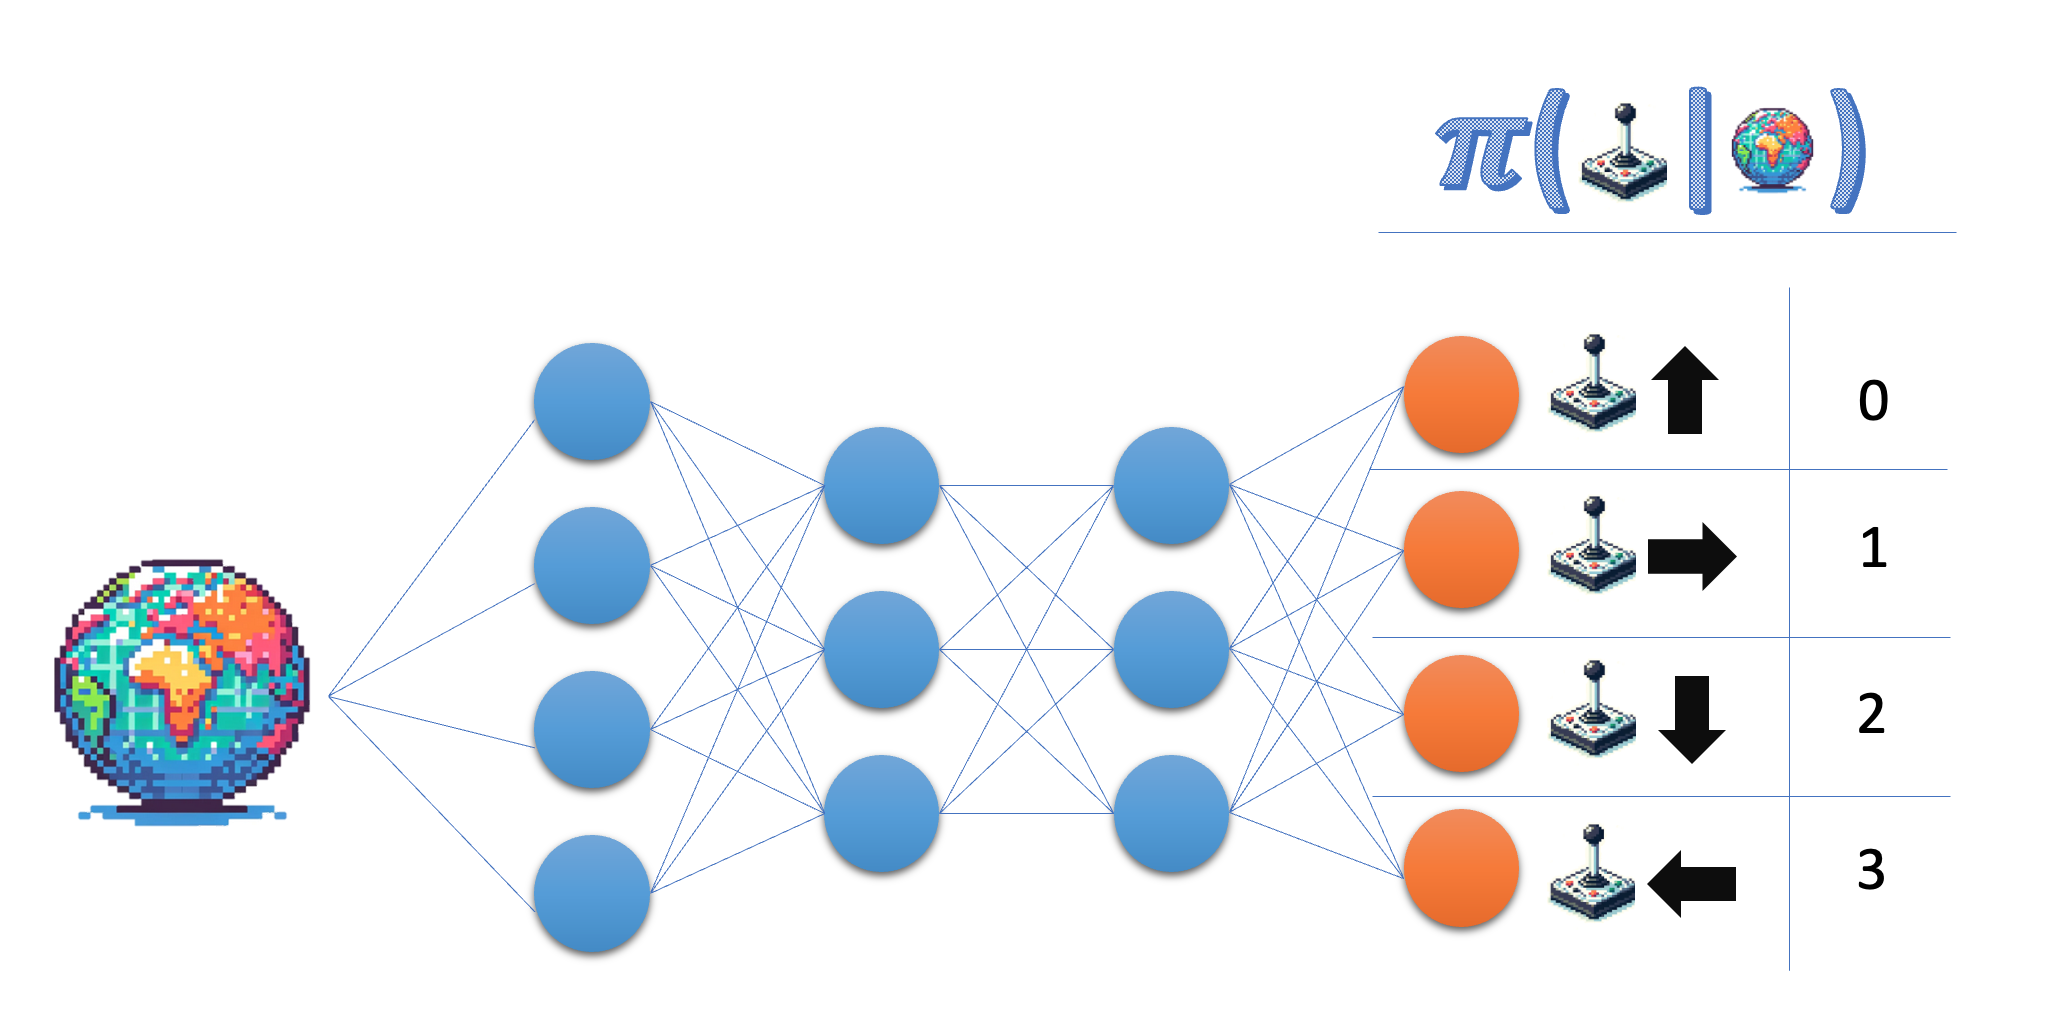
策略学习:

  • 直接学习策略

一个策略网络,输入为状态,输出为各动作的概率

Python 中的深度强化学习

策略学习


  • 可为随机策略
  • 处理连续空间
  • 直接优化目标
  • 方差高
  • 样本效率较低


  • 在 Deep-Q 学习中:策略是确定性的


$\pi_\theta(a_t | s_t)$:

  • 在状态 $s_t$ 下对 $a_t$ 的概率分布,含:
    • $a_t$、$s_t$:第 $t$ 步的动作与状态
    • $\theta$:策略参数(网络权重)
Python 中的深度强化学习

策略网络(离散动作)

class PolicyNetwork(nn.Module):
  def __init__(self, state_size, action_size):
    super(PolicyNetwork, self).__init__()
    self.fc1 = nn.Linear(state_size, 64)
    self.fc2 = nn.Linear(64, 64)
    self.fc3 = nn.Linear(64, action_size)

  def forward(self, state):
    x = torch.relu(self.fc1(torch.tensor(state)))
    x = torch.relu(self.fc2(x))
    action_probs = torch.softmax(self.fc3(x), dim=-1)
    return action_probs

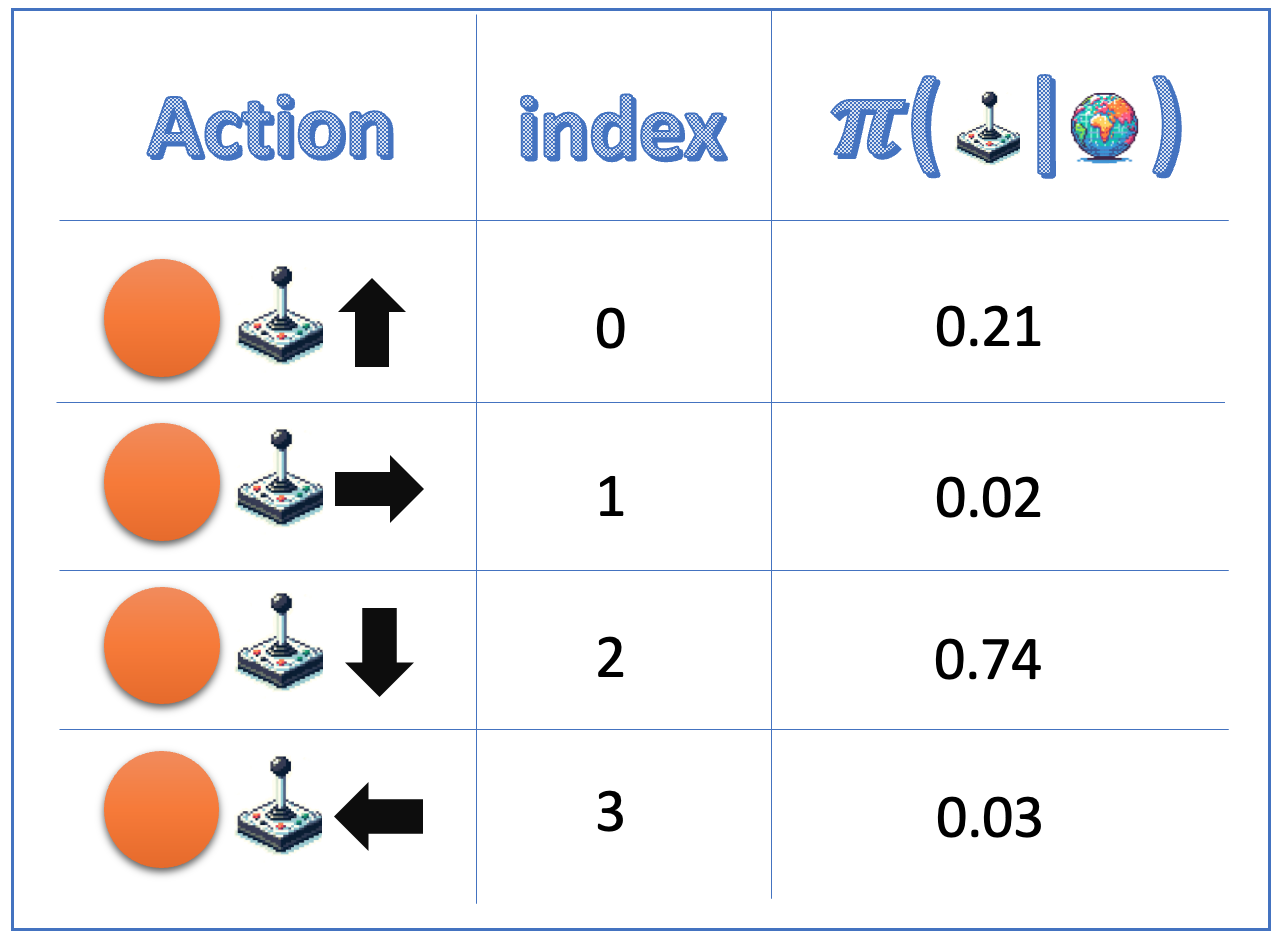
action_probs = policy_network(state) print('Action probabilities:', action_probs)
Action probabilities: tensor([0.21, 0.02, 0.74, 0.03])

一张表:将四个可能动作映射到其索引与概率。动作"up"索引 0、概率 0.21;"right"索引 1、概率 0.02;"down"索引 2、概率 0.74;"left"索引 3、概率 0.03。

action_dist = (
    torch.distributions.Categorical(action_probs))

action = action_dist.sample()
Python 中的深度强化学习

目标函数


  • 策略需最大化期望回报

    • 假设智能体遵循 $\pi_\theta$
    • 通过优化策略参数 $\theta$
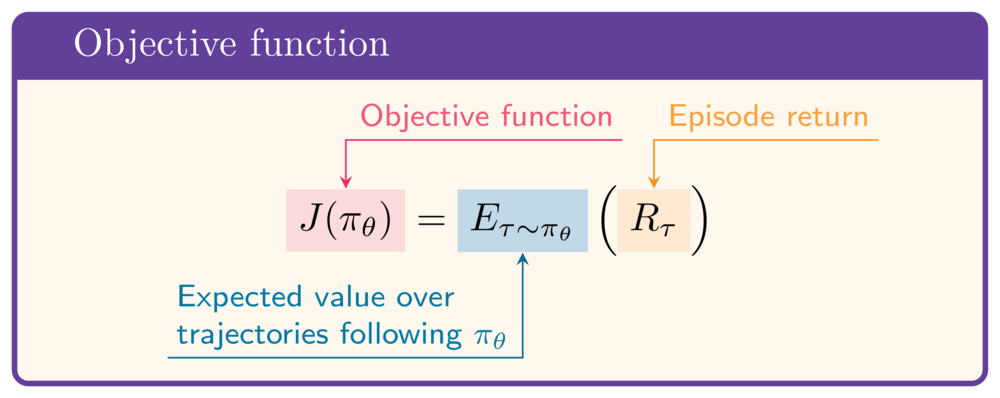
  • 目标函数:

一个等式:J(pi theta) = 对遵循 pi theta 的轨迹 tau 的期望的 R_tau,其中 R_tau 为回合回报


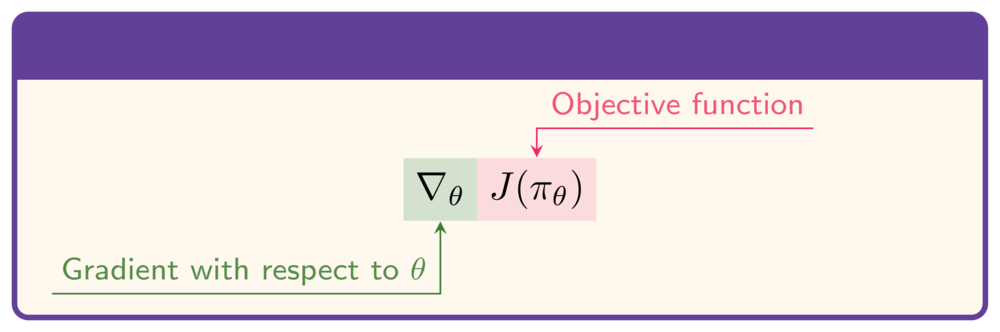
  • 要最大化 $J$:需对 $\theta$ 的梯度:

J(pi_theta) 对 theta 的梯度

Python 中的深度强化学习

目标函数


  • 策略需最大化期望回报

    • 假设智能体遵循 $\pi_\theta$
    • 通过优化策略参数 $\theta$
  • 目标函数:

J(pi theta) 的定义,与上一页相同


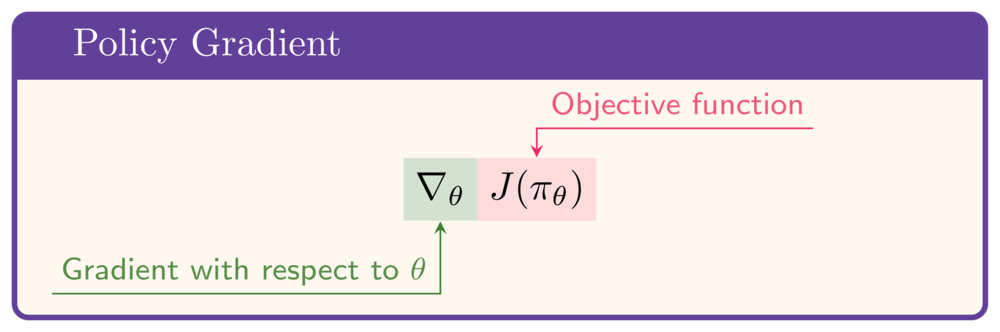
  • 要最大化 $J$:需对 $\theta$ 的梯度:

J(pi_theta) 对 theta 的梯度称为策略梯度

Python 中的深度强化学习

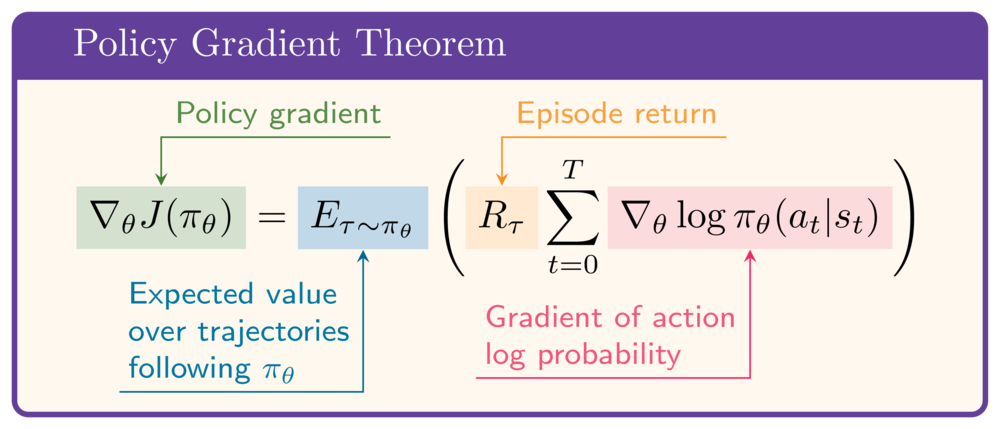
策略梯度定理


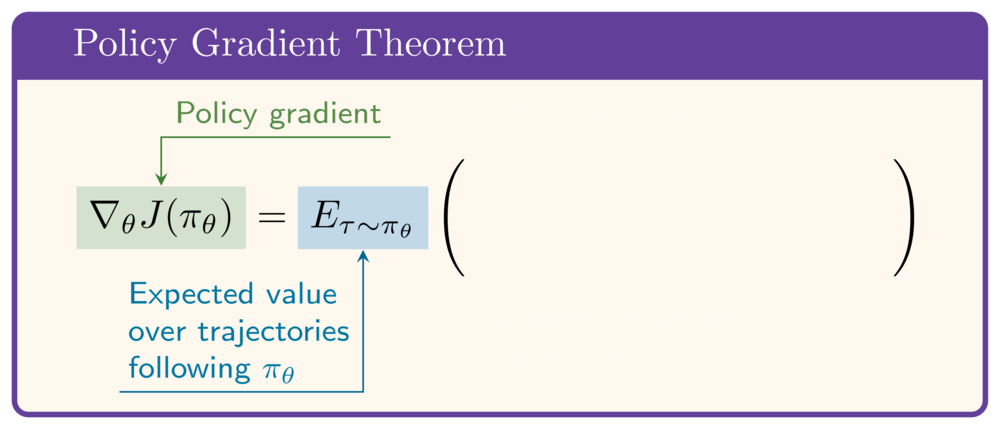
  • 给出 $\nabla_\theta J(\pi_\theta)$ 的可求表达式
  • 对遵循 $\pi_\theta$ 的轨迹取期望
    • 收集轨迹并观察回报


策略梯度定理:J(pi_theta) 对 theta 的梯度等于对遵循 pi_theta 的轨迹 tau 的期望……

Python 中的深度强化学习

策略梯度定理


  • 给出 $\nabla_\theta J(\pi_\theta)$ 的可求表达式
  • 对遵循 $\pi_\theta$ 的轨迹取期望
    • 收集轨迹并观察回报
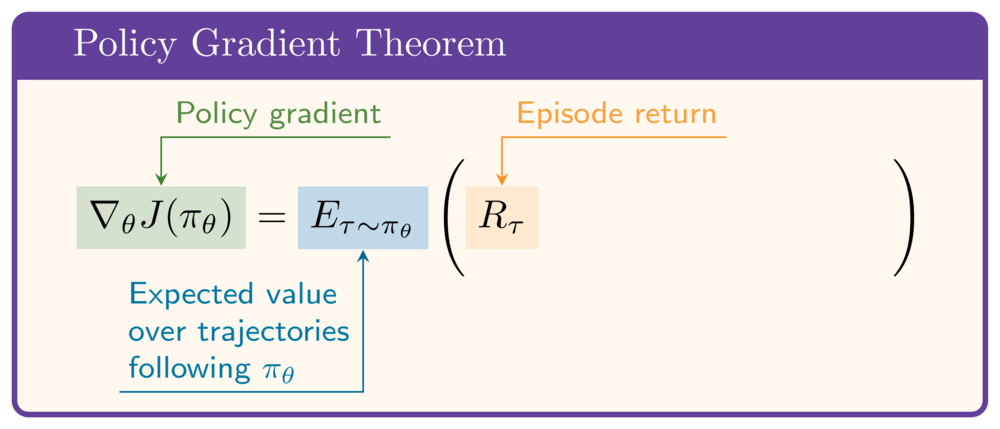
  • 对每条轨迹:考虑回报 $R_\tau$


策略梯度定理:J(pi_theta) 对 theta 的梯度等于对遵循 pi_theta 的轨迹 tau 的期望,其中包含回合回报乘以……

Python 中的深度强化学习

策略梯度定理


  • 给出 $\nabla_\theta J(\pi_\theta)$ 的可求表达式
  • 对遵循 $\pi_\theta$ 的轨迹取期望
    • 收集轨迹并观察回报
  • 对每条轨迹:考虑回报 $R_\tau$
  • 乘以所选动作对数概率梯度的和
  • 直觉:在"好"回合中,推动 theta 增加已选动作的概率


策略梯度定理:J(pi_theta) 对 theta 的梯度等于对遵循 pi_theta 的轨迹 tau 的期望,其中回合回报乘以轨迹中所有动作的对数概率梯度之和。

Python 中的深度强化学习


一个表示 Pong 游戏的动图

Python 中的深度强化学习

Passons à la pratique !

Python 中的深度强化学习

Preparing Video For Download...