近端策略优化(PPO)

Python 中的深度强化学习

Timothée Carayol

Principal Machine Learning Engineer, Komment

A2C

  • A2C 策略更新:
    • 基于高方差估计
    • 可能幅度大且不稳定
  • 可能损害性能

一辆火星车在崎岖地形上发生事故后报废了

PPO

  • PPO 限制每次策略更新的幅度
  • 提高稳定性

一辆火星车在火星表面顺利行驶

Python 中的深度强化学习

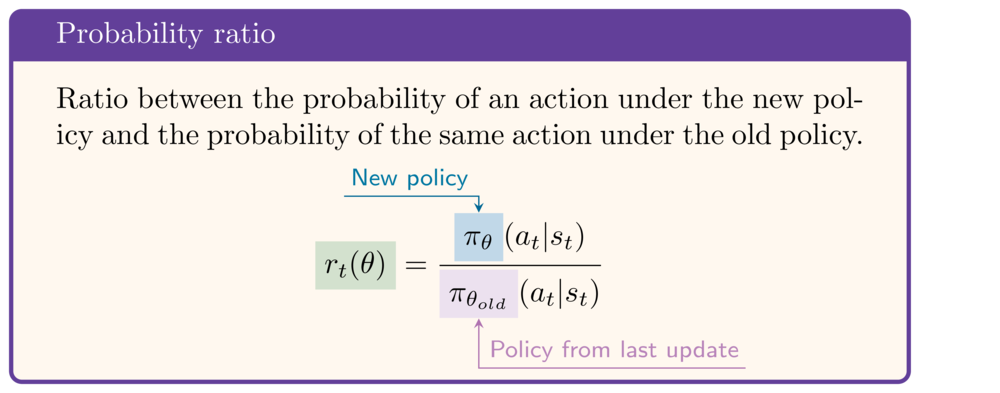
概率比(ratio)

  • PPO 的主要创新:新的目标函数
  • 核心概念:

概率比:新策略下动作概率与旧策略下概率之比,记为 r_t

  • 动作 $a_t$ 在 $\theta$ 下相较 $\theta_{old}$ 有多大概率提升?


  ratio = action_log_prob.exp() / 
          old_action_log_prob.exp().detach()

# 或等价地 ratio = torch.exp(action_log_prob - old_action_log_prob.detach())
  • 对分母使用 detach,防止梯度传播
Python 中的深度强化学习

裁剪概率比


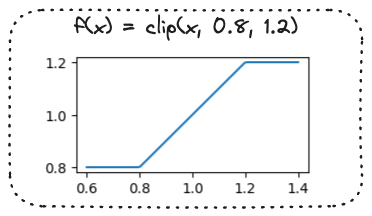
  • 裁剪函数:

clip(x, 0.8, 1.2) 在 x=0.6 到 1.4 的图;x<0.8 为 0.8;0.8 到 1.2 为 x;x>1.2 为 1.2。

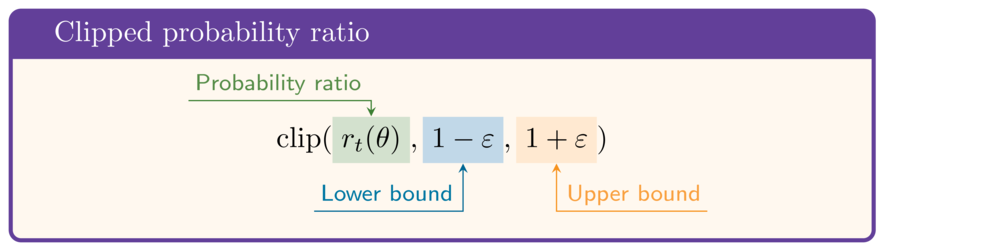
裁剪后的概率比为 clip(r_t, 1-epsilon, 1+epsilon)


clipped_ratio = torch.clamp(ratio,
                            1-epsilon, 
                            1+epsilon)
Python 中的深度强化学习

calculate_ratios 函数


def calculate_ratios(action_log_prob, action_log_prob_old, epsilon):

prob = action_log_prob.exp() prob_old = action_log_prob_old.exp() prob_old_detached = prob_old.detach() ratio = prob / prob_old_detached clipped_ratio = torch.clamp(ratio, 1-epsilon, 1+epsilon)
return (ratio, clipped_ratio)
示例:epsilon = .2:

比率:tensor(1.25)
裁剪后比率:tensor(1.20)
Python 中的深度强化学习

PPO 目标函数


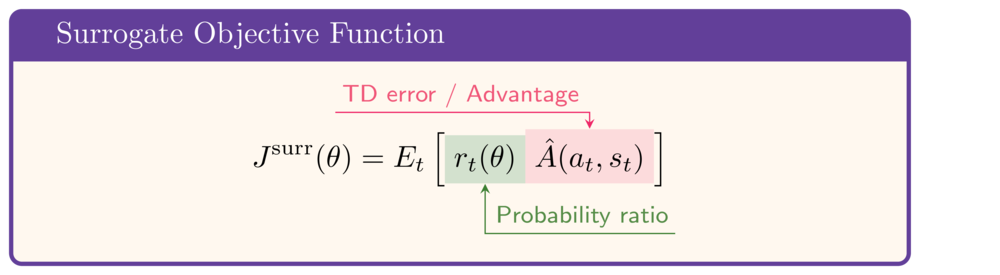
J surr = E_t(r_t * advantage)

surr1 = ratio * td_error.detach()

surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)


  • 使用裁剪比率的替代目标:

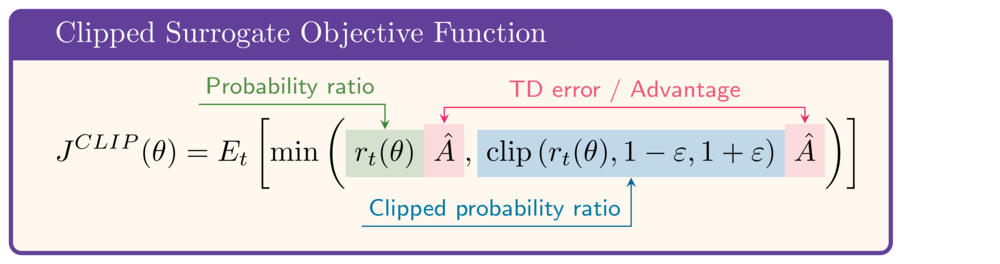
$$\mathrm{clip}(r_t(\theta),1-\varepsilon,1+\varepsilon)\hat{A}$$

  • PPO 裁剪替代目标函数:

裁剪替代目标函数:ratio * advantage 与 clipped ratio * advantage 的最小值的期望。

  • 比 A2C 更稳定
Python 中的深度强化学习

PPO 损失计算


def calculate_losses(critic_network, 
                     action_log_prob,                                        
                     action_log_prob_old,
                     reward, state, next_state,
                     done
                     ):

    # 计算 TD 误差(与 A2C 相同)
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + 
                 gamma * next_value * (1-done))
    td_error = td_target - value
    ...


    ...
    ratio, clipped_ratio = 
            calculate_ratios(action_log_prob, 
                             action_log_prob_old,
                             epsilon)

surr1 = ratio * td_error.detach()
surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)
actor_loss = -objective
critic_loss = td_error ** 2 return actor_loss, critic_loss
Python 中的深度强化学习

Passons à la pratique !

Python 中的深度强化学习

Preparing Video For Download...