基于社交网络的推断

R 中的欺诈检测

Tim Verdonck

Professor Data Science at KU Leuven

基于社交网络的推断
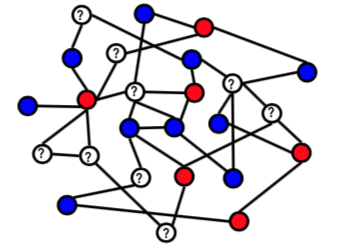
目标

基于其他节点的行为预测某节点的行为

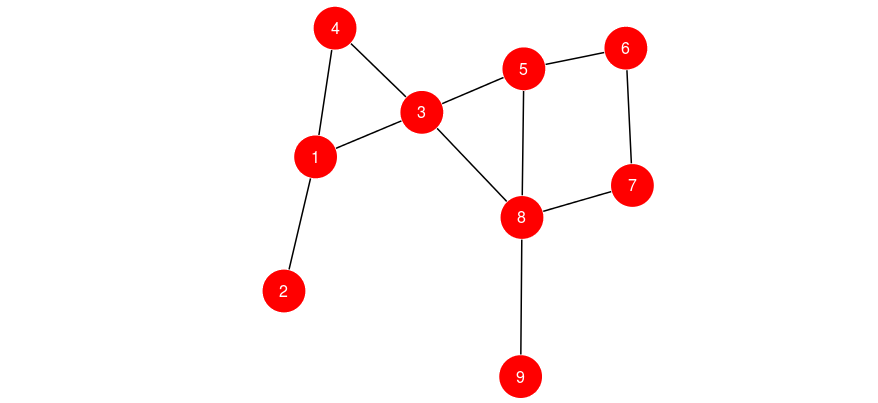
网络中的缺失节点

R 中的欺诈检测

基于社交网络的推断

挑战

  • 数据并非独立
    • 一个节点的行为可能影响其他节点
    • 节点间行为相关
  • 集体推断:对节点的推断会相互影响

网络中的缺失节点

R 中的欺诈检测

非关系 vs 关系

非关系模型

  • 仅用局部信息
  • 逻辑回归、决策树等

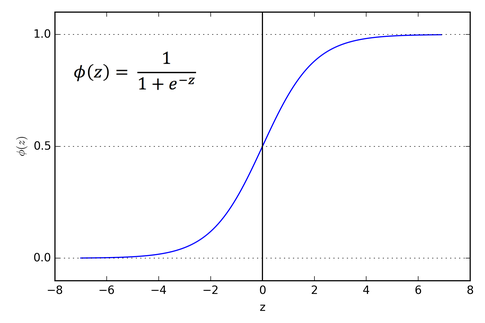
逻辑回归

关系模型

  • 利用网络中的链接
  • 关系型邻居分类器

简单网络

R 中的欺诈检测

关系型邻居分类器

假设

  • 同质性:相连节点倾向于属于同一类别("以邻为伍")
  • 已知部分类别标签

缺失节点

R 中的欺诈检测

关系型邻居分类器

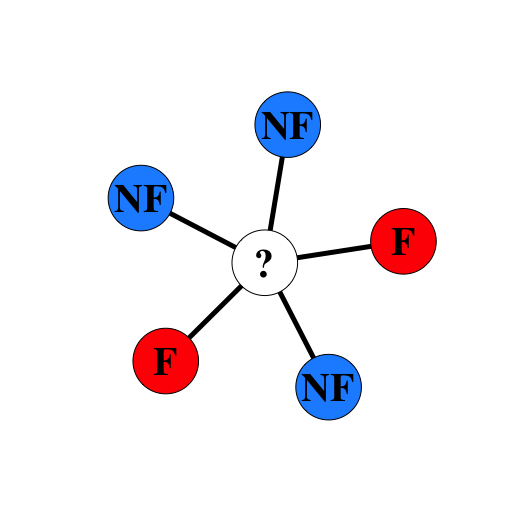
欺诈概率

$$P(F | ?) = \frac{1 + 1}{1 + 1 + 1 + 1 + 1}=\frac{2}{5}= 40\%$$

缺失节点

R 中的欺诈检测

带权的关系型邻居分类器

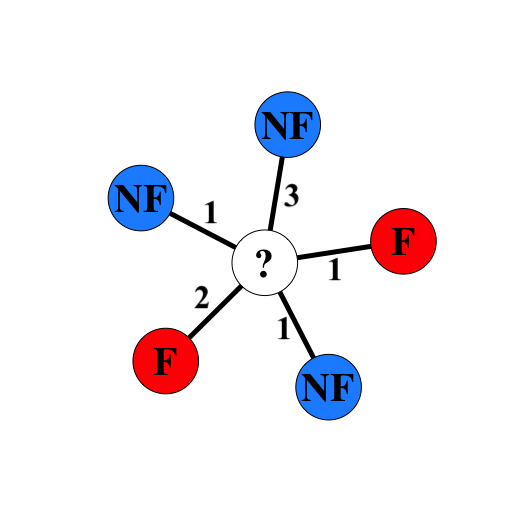
欺诈概率

$$P(F | ?) = \frac{1 + 2}{3 + 1 + 1 + 2 + 1}=\frac{3}{8}=37.5\%$$

带权缺失节点

R 中的欺诈检测

关系型邻居分类器

vertex_attr(network) ## 节点标签:1(欺诈)、0(非欺诈)、NA(未知)
$name
"?" "B" "C" "D" "E" "A"
$isFraud
NA  1  0  1  0  0
edge_attr(network) ## 边具有权重

$weight
2 3 1 1 1
R 中的欺诈检测

关系型邻居分类器

## subgraph(): 创建仅含节点"?"及所有欺诈节点的子图
subnetwork <- subgraph(network, v = c("?", "B", "D"))

## strength(): 汇总节点"?"相邻边的权重 prob_fraud <- strength(subnetwork, v = "?") / strength(network, v = "?")
prob_fraud
0.375
R 中的欺诈检测

¡Vamos a practicar!

R 中的欺诈检测

Preparing Video For Download...