R 中的欺诈检测
Bart Baesens
Professor Data Science at KU Leuven
head(creditcard)
  Time         V1         V2  ...            V27         V28 Amount Class
1    0  1.1918571  0.2661507  ...  -0.0089830991  0.01472417   2.69     0
2   10  0.3849782  0.6161095  ...   0.0424724419 -0.05433739   9.99     0
3   12 -0.7524170  0.3454854  ...  -0.1809975001  0.12939406  15.99     0
4   17  0.9624961  0.3284610  ...   0.0163706433 -0.01460533  34.09     0
5   34  0.2016859  0.4974832  ...   0.1427572469  0.21923761   9.99     0
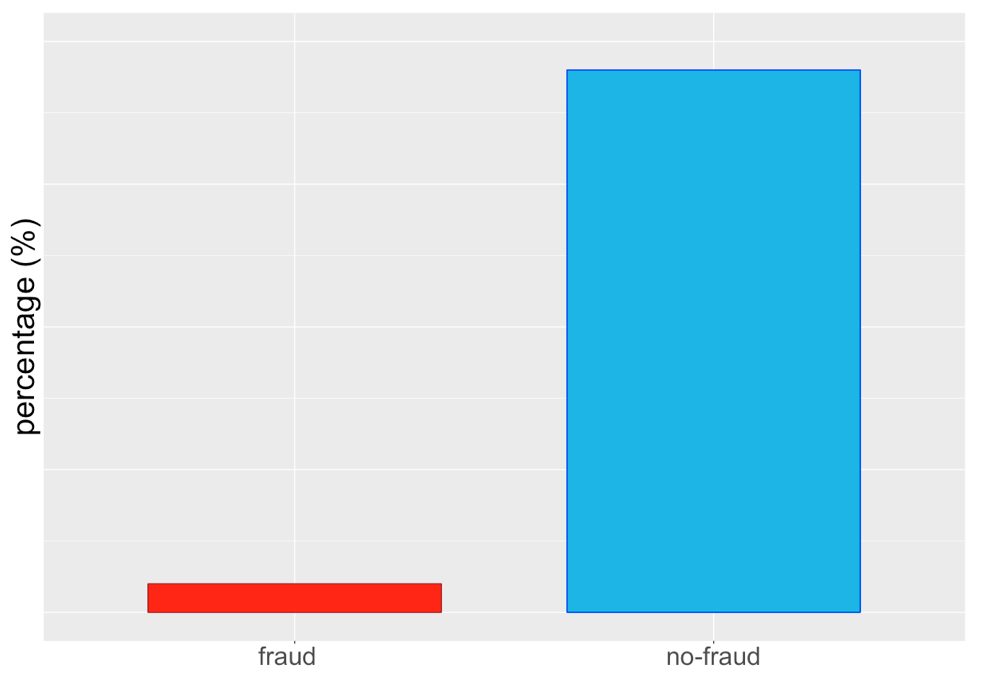
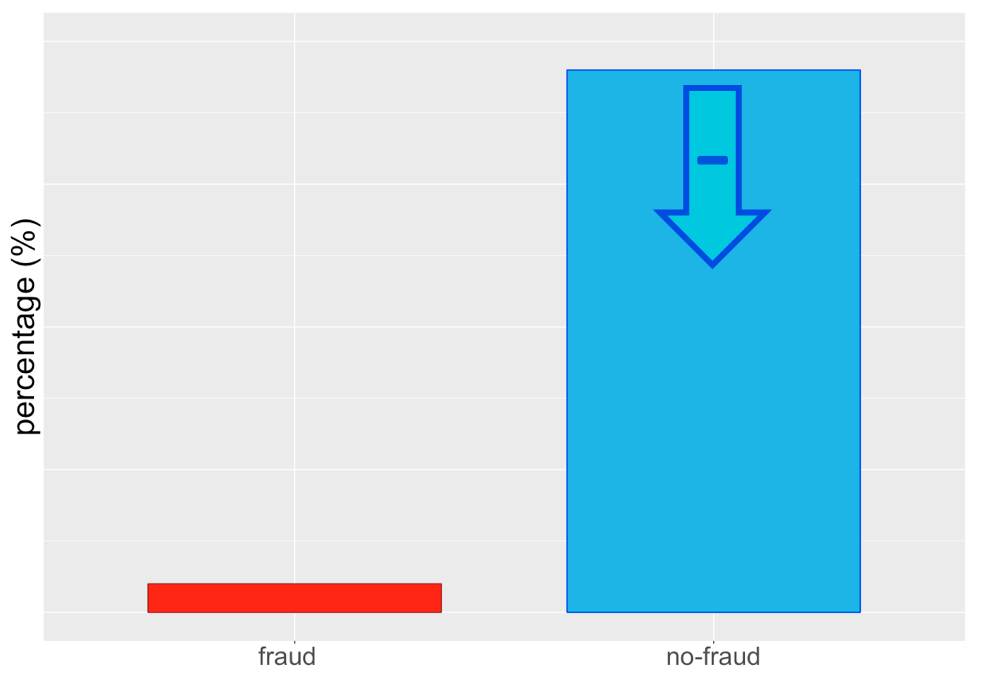
prop.table(table(creditcard$Class))
   0    1
0.98 0.02
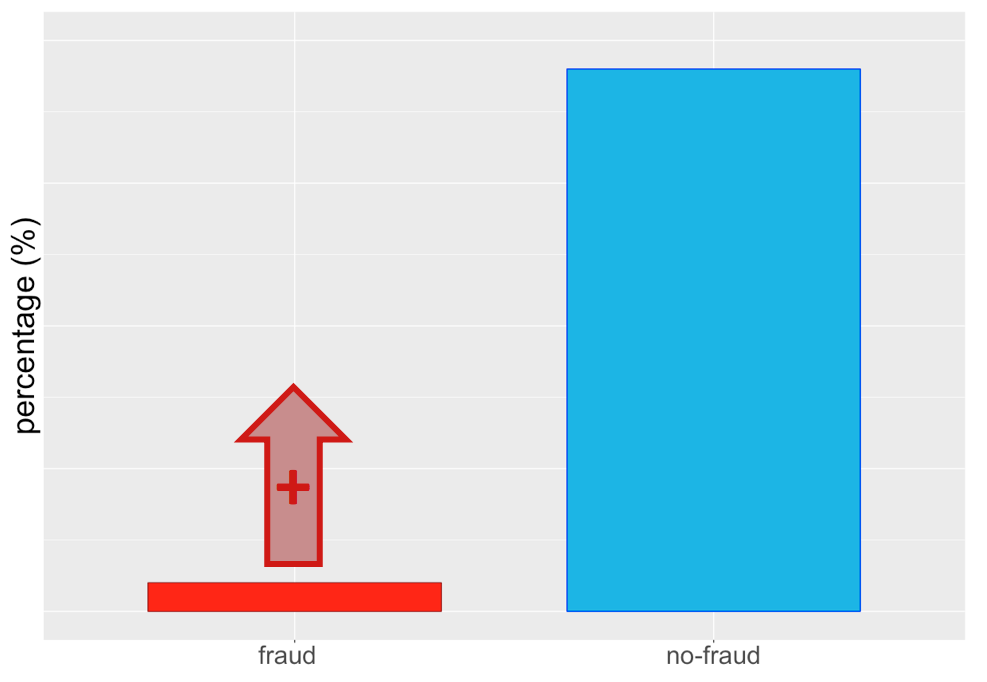
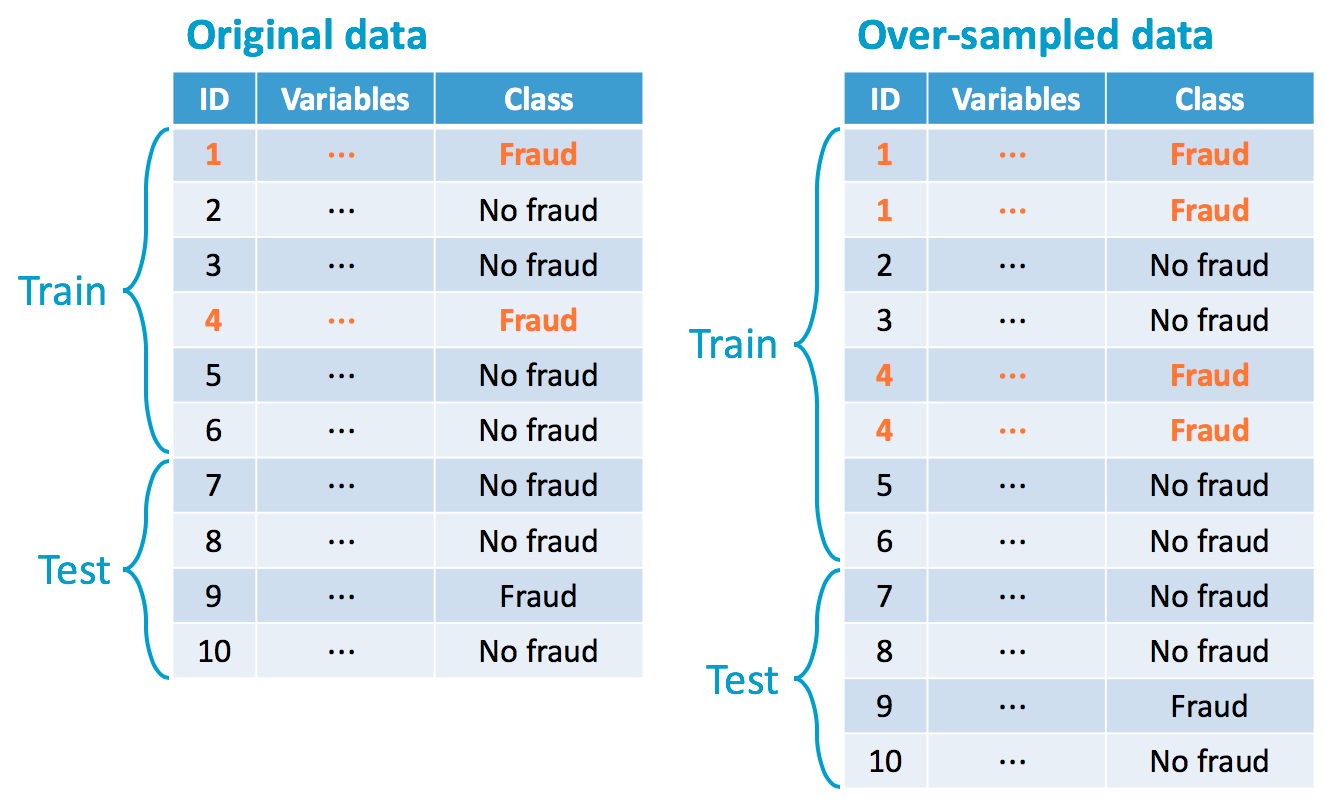
n_legit <- 24108
new_frac_legit <- 0.50
new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216

library(ROSE)
oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard,
                                   method = "over",
                                   N = new_n_total,
                                   seed = 2018)

oversampled_credit <- oversampling_result$data
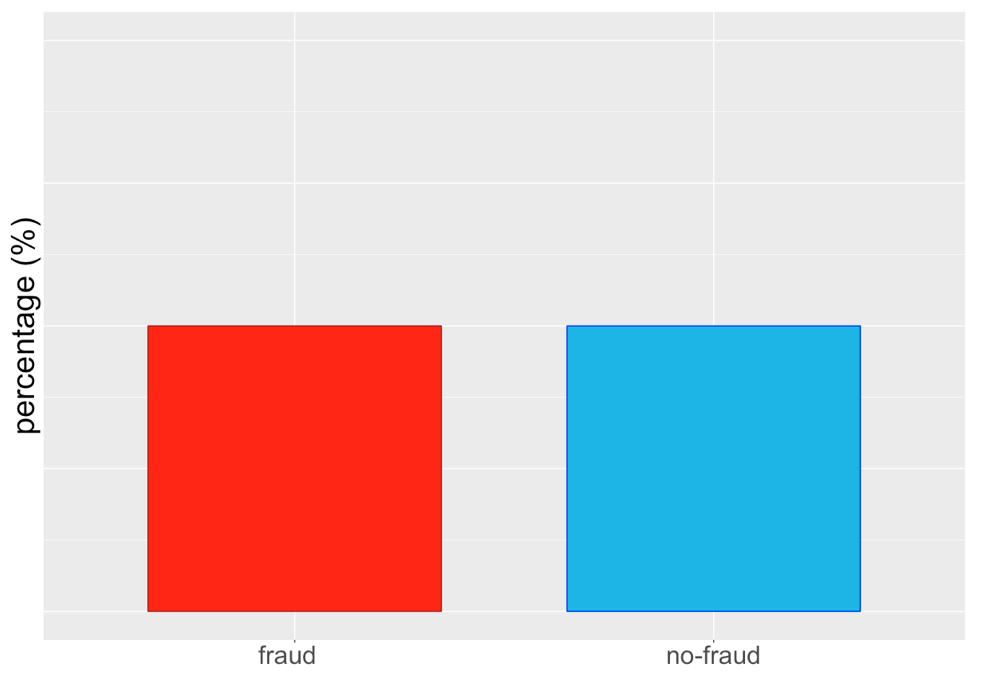
prop.table(table(oversampled_credit$Class))
n_legit <- 24108 new_frac_legit <- 0.50 new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216
library(ROSE) oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard, method = "over", N = new_n_total, seed = 2018)
oversampled_credit <- oversampling_result$data prop.table(table(oversampled_credit$Class))
  0   1
0.5 0.5