Dask DataFrame
Python 中的 Dask 并行编程

James Fulton
Climate Informatics Researcher
pandas 与 Dask DataFrame 对比
import pandas as pd# 读取单个 CSV 文件 pandas_df = pd.read_csv( "dataset/chunk1.csv" )
这会立即读取一个 CSV 文件。
import dask.dataframe as dd# 延迟读取全部 CSV 文件 dask_df = dd.read_csv( "dataset/*.csv" )
这会延迟读取 dataset 文件夹中的所有 CSV。
Dask DataFrame
print(dask_df)
Dask DataFrame 结构:
              ID     col1     col2    col3     col4     ...
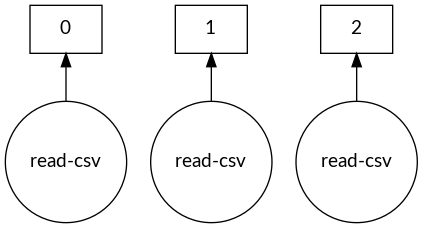
npartitions=3
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 3 tasks
Dask DataFrame 任务图
dask.visualize(dask_df)
控制块大小
# Set the maximum memory of a chunk dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")print(dask_df)
Dask DataFrame 结构:
              ID     col1     col2    col3     col4     ...
npartitions=7
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 7 tasks
分区说明
# Set the maximum memory of a chunk
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
为什么是 7 个分区?
size      file
  9M      dataset/chunk1.csv
 18M      dataset/chunk2.csv
 32M      dataset/chunk3.csv
分区说明
# Set the maximum memory of a chunk
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
为什么是 7 个分区?
size      file
  9M      dataset/chunk1.csv    # 变为 1 个分区
 18M      dataset/chunk2.csv    # 变为 2 个分区
 32M      dataset/chunk3.csv    # 变为 4 个分区
用 Dask DataFrame 做分析
- 选择列
col1 = dask_df['col1'] - 赋值新列
dask_df['double_col1'] = 2 * col1 - 数学运算,如:
dask_df.std()
dask_df.min()
- 分组聚合
dask_df.groupby(col1).mean() - 还可用之前的函数
dask_df.nlargest(n=3, columns='col1')
日期时间与其他 pandas 功能
import pandas as pd # 将字符串转为 datetime pd.to_datetime(pandas_df['start_date'])# 访问 datetime 属性 pandas_df['start_date'].dt.year pandas_df['start_date'].dt.day pandas_df['start_date'].dt.hour pandas_df['start_date'].dt.minute
import dask.dataframe as dd # 将字符串转为 datetime dd.to_datetime(dask_df['start_date'])# 访问 datetime 属性 dask_df['start_date'].dt.year dask_df['start_date'].dt.day dask_df['start_date'].dt.hour dask_df['start_date'].dt.minute
将结果变为非惰性
# 显示 5 行
print(dask_df.head())
        ID     double_col1     col1    col2     col3     ...
0   543795              20       10     436        0     ...
1   874535              24       12     268        0     ...
2   781326              62       31     211        0     ...
3   112457              18        9     898        1     ...
4   103256             142       71     663        0     ...
# 将惰性 Dask DataFrame 转为内存中的 pandas DataFrame
results_df = df.compute()
直接将结果写入文件
# 7 个分区(块),因此生成 7 个输出文件
dask_df.to_csv('answer/part-*.csv')
part-0.csv
part-1.csv
part-2.csv
part-3.csv
part-4.csv
part-5.csv
part-6.csv
更快的文件格式:Parquet
# 从 Parquet 读取
dask_df = dd.read_parquet('dataset_parquet')

# 保存为 Parquet
dask_df.to_parquet('answer_parquet')
- Parquet 读取速度比 CSV 快数倍
- 写入也可能更快
Vamos praticar!
Python 中的 Dask 并行编程

