在 R 中使用 limma 进行差异表达分析
John Blischak
Instructor
x_sub <- x[1000, 1:10]
f_sub <- f[1000, ]
p_sub <- p[1:10, ]
一个逗号放错位置,可能让调试变成噩梦:
x_sub <- x[1000, 1:10]
f_sub <- f[1000, ]
p_sub <- p[, 1:10]
# Oh no! *
class(类)- 定义承载复杂数据的结构
object(对象)- 类的具体实例
methods(方法)- 作用于特定类的函数
install.packages("BiocManager")
BiocManager::install("Biobase")
# 载入包 library(Biobase) # 创建 ExpressionSet 对象 eset <- ExpressionSet(assayData = x, phenoData = AnnotatedDataFrame(p), featureData = AnnotatedDataFrame(f))# 查看特征(行)和样本(列)数量 dim(eset)
Features Samples
22283 344
?ExpressionSet
表达矩阵
x <- exprs(eset)
特征数据
f <- fData(eset)
表型数据
p <- pData(eset)
x_sub <- x[1000, 1:10]
f_sub <- f[1000, ]
p_sub <- p[1:10, ]
eset_sub <- eset[1000, 1:10]
nrow(exprs(eset_sub)) == nrow(fData(eset_sub))
TRUE
ncol(exprs(eset_sub)) == nrow(pData(eset_sub))
TRUE
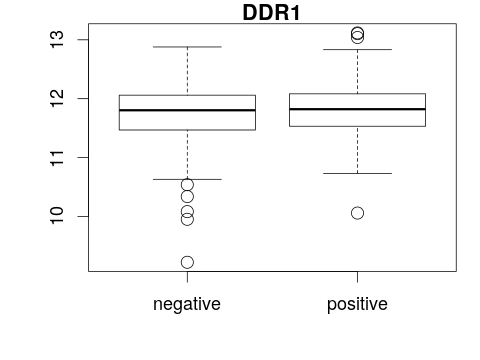
boxplot(<y-axis> ~ <x-axis>, main = "<title>") boxplot(<gene expression> ~ <phenotype>, main = "<feature>")boxplot(exprs(eset)[1, ] ~ pData(eset)[, "er"], main = fData(eset)[1, "symbol"])
在 R 中使用 limma 进行差异表达分析