Ingineria și selecția caracteristicilor

Machine Learning End-to-End

Joshua Stapleton

Machine Learning Engineer

Ingineria caracteristicilor
Crearea caracteristicilor

  • Simplifică problema
  • Îmbunătățește eficiența modelului

Tehnici

  • Modificarea caracteristicilor existente
  • Proiectarea de caracteristici noi

Beneficii

  • Implementare, mentenanță și antrenare mai ușoare
  • Interpretabilitate crescută

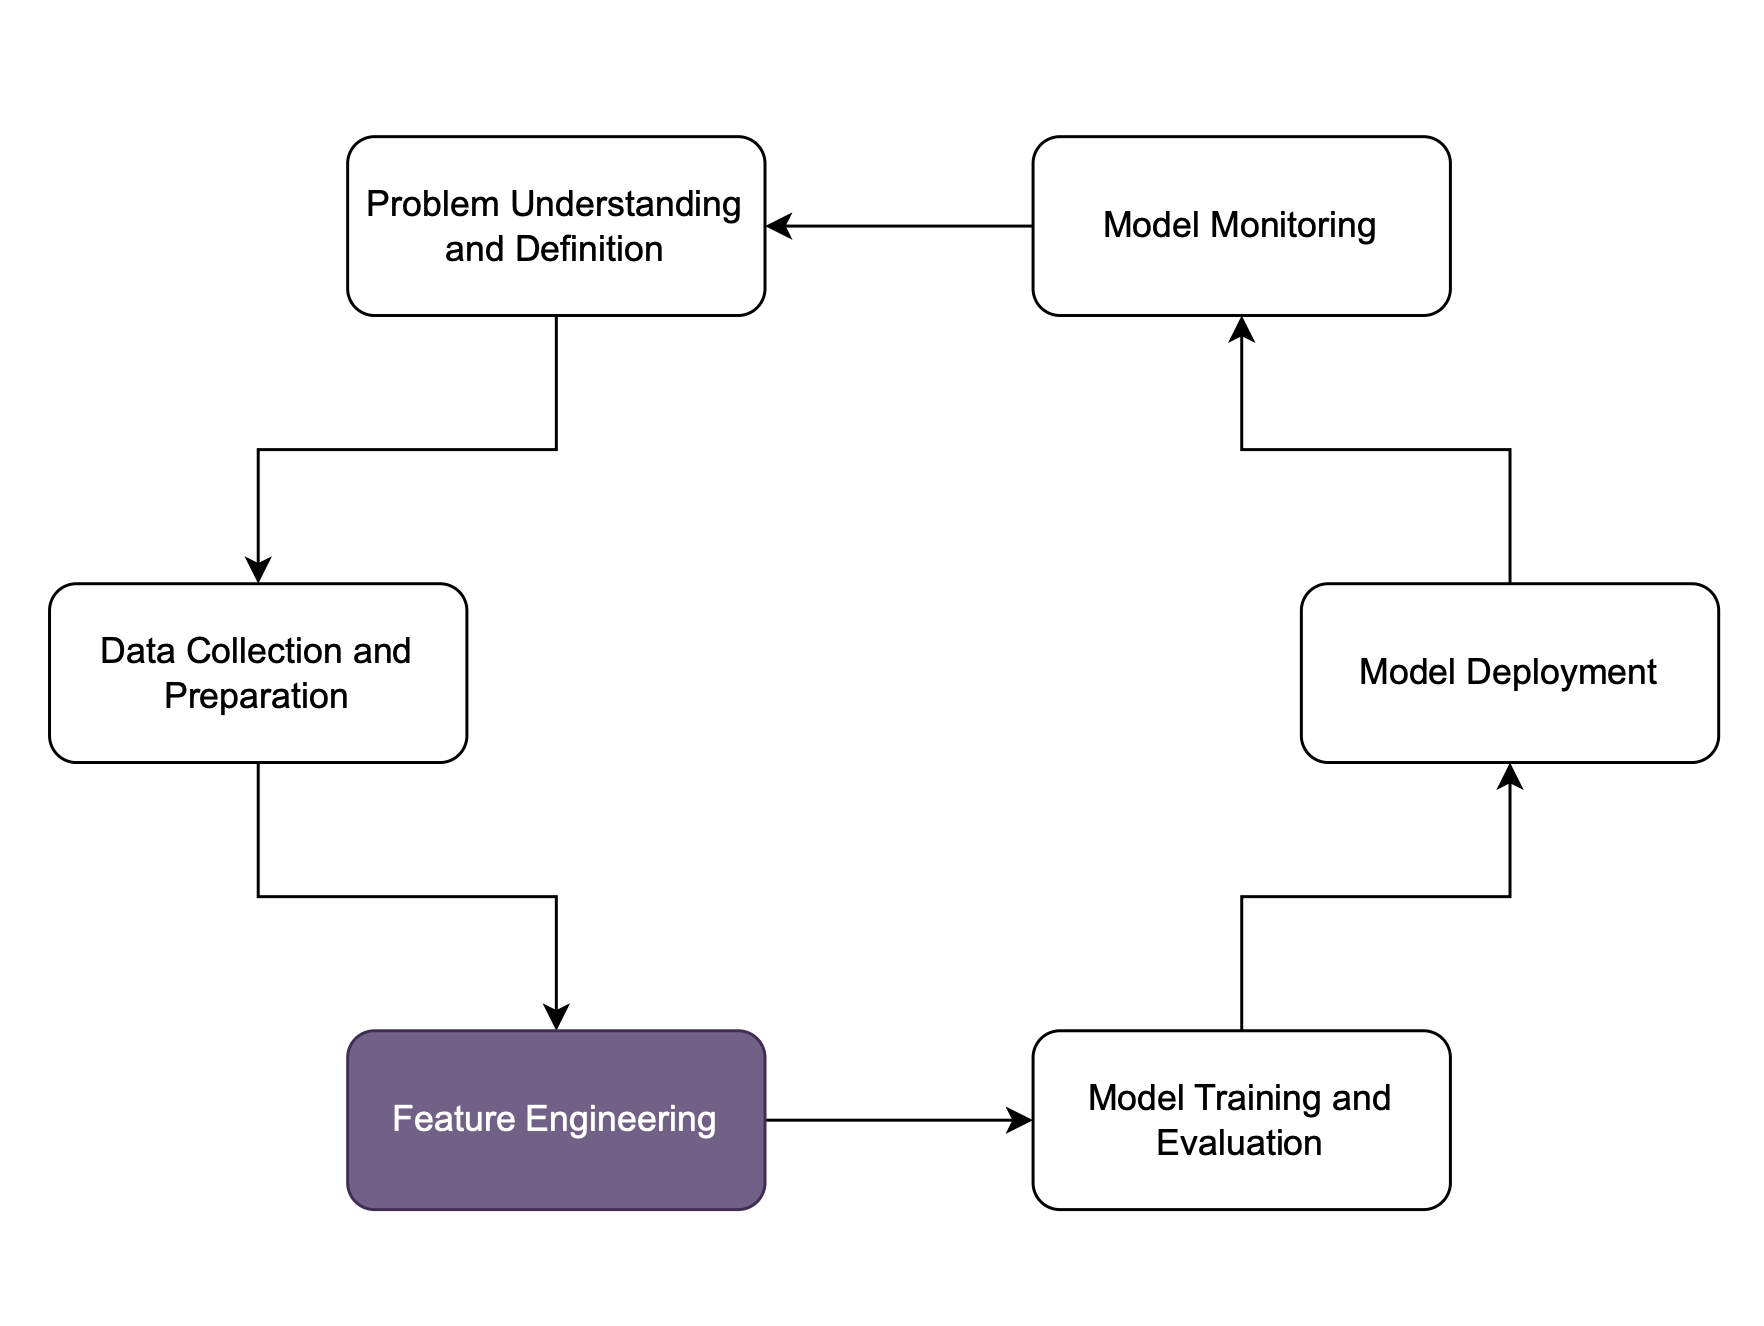
Etapa curentă a ciclului de viață ML: ingineria caracteristicilor

Machine Learning End-to-End

Normalizare

  • Scalează caracteristicile numerice la [0, 1]
  • Util când caracteristicile au scale/intervale diferite.
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import Normalizer

# Split the data
X_train, X_test = train_test_split(df, test_size=0.2, random_state=42)
# Createnormalizer object, fit on training data, normalize, and transform test set
norm = Normalizer()
X_train_norm = norm.fit_transform(X_train)
X_test_norm = norm.transform(X_test)
Machine Learning End-to-End

Standardizare

  • Scalează datele cu medie = 0, varianță = 1
  • Benefic pentru algoritmii care presupun medie și varianță similare
from sklearn.preprocessing import StandardScaler

# Split the data
X_train, X_test = train_test_split(df, test_size=0.2, random_state=42)
# Create a scaler object and fit training data to standardize it
sc = StandardScaler()
X_train_stzd = sc.fit_transform(X_train)
# Only standardize the test data
X_test_stzd = sc.transform(X_test)
Machine Learning End-to-End

Ce face o caracteristică bună?

  • Utilizați caracteristici relevante
  • Vremea din ziua programării pacientului nu ar trebui să influențeze diagnosticul
 

Imagine cu vreme furtunoasă ilustrând principiul relevanței în selecția caracteristicilor

  • Utilizați caracteristici disimilare (ortogonale)
  • Două caracteristici reprezentând vârsta în luni și în ani nu ar fi utile
 

Diagramă ilustrând principiul ortogonalității în selecția caracteristicilor

Machine Learning End-to-End

sklearn.feature_selection


from sklearn.ensemble import RandomForestClassifier
from sklearn.feature_selection import SelectFromModel
from sklearn.model_selection import train_test_split

# Splitting data into train and test subsets first to avoid data leakage X_train, X_test, y_train, y_test = train_test_split( heart_disease_df_X, heart_disease_df_y, test_size=0.2, random_state=42)
Machine Learning End-to-End

sklearn.feature_selection (cont.)


# Define and fit the random forest model
rf = RandomForestClassifier(n_jobs=-1, class_weight='balanced', max_depth=5)
rf.fit(X_train, y_train)

# Define and run feature selection model = SelectFromModel(rf, prefit=True) features_bool = model.get_support() features = heart_disease_df.columns[features_bool]
Machine Learning End-to-End

Să exersăm!

Machine Learning End-to-End

Preparing Video For Download...